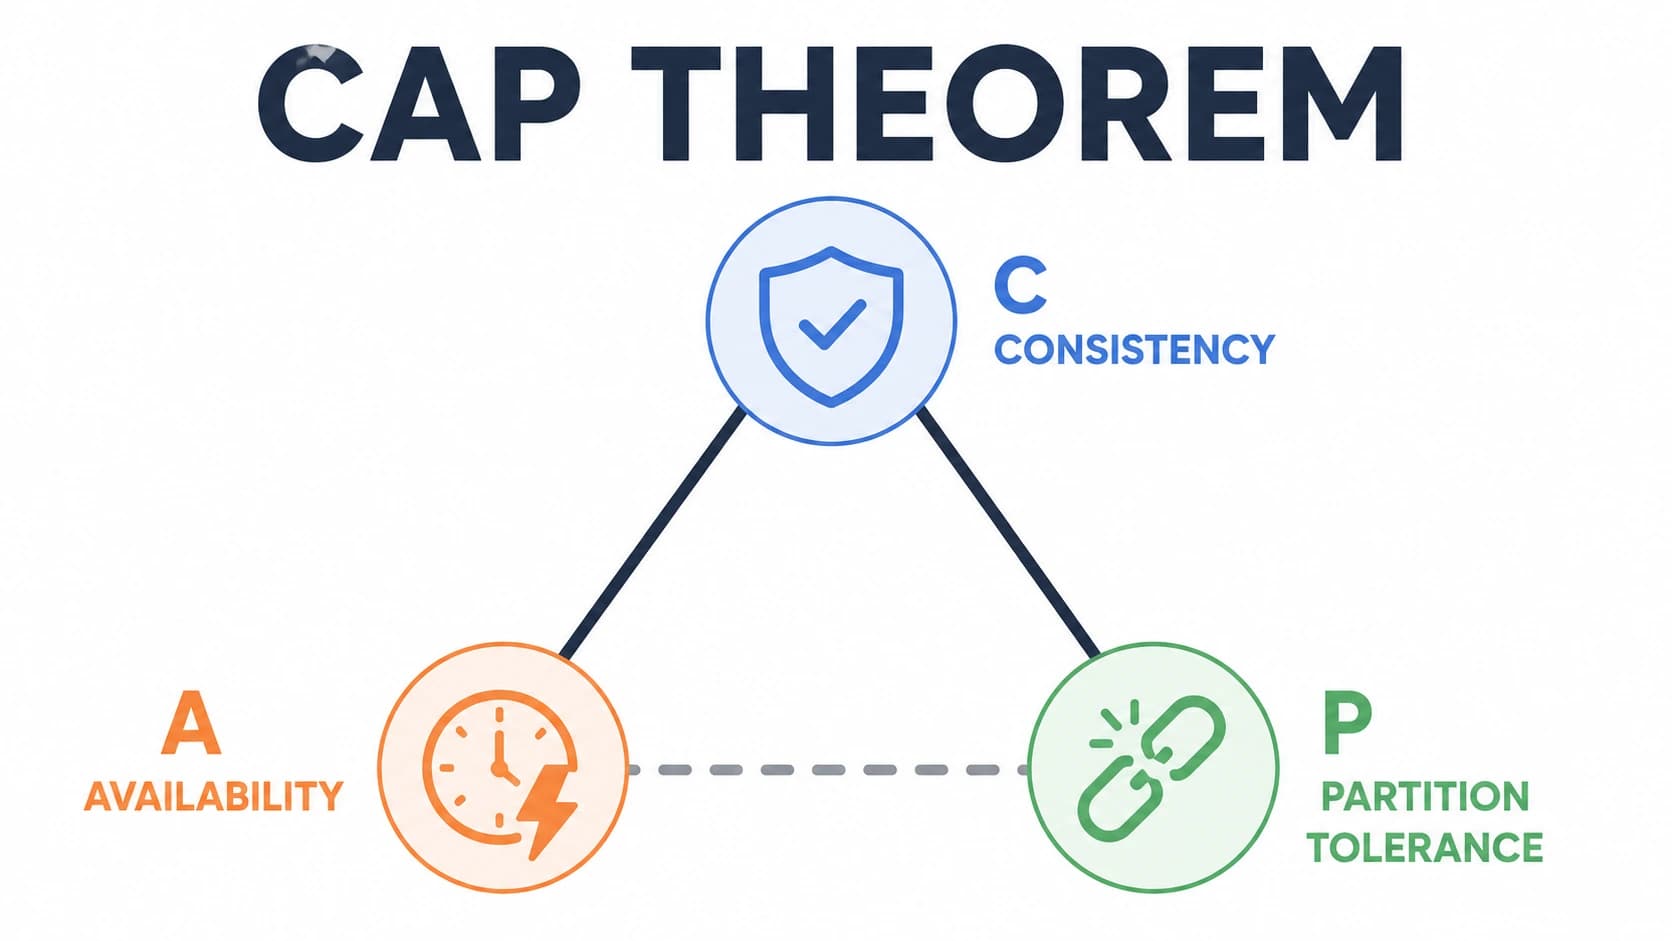
قضیهی CAP (که اریک برور اولین بار مطرحش کرد) میگه یه سیستم دیتابیس توزیعشده، وقتی network partition اتفاق میافته (یعنی ارتباط بین بخشی از node ها قطع میشه)، فقط میتونه یکی از این دو تا رو تضمین کنه، نه هر دو رو با هم:
Consistency: هر خواندنی، آخرین نوشتهی موفق رو برمیگردونه. یعنی همهی node ها همیشه یه نسخهی یکسان و بهروز از داده رو نشون میدن.
Availability: هر درخواستی (چه خواندن، چه نوشتن) یه جواب دریافت میکنه، حتی اگه بعضی node ها از کار افتاده باشن. سیستم هیچوقت با یه خطا جواب رد نمیده.
ضلع سومِ قضیه، Partition tolerance است: توانایی سیستم برای ادامهی کار حتی وقتی شبکه بین node ها قطع میشه. نکتهی مهم اینجاست که partition tolerance تو دنیای واقعی یه انتخاب نیست؛ شبکه دیر یا زود قطع میشه، پس هر سیستم توزیعشدهی واقعی باید partition tolerant باشه. این یعنی انتخاب واقعی همیشه بین C و A است، نه بین سهتا گزینه.
یعنی چی وقتی partition اتفاق میافته؟
فرض کن یه کلاستر سهnode ای داری و ارتباط شبکه بین node یک با node های دو و سه قطع میشه. حالا دو گروه جدا از هم داری. وقتی یه کلاینت به node یک درخواست نوشتن میفرسته، دو مسیر پیش رو داری:
اگه سیستم انتخاب کنه Consistency رو حفظ کنه (CP)، node یک باید درخواست رو رد کنه یا صبر کنه، چون نمیتونه مطمئن بشه node های دیگه هم همین مقدار رو دارن. کاربر یه خطا میگیره، ولی داده هیچوقت inconsistent نمیشه.
اگه سیستم انتخاب کنه Availability رو حفظ کنه (AP)، node یک همون لحظه به کاربر جواب میده و نوشتن رو قبول میکنه، حتی اگه ندونه node های دیگه چه مقداری دارن. بعداً وقتی partition برطرف شد، سیستم باید یه مکانیزم برای reconcile کردن این تناقضها داشته باشه (مثلاً last-write-wins یا vector clocks).
چند تا مثال واقعی
MongoDB بهصورت پیشفرض بیشتر به سمت CP گرایش داره؛ وقتی primary node در دسترس نباشه یا اکثریت replica ها قابلدسترس نباشن، نوشتنها متوقف میشن تا consistency حفظ بشه.
Cassandra طراحیش از پایه AP-محور بوده؛ همیشه به درخواستها جواب میده، حتی اگه بعضی replica ها هنوز بهروز نشده باشن، و از مدل eventual consistency استفاده میکنه.
CockroachDB و Google Spanner سعی میکنن با استفاده از الگوریتمهای consensus مثل Raft یا Paxos، در اکثر شرایط هر دو رو تا حد ممکن نزدیک هم نگه دارن، ولی باز هم زیر پوستشون، وقتی واقعاً partition جدی اتفاق بیفته، اولویت رو به consistency میدن.
چرا این مدل سادهشده هم کامل نیست
یه نقد رایج به CAP اینه که این مدل بیشازحد سادهست، چون partition ها همیشه یا کامل هستن یا اصلاً نیستن، در حالی که تو دنیای واقعی شبکه معمولاً بهجای قطع کامل، فقط کند میشه یا packet loss داره. برای همین، یه فریمورک تکمیلی به اسم PACELC مطرح شده که میگه: در حالت Partition، بین Availability و Consistency انتخاب کن (همون CAP)، ولی حتی وقتی partition نداری (Else)، بین Latency و Consistency هم باید یه مصالحه انجام بدی. یعنی حتی تو حالت عادی شبکه، دیتابیسهایی مثل Cassandra ترجیح میدن latency پایینتری بدن به قیمت consistency ضعیفتر، در حالی که چیزی مثل Spanner حاضره latency بیشتری رو تحمل کنه تا consistency قویتری داشته باشه.
این یعنی چی برای انتخاب دیتابیس
وقتی داری معماری یه سیستم رو طراحی میکنی، سؤال درست این نیست که «کدوم دیتابیس بهتره؟»، بلکه اینه که «سیستمم چه چیزی رو نمیتونه تحمل کنه؟» برای یه سیستم بانکی که موجودی حساب رو مدیریت میکنه، نشون دادن یه مقدار قدیمی یا اشتباه فاجعهباره؛ پس CP منطقیتره، حتی اگه یعنی بعضی وقتها کاربر با تأخیر مواجه بشه. ولی برای چیزی مثل تعداد لایک یه پست تو شبکهی اجتماعی، اگه چند ثانیه یه عدد قدیمیتر نشون داده بشه هیچ فاجعهای اتفاق نمیافته، ولی اگه کل سایت پایین بیاد چون یه node قطع شده، تجربهی کاربری خیلی بدتری رقم میخوره. اینجا AP انتخاب درستتریه.
نکتهی آخر اینکه CAP فقط دربارهی رفتار سیستم زیر partition حرف میزنه، نه دربارهی performance عمومی یا مقیاسپذیری. یه دیتابیس میتونه CP باشه و همچنان خیلی سریع و مقیاسپذیر باشه؛ این دو مفهوم کاملاً مستقل از هم هستن و نباید با هم قاطی بشن.
مهمه که این رو از شاردینگ جدا کنی. توی شاردینگ، هر سرور فقط بخشی از داده رو داره. توی ریپلیکیشن، هر سرور (یا حداقل هر replica) یک کپی کامل از کل داده رو نگه میداره. این دو تکنیک هدف متفاوتی دارن و معمولاً با هم ترکیب میشن، نه جایگزین همدیگه.
چرا ریپلیکیشن میخوایم
دو دلیل اصلی برای ریپلیکیشن وجود داره، و هر کدوم مسئلهی متفاوتی رو حل میکنن.
اول، دسترسپذیری بالا (high availability). اگه سرور اصلی (که بهش primary یا master میگن) از کار بیفته، یکی از replica ها میتونه جاش رو بگیره و نقش primary جدید رو بازی کنه، بدون اینکه سرویس کامل قطع بشه. به این فرآیند failover میگن.
دوم، توزیع بار خواندن. توی خیلی از اپلیکیشنها، تعداد خواندن (SELECT) خیلی بیشتر از نوشتن (INSERT/UPDATE) است. اگه همهی این خواندنها روی همون یک سرور primary انجام بشه، اون سرور زیر فشار میمونه. با ریپلیکیشن میتونی خواندنها رو بین چند replica پخش کنی و فقط نوشتنها رو روی primary نگه داری — الگویی که بهش read/write splitting میگن.
چطور داده از primary به replica میرسه
مکانیزم رایج این است که primary هر تغییری که روی دادهاش اعمال میشه رو توی یک لاگ ترتیبی ثبت میکنه — توی PostgreSQL بهش WAL (Write-Ahead Log) میگن، توی MySQL بهش binlog. هر replica این لاگ رو از primary میخونه و همون تغییرات رو دقیقاً به همون ترتیب روی نسخهی خودش اعمال میکنه. یعنی replica عملاً داره یک تاریخچهی کامل از هر اتفاقی که روی primary افتاده رو دنبال میکنه و بازش تولید میکنه.
sync در مقابل async: معاملهای که باید آگاهانه انتخابش کنی
اینجا یکی از مهمترین تصمیمهای طراحی توی ریپلیکیشن پیش میاد: وقتی یک نوشتن روی primary اتفاق میافته، آیا باید صبر کنه تا replica هم همون نوشتن رو تأیید کنه، یا میتونه بدون منتظر موندن به کلاینت جواب «موفق» بده؟
تفاوت کلیدی: حفظ State در برابر ساخت مجدد (Remount)
اصلیترین تفاوت این دو کامپوننت، نحوه رفتار آنها هنگام جابهجایی بین صفحات (Navigation) است:
فایل layout.tsx: هنگام جابهجایی بین routeهای همسطح، ناپدید نمیشود، State خود را حفظ میکند و از اول رندر (Remount) نمیشود.
فایل template.tsx: با هر بار تغییر Route، کامپوننت template بهطور کامل Unmount شده و یک نمونه (Instance) جدید از آن ساخته میشود. این یعنی تمامی Stateها و Effectهای درون آن ریست میشوند.
نکته: هرگاه یک template.tsx در یک پوشه داشته باشید، Next.js آن را دقیقاً به عنوان فرزندِ Layout و والدِ Page رندر میکند:
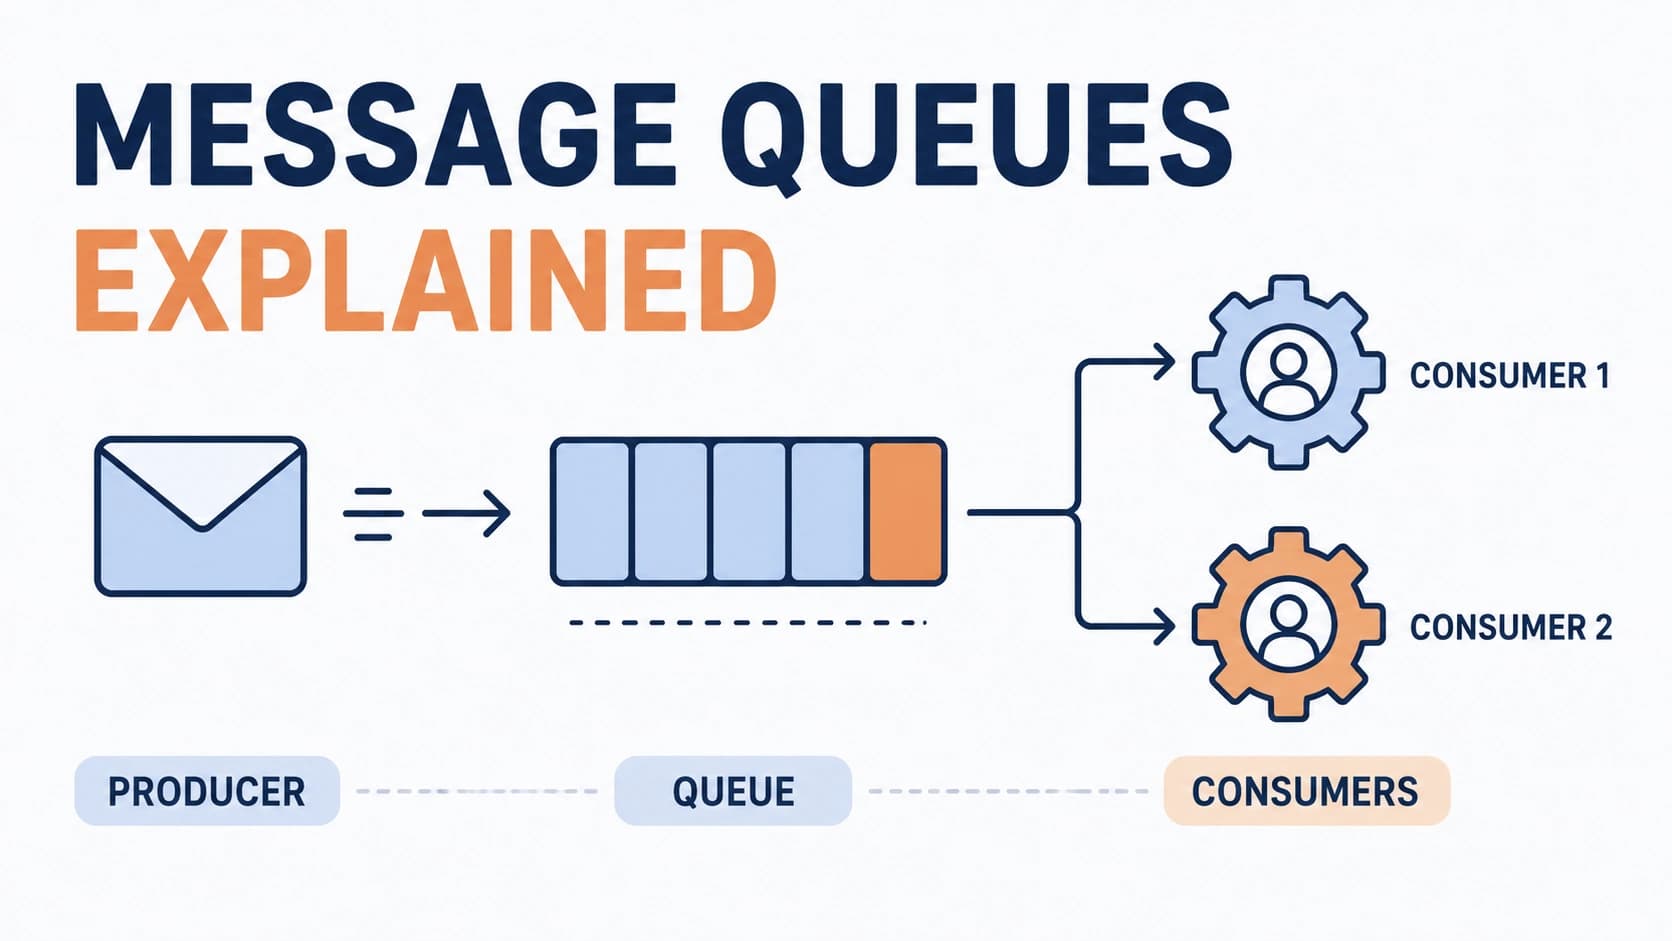
یه چیزی که تو مستندات خیلی جاها ساده جلوه داده میشه ولی تو عمل مهمه، تفاوت بین الگوهای مختلف صفبندیه:
Point-to-point (work queue): یه صف داریم و چند تا consumer که هر پیام فقط توسط یکی از اونها پردازش میشه. مناسب کارهایی مثل پردازش تصویر، ارسال ایمیل، یا هر کاری که باید دقیقاً یکبار انجام بشه.
# producer با pika (کلاینت RabbitMQ برای پایتون)
import pika

connection = pika.BlockingConnection(pika.ConnectionParameters('localhost'))
channel = connection.channel()
channel.queue_declare(queue='email_tasks', durable=True)

channel.basic_publish(
    exchange='',
    routing_key='email_tasks',
    body='{"user_id": 42, "type": "welcome_email"}',
    properties=pika.BasicProperties(delivery_mode=2)  # پیام روی دیسک persist بشه
)
Publish-subscribe: پیام به یه exchange یا topic فرستاده میشه و همهی subscriber ها (نه فقط یکی) یه کپی از اون رو میگیرن. برای رویدادهایی که چند تا سرویس مختلف باید بهشون واکنش نشون بدن مناسبه؛ مثلاً وقتی سفارشی ثبت میشه، هم سرویس انبار باید بدونه، هم سرویس ایمیل، هم آنالیتیکس.
Kafka خودش رو بیشتر حول همین مدل ساخته، با این تفاوت که پیامها بعد از مصرف حذف نمیشن و میتونن دوباره از اول خونده بشن — که این برای event sourcing یا replay کردن دادهها خیلی بهدردبخوره.
RabbitMQ یا Kafka؟
این سؤالی است که تو تقریباً هر تیمی یه بار مطرح میشه و جواب قطعی نداره، به این دلیل که این دو تا اصلاً برای یه هدف ساخته نشدن.
RabbitMQ یه message broker سنتیه، قوی تو routing پیچیده (exchange های direct، topic، fanout)، و مناسب وقتیه که کارها (task) داری که باید دقیقاً یکبار پردازش بشن و ترتیبشون خیلی حیاتی نیست. برای صفهای کاری معمولی، جواب میده و راهاندازیش هم نسبتاً سادهست.
Kafka بیشتر یه distributed log هست تا یه صف کلاسیک. throughput خیلی بالاتری داره، پیامها رو برای مدت طولانی نگه میداره، و برای stream processing و جایی که چند consumer باید مستقل از هم همون داده رو بخونن (و شاید بعداً دوباره بخونن) طراحی شده. ولی overhead عملیاتیش بیشتره؛ نیاز به Zookeeper یا KRaft داره و tuning اش پیچیدهتره.
قانون کلی که خودم بهش رسیدم: اگه صرفاً یه task queue میخوای (پردازش پسزمینه، job scheduling)، RabbitMQ یا حتی چیزی سبکتر مثل Redis + BullMQ کافیه. اگه داری event-driven architecture میسازی که چند سرویس باید stream یکسانی از رویدادها رو دنبال کنن، Kafka انتخاب منطقیتریه.
چیزهایی که معمولاً کسی بهت نمیگه
یه چیزی که تو اکثر tutorial ها نادیده گرفته میشه، مسئلهی idempotency است. queue تضمین میکنه پیام حتماً تحویل داده میشه، ولی این تضمین معمولاً به معنی «حداقل یکبار» (at-least-once) هست، نه دقیقاً یکبار. یعنی اگه consumer پیامی رو پردازش کنه ولی قبل از فرستادن ack کرش کنه، همون پیام دوباره تحویل داده میشه. اگه handler ات idempotent نباشه (مثلاً دوباره یه ایمیل یا دوباره کم کردن موجودی انبار)، این میتونه به باگهای عجیبی منجر بشه که فقط زیر لود بالا خودشون رو نشون میدن.
راهحل معمولش اینه که یه شناسهی یکتا (idempotency key) رو تو خود پیام بذاری و قبل از پردازش چک کنی که این key قبلاً پردازش شده یا نه — معمولاً با یه جدول یا کلید تو Redis با TTL مناسب.
نکتهی دیگه، dead letter queue است. اگه یه پیام چندین بار fail بشه (مثلاً یه فرمت دادهی خراب)، نباید بذاری برای همیشه بین صف اصلی و consumer رد و بدل بشه. اکثر broker ها امکان تعریف یه صف جداگانه رو دارن که بعد از N بار retry ناموفق، پیام به اونجا منتقل میشه تا بعداً دستی بررسیش کنی. بدون این، یه پیام خراب میتونه کل صف رو مسدود کنه یا لاگها رو پر کنه.
کِی اصلاً به queue نیاز نداری
با همهی این حرفها، queue همیشه جواب درست نیست. اگه عملیاتت سریعه و کاربر واقعاً باید نتیجهی فوری رو ببینه (مثلاً یه محاسبهی قیمت لحظهای)، اضافه کردن یه لایهی async فقط پیچیدگی اضافه میکنه بدون هیچ فایدهای. queue بیشتر برای کارهایی معنی داره که میتونن «بعداً» انجام بشن، یا وقتی حجم درخواستها نامنظمه و میخوای consumer رو از فشار لحظهای محافظت کنی.
اگه تازه داری معماری یه سیستم رو طراحی میکنی، بهتره اول ببینی کدوم بخش از پردازشت واقعاً میتونه صبر کنه، بعد queue رو دقیقاً همونجا اضافه کنی — نه اینکه از اول همهچیز رو async کنی چون «الگوی بهتریه».
// pseudo-code ساده برای fixed window
const requests = {}; // { userId: { count, windowStart } }

function isAllowed(userId, limit = 100, windowMs = 60000) {
  const now = Date.now();
  const entry = requests[userId];

  if (!entry || now - entry.windowStart > windowMs) {
    requests[userId] = { count: 1, windowStart: now };
    return true;
  }

  if (entry.count >= limit) return false;
  entry.count++;
  return true;
}
مشکل این روش یک نکتهی ظریفه: چون بازهها ثابت و جدا از همن، یک کلاینت میتونه دقیقاً لحظهی آخر یک بازه ۱۰۰ درخواست بفرسته و دقیقاً لحظهی اول بازهی بعدی، ۱۰۰ درخواست دیگه — یعنی توی یک بازهی دو ثانیهای واقعی، ۲۰۰ درخواست رد شده، درحالیکه سقف روی کاغذ ۱۰۰ در دقیقه بود. به این پدیده burst at boundary میگن.
Sliding Window
این روش با نگهداشتن timestamp دقیق هر درخواست (یا یک تقریب وزندار از دو بازهی متوالی)، مشکل burst مرزی رو حل میکنه. دقیقتره ولی حافظه و محاسبات بیشتری میخواد، چون باید یا timestamp های تکتک درخواستها رو نگه داری، یا یک فرمول ترکیبی حساب کنی.
Token Bucket
این یکی از محبوبترین الگوریتمهاست، چون هم دقیقه، هم به کلاینت اجازهی burst کنترلشده میده. تصورش اینطوریه: یک سطل با ظرفیت مشخص (مثلاً ۱۰ توکن) داری که با نرخ ثابتی (مثلاً یک توکن در ثانیه) پر میشه. هر درخواست یک توکن مصرف میکنه؛ اگه سطل خالی باشه، درخواست رد میشه. مزیتش اینه که اگه کلاینت مدتی درخواستی نفرستاده باشه، سطلش پر مونده و میتونه یک burst کوتاه (تا سقف ظرفیت سطل) بفرسته، ولی نمیتونه برای مدت طولانی بالاتر از نرخ میانگین ادامه بده.
مشابه token bucket ولی از زاویهی دیگه: درخواستها توی یک صف (سطل) قرار میگیرن و با نرخ ثابتی از صف خارج و پردازش میشن، مثل یک سطل که از یک سوراخ ثابت آب نشت میکنه. اگه صف پر بشه، درخواستهای جدید رد میشن. این روش خروجی رو کاملاً یکنواخت نگه میداره (بدون burst)، برخلاف token bucket که burst محدود رو مجاز میدونه — انتخاب بین این دو به این بستگی داره که آیا میخوای نرخ خروجی کاملاً ثابت باشه، یا کمی انعطاف برای burst داشته باشه.
کجا پیادهسازیش کنیم
rate limiting رو میشه در چند لایه پیاده کرد. توی سطح Nginx یا یک reverse proxy، با ماژول limit_req میشه بدون تغییر کد اپلیکیشن، محدودیت گذاشت:
توی سطح اپلیکیشن، معمولاً از Redis برای نگهداشتن شمارندهها استفاده میشه، چون Redis سریع و atomic عمل میکنه و اگه چند instance از سرور اپلیکیشن داشته باشی، همه بتونن یک شمارندهی مشترک رو ببینن (که با یک شمارندهی in-memory جدا روی هر instance، امکانش نیست).
توی سطح API Gateway (مثل Kong، AWS API Gateway، یا Cloudflare)، rate limiting معمولاً بهصورت آماده و قابلتنظیم از طریق پنل مدیریت وجود داره، بدون نیاز به نوشتن کد.
پاسخ درست به کلاینت رد شده
وقتی یک درخواست بهخاطر rate limit رد میشه، باید کد وضعیت HTTP استاندارد 429 Too Many Requests رو برگردونی، و بهتره هدر Retry-After رو هم اضافه کنی تا کلاینت بدونه دقیقاً چند ثانیه دیگه باید صبر کنه قبل از تلاش مجدد. این جزئیات کوچیک، تفاوت بین یک API قابلاعتماد و یکی که کلاینتهاش رو گیج میکنه رو میسازه.
چطوری بهتره استفاده بشه ؟
Rate limiting را میتوان در چند لایه مختلف پیادهسازی کرد؛ از لایه زیرساخت مثل Nginx و API Gateway گرفته تا داخل خود اپلیکیشن. انتخاب محل مناسب بستگی دارد به اینکه هدف اصلی، محافظت از منابع سیستم است یا کنترل رفتار کاربران و قوانین کسبوکار.
Rate Limiting در Nginx / Reverse Proxy
Nginx در لایه ورودی سیستم قرار میگیرد و قبل از رسیدن درخواست به اپلیکیشن تصمیم میگیرد که درخواست اجازه عبور دارد یا نه. مزیت اصلی این روش این است که درخواستهای اضافی اصلاً وارد برنامه نمیشوند و منابعی مثل CPU، حافظه و اتصالهای دیتابیس مصرف نمیشوند.
این روش برای جلوگیری از فشار زیاد، حملات حجمی، crawlerها و درخواستهای غیرعادی بسیار مناسب است.
مزایا:
عملکرد بسیار بالا
کاهش فشار روی اپلیکیشن
عدم نیاز به تغییر کد برنامه
محدودیت اصلی آن این است که معمولاً فقط به اطلاعاتی مثل IP و Header دسترسی دارد و نمیتواند تفاوت بین کاربران، پلنها یا سطح دسترسی آنها را تشخیص دهد.
مثلاً نمیتواند بهتنهایی تصمیم بگیرد که یک کاربر رایگان فقط ۱۰۰ درخواست در دقیقه داشته باشد و یک کاربر حرفهای ۱۰۰۰۰ درخواست.
Rate Limiting در Middleware اپلیکیشن
در این روش محدودیت داخل خود برنامه اعمال میشود. چون اپلیکیشن اطلاعات بیشتری درباره کاربر دارد، میتواند قوانین دقیقتری بر اساس User ID، API Key، نقش کاربر یا نوع اشتراک اعمال کند.
برای مثال، یک سرویس هوش مصنوعی میتواند برای کاربران رایگان محدودیت ۱۰ درخواست در روز و برای کاربران پولی محدودیت ۱۰۰۰ درخواست در روز قرار دهد.
مزایا:
دسترسی به اطلاعات کامل کاربر
مناسب برای قوانین کسبوکار
انعطافپذیری بالا
اما مشکل این روش این است که درخواست ابتدا وارد اپلیکیشن میشود و سپس محدود میشود. همچنین در معماریهای چند سروره، نگهداری شمارنده در حافظه داخلی هر سرور باعث ایجاد خطا میشود.
برای مثال اگر یک کاربر ۱۰۰ درخواست ارسال کند و Load Balancer آن را بین دو سرور تقسیم کند، هر سرور ممکن است فقط ۵۰ درخواست ببیند و محدودیت بهدرستی اعمال نشود.
به همین دلیل معمولاً از Redis یا یک ذخیرهساز مشترک برای نگهداری وضعیت rate limit استفاده میشود.
Rate Limiting در API Gateway
API Gateway یک لایه مدیریتی بین کلاینت و سرویسهای مختلف قرار میگیرد و معمولاً برای معماریهای بزرگ و چندسرویسی استفاده میشود.
این لایه میتواند محدودیتهای مشترکی برای تمام APIها اعمال کند، API Key مدیریت کند، quota تعریف کند و سیاستهای امنیتی را بهصورت متمرکز اجرا کند.
مزایا:
مناسب برای Microserviceها
مدیریت متمرکز APIها
پشتیبانی از API Key و quota
در مقابل، پیچیدگی و هزینه بیشتری نسبت به Nginx یا middleware ساده دارد و برای پروژههای کوچک ممکن است بیش از نیاز باشد.
بهترین رویکرد: ترکیبی از چند لایه
در سیستمهای واقعی معمولاً از یک روش واحد استفاده نمیشود، بلکه چند لایه با هم کار میکنند.
یک معماری رایج:
Client

   |
   v

Cloudflare / WAF

   |
   v

Nginx
(IP Rate Limit)

   |
   v

Application
(User/API Key Limit)

   |
   v

Redis
(Shared Counter)

   |
   v

Database
در این معماری:
Nginx جلوی فشار غیرعادی روی زیرساخت را میگیرد.
Middleware اپلیکیشن محدودیتهای مربوط به کاربران و منطق کسبوکار را اجرا میکند.
Redis وضعیت rate limit را بین چند سرور هماهنگ نگه میدارد.
API Gateway در سیستمهای بزرگ مدیریت متمرکز APIها را انجام میدهد.
مثال:
برای یک وبسایت بلاگی متوسط، یک نقطه شروع منطقی میتواند این باشد:
محدودیت عمومی در Nginx: حدود 50 تا 100 درخواست در ثانیه برای هر IP
محدودیت در سطح کاربر: حدود 1000 تا 3000 درخواست در ساعت که مثلا از ۱۰۰۰ تا برای مهمان و ۳۰۰۰ برای بالاترین سطح دسترسی قبل از ادمین
endpointهای حساس: بین 3 تا 10 درخواست در دقیقه
اما این اعداد قطعی نیستند. یک وبسایت خبری با میلیونها بازدید روزانه، یک وبلاگ شخصی و یک SaaS با API عمومی، نیازهای کاملاً متفاوتی دارند.
عدد صحیح زمانی مشخص میشود که رفتار واقعی کاربران، میانگین درخواستها، زمان پاسخ API، ظرفیت سرور و مصرف منابع بررسی شود. Rate limiting باید بر اساس ظرفیت سیستم تنظیم شود، نه صرفاً بر اساس یک عدد از پیش تعیینشده.
جمعبندی
rate limiting یکی از اون تصمیمهای زیرساختیه که تا نیازش رو حس نکنی، شاید حس کنی زیادیه، ولی وقتی یک باگ توی یک کلاینت یا یک حملهی ساده بدون این لایه سرورت رو از پا دربیاره، میفهمی چرا این یکی از اولین چیزهاییه که هر API عمومی باید از روز اول داشته باشه، نه چیزی که بعد از اولین حادثه اضافهاش میکنی.
دوم، طول متغیر. cuid اصلی طول ثابتی داشت، ولی cuid2 بهصورت پیشفرض طول قابل تنظیم داره (پیشفرض ۲۴ کاراکتر) و میتونی بین ۴ تا ۳۲ کاراکتر تنظیمش کنی، بسته به اینکه چقدر فضای نام یا خوانایی برات مهمه.
سوم، شروع با حرف. هر cuid2 با یک حرف (نه عدد) شروع میشه، که این یک نکتهی فنی مهمه: بعضی سیستمها و زبانهای برنامهنویسی وقتی یک شناسه با عدد شروع بشه، ممکنه اون رو بهاشتباه بهعنوان عدد تفسیر کنن (مثلاً توی نام متغیر جاوااسکریپت یا بعضی زبانهای کوئری). با اجباریکردن شروع با حرف، cuid2 این کلاس از باگها رو کامل حذف میکنه.
چهارم، همچنان قابل مرتبسازی تقریبی بر اساس زمانه (نه دقیق مثل ULID، ولی بهاندازهی کافی برای اکثر کاربردهای عملی)، بدون اینکه این ترتیب، اطلاعات حساس رو لو بده.
مقایسهی مستقیم
ویژگی
cuid
cuid2
الگوریتم
fingerprint + timestamp + counter
SHA3 هش روی entropy تصادفی
قابل پیشبینی بودن
نسبتاً بله (ریسک امنیتی)
خیر
طول
ثابت
متغیر (پیشفرض ۲۴، قابل تنظیم ۴ تا ۳۲)
شروع رشته
حرف c ثابت
همیشه یک حرف تصادفی
عملکرد در serverless
ضعیفتر
بهینهشده
نگهداری پروژه
متوقف شده
فعال
مثال کد
استفاده از cuid2 توی جاوااسکریپت خیلی سادهست:
import { createId } from '@paralleldrive/cuid2';

const id = createId();
// مثال خروجی: tz4a98xxat96iws9zmbrgj3a

// اگه بخوای طول متفاوتی داشته باشی
import { init } from '@paralleldrive/cuid2';
const createShortId = init({ length: 10 });
const shortId = createShortId();
توی پروژههای Prisma هم، تعریف یک فیلد با cuid2 به این شکله:
model User {
  id String @id @default(cuid2())
}
کِی از هرکدوم استفاده کنیم
اگه پروژهی جدیدی شروع میکنی، عملاً هیچ دلیلی برای انتخاب cuid اصلی وجود نداره — نگهداریش متوقف شده و مشکلات امنیتیش شناختهشدهست. سراغ cuid2 برو، مگر اینکه نیازهای خاصتری داشته باشی: اگه به ترتیب دقیق زمانی (نه فقط تقریبی) نیاز داری، ULID انتخاب بهتریه؛ اگه سازگاری با استانداردهای جهانی و اکوسیستمهای قدیمیتر مهمه، UUID (بهخصوص نسخهی ۷ که خودش هم قابل مرتبسازی زمانیه) گزینهی امنتریه. ولی برای اکثر پروژههای وب مدرن که شناسهی کوتاه، url-friendly، و امن میخوان، cuid2 دقیقاً همونجاییه که باید بری.
Typesense هم رقیب مشابهیه، با فلسفهی تقریباً یکسان: نصب ساده، پاسخ سریع، API قابلفهم. هر دو این ابزارها برای autocomplete و جستجوی محصول توی فروشگاههای کوچیک تا متوسط، مستندات، یا هر جایی که کاربر انتظار جواب فوری داره، انتخابهای خیلی خوبی هستن.
اما این سادگی رایگان نیست. تریدآف اصلی اینه که Meilisearch و Typesense قابلیتهای aggregation پیچیدهای که Elasticsearch داره رو ندارن — یعنی اگه نیازت فقط جستجوی متنیه، عالی جواب میدن، ولی اگه میخوای همزمان تحلیل آماری روی میلیونها رکورد لاگ انجام بدی یا dashboard های پیچیدهی مانیتورینگ بسازی (کاری که Kibana روی Elasticsearch انجام میده)، این ابزارهای سبکتر برات کافی نیستن. خلاصهاش اینه: اگه مسئلهات «جستجو»ست، سبکترها رو انتخاب کن؛ اگه مسئلهات «جستجو + آنالیز حجم عظیم داده»ست، سراغ Elasticsearch برو.
نصب Elasticsearch با Docker
راحتترین و تمیزترین راه برای بالا آوردن Elasticsearch، بهخصوص برای توسعه یا تست، استفاده از Docker است، چون همهی وابستگیها (شامل خود JVM) داخل ایمیج پکیج شدن و مجبور نیستی هیچی رو دستی روی سیستم نصب کنی.
همچنین لازمه تنظیم vm.max_map_count رو دستی انجام بدی، چون Elasticsearch برای مدیریت حافظهی داخلیش به مقدار بالاتری از پیشفرض لینوکس نیاز داره:
sudo sysctl -w vm.max_map_count=262144
کدوم روش رو انتخاب کنیم
برای توسعه، تست محلی، یا حتی خیلی از سناریوهای production کوچیک تا متوسط، Docker (یا بهتر، docker-compose همراه با volume برای persistence) گزینهی پیشنهادیه. مزیتش اینه که آپدیت نسخه، ریاستارت، و پاکسازی کامل محیط، یک دستور بیشتر نیست. نصب مستقیم روی سیستمعامل رو معمولاً وقتی توصیه میکنن که تیم زیرساخت از قبل روی مدیریت سرویسهای systemd و مانیتورینگ سطح OS تجربه داره، یا محدودیت سازمانی برای استفاده از Docker وجود داره. برای اکثر تیمها، مسیر Docker هم سریعتره هم قابلتکرارتر (reproducible)، پس معمولاً انتخاب اول همینه.
نوشتن Query در Elasticsearch
Elasticsearch با یک زبان JSON-based به اسم Query DSL کار میکنه. سادهترین حالت، جستجوی متنی روی یک فیلد است:
نکتهی مهم اینجا فرق must و filter است: بخش must روی امتیاز relevance تأثیر میذاره (یعنی نتایج بر اساس میزان تطابق رتبهبندی میشن)، ولی filter فقط true/false هست و روی امتیاز اثر نداره — و چون کش میشه، سریعتر هم اجرا میشه. برای شرطهایی مثل بازهی قیمت یا وضعیت موجودی که فقط باید فیلتر کنن نه رتبهبندی، همیشه از filter استفاده کن.
برای aggregation، یعنی محاسبات آماری روی نتایج، مثلاً میانگین قیمت به تفکیک برند:
عدد ^2 کنار title یعنی تطابق توی این فیلد دو برابر وزن بیشتری توی محاسبهی relevance داره — یعنی اگه کلمه توی عنوان پیدا بشه، نسبت به پیدا شدن توی توضیحات، امتیاز بالاتری میگیره.
جستجوی مقاوم به غلط تایپی (fuzzy)
اگه بخوای حتی وقتی کاربر کلمه رو اشتباه تایپ کرده جواب پیدا کنی:
ترکیب چند شرط با bool کامل (must, should, must_not, filter)
یک مثال واقعیتر که همهی بخشهای bool رو با هم نشون میده: محصولاتی که «کفش» توی عنوانشونه، ترجیحاً برند «نایک» یا «آدیداس» باشن (امتیاز بیشتر ولی اجباری نیست)، جنسشون «چرم» نباشه، و موجود باشن:
اینجا نتایج اول بر اساس قیمت صعودی مرتب میشن و در صورت تساوی قیمت، بر اساس امتیاز relevance. from و size هم صفحهی سوم رو برمیگردونن (فرض بر ۱۰ آیتم در هر صفحه).
هایلایت کردن کلمهی جستجوشده در نتیجه
وقتی میخوای مثل گوگل، بخشی از متن که با جستجو مطابقت داشته رو بولد نشون بدی:
اینجا k تعداد نزدیکترین نتایجی که میخوای برگرده رو مشخص میکنه، و num_candidates تعداد کاندیدهایی که Elasticsearch قبل از انتخاب k تای نهایی بررسی میکنه — عدد بزرگتر یعنی دقت بالاتر ولی سرعت پایینتر.
قابلیتهای اضافهای که کمتر دیده میشن
فراتر از جستجوی متنی معمولی، Elasticsearch چند قابلیت داره که ارزش دونستن دارن.
geo queries به تو اجازه میدن جستجوی مکانی انجام بدی — مثلاً «همهی رستورانهای نزدیک این مختصات جغرافیایی توی شعاع ۲ کیلومتر». این برای اپلیکیشنهای مبتنی بر موقعیت مکانی حیاتیه و بدون ابزار جانبی مستقیم پشتیبانی میشه.
kNN search یا جستجوی برداری، قابلیتیه که این چند سال با رشد هوش مصنوعی خیلی مهم شده: میتونی بهجای جستجوی متنی، بردارهای embedding (خروجی مدلهای زبانی) رو ایندکس کنی و نزدیکترین بردارها به یک query رو پیدا کنی — دقیقاً همون چیزی که پشت سیستمهای RAG (retrieval-augmented generation) قرار داره.
percolate query برعکس جستجوی معمولیه: بهجای اینکه یک query رو روی مجموعهای از داده اجرا کنی، یک دادهی جدید رو روی مجموعهای از query های از قبل ذخیرهشده تست میکنی — مفید برای سیستمهای هشدار و فیلترینگ که باید بفهمن یک رکورد جدید با کدوم شرطهای ازپیشتعریفشده مطابقت داره.
و در نهایت، ecosystem کامل ELK/Elastic Stack — یعنی Kibana برای visualization، Logstash و Beats برای جمعآوری و انتقال داده — چیزیه که Elasticsearch رو از یک دیتابیس جستجو به یک پلتفرم کامل observability تبدیل میکنه، که این یکی از دلایل اصلیه که با وجود سنگین بودنش، توی محیطهای enterprise همچنان انتخاب اول میمونه.
جمعبندی
Elasticsearch ابزار درستیه وقتی هم جستجوی متنی پیچیده و هم آنالیز حجم بالای داده رو همزمان نیاز داری. ولی اگه فقط دنبال یک جستجوی سریع و typo-tolerant برای سایت یا اپلیکیشنت هستی، قبل از اینکه وقت بذاری برای راهاندازی یک کلاستر Elasticsearch، حتماً Meilisearch یا Typesense رو هم امتحان کن — احتمالاً همون کاری که میخوای رو با یکدهم پیچیدگی انجام میدن.
توی replication همزمان (synchronous)، primary صبر میکنه تا حداقل یک replica تغییر رو دریافت و تأیید کنه، بعد به کلاینت میگه عملیات موفق بوده. این تضمین میده که هیچوقت دادهای که کلاینت فکر میکنه ذخیره شده، گم نشه — حتی اگه دقیقاً یک لحظه بعد primary از کار بیفته. هزینهاش اینجاست که هر نوشتن باید منتظر شبکه و replica هم بمونه، پس تأخیر (latency) بالاتر میره.
توی replication ناهمزمان (asynchronous)، primary بلافاصله بعد از نوشتن محلی به کلاینت جواب موفق میده، و تغییر رو در پسزمینه به replica ها میفرسته. سریعتره، ولی یک ریسک واقعی داره: اگه primary دقیقاً بین «جوابدادن به کلاینت» و «رسوندن تغییر به replica» از کار بیفته، اون تغییر ممکنه هیچوقت به replica نرسه و گم بشه. این حالت رو replication lag میگن — فاصلهی زمانی بین اتفاقافتادن یک تغییر روی primary و رسیدنش به replica.
اکثر سیستمهای production، بهخاطر تعادل بین سرعت و امنیت داده، از async استفاده میکنن، و ریسکش رو با مانیتورینگ لگ ریپلیکیشن و طراحی درست مدیریت میکنن، نه اینکه کامل حذفش کنن.
مشکلی که replication lag واقعاً ایجاد میکنه
فرض کن یک کاربر همین الان یک پست جدید توی اپلیکیشنت ثبت کرده. درخواست نوشتن روی primary انجام شده و جواب موفق برگشته. حالا همون کاربر بلافاصله صفحه رو رفرش میکنه، و این دفعه درخواست خواندن به یک replica هدایت میشه که هنوز اون تغییر رو دریافت نکرده. نتیجه؟ کاربر پست خودش رو نمیبینه و فکر میکنه ثبت نشده. این پدیده رو read-after-write inconsistency میگن و یکی از رایجترین سردرگمیهایییه که موقع استفاده از read replica ها پیش میاد.
راهحل رایجش اینه که برای عملیاتهای حساس به این مشکل (مثل نمایش بلافاصلهی دادهای که کاربر خودش همین الان ثبت کرده)، خواندن رو موقتاً از primary انجام بدی، نه از replica؛ یا اینکه یک مکانیزم «sticky session» بذاری که هر کاربر برای مدتی بعد از نوشتن، به همون primary وصل بمونه.
failover: چه کسی primary جدید میشه
وقتی primary از کار میافته، سیستم باید تصمیم بگیره کدوم replica جای اون رو بگیره. این کار میتونه دستی باشه (یک مهندس وارد میشه و خودش replica رو ترفیع میده) یا خودکار، با ابزارهایی مثل Patroni برای PostgreSQL یا Orchestrator برای MySQL (رپو اصلی دیگه مینتین نمیشه من جدید رو هم لینک میکنم) که وضعیت سلامت primary رو مانیتور میکنن و در صورت خرابی، خودشون یکی از replica ها رو (معمولاً همونی که کمترین لگ رو داره) به primary جدید ترفیع میدن.
نکتهای که اینجا باید بهش دقت کرد: اگه دو replica همزمان فکر کنن primary هستن (که بهش پدیدهی split-brain میگن)، ممکنه هر دو بهطور مستقل نوشتن قبول کنن و داده از هم واگرا بشه. سیستمهای failover خوب معمولاً یک مکانیزم consensus (مثل الگوریتم Raft) دارن که تضمین میکنه در هر لحظه فقط یک primary واقعی وجود داره.
multi-master: وقتی هر جا میتونه بنویسه
توی مدل primary-replica معمولی، فقط primary اجازهی نوشتن داره. یک مدل جایگزین multi-master (یا multi-leader) است، جایی که چند سرور همزمان اجازهی نوشتن دارن و تغییراتشون رو با هم sync میکنن. این برای سیستمهای توزیعشدهی جغرافیایی جذابه — مثلاً یک سرور توی اروپا و یکی توی آسیا، هرکدوم بدون نیاز به رفتوبرگشت روی اقیانوس، مستقیم نوشتن رو قبول کنن. ولی هزینهی این مدل، مواجههست با تعارض (conflict): اگه دو کاربر همزمان روی دو سرور مختلف یک ردیف رو ویرایش کنن، سیستم باید تصمیم بگیره کدوم نسخه برندهست، که معمولاً با استراتژیهایی مثل «آخرین نوشتن برندهست» یا ساختارهای دادهی خاص به اسم CRDT حل میشه.
جمعبندی
ریپلیکیشن معاملهی همیشگی سیستمهای توزیعشده رو دوباره جلوی چشمت میذاره: بین سرعت، سازگاری، و دسترسپذیری باید انتخاب کنی، چون هر سهتاش رو همزمان و کامل نمیشه داشت. برای اکثر اپلیکیشنها، یک primary با چند async replica برای read scaling و disaster recovery کافیه. فقط وقتی واقعاً نیاز به نوشتن همزمان از چند نقطهی جغرافیایی داری، ارزششو داره که پیچیدگی multi-master رو به جون بخری.
سومی directory-based sharding است، جایی که یک جدول جدا (یا سرویس جدا) نگه میداری که میگه هر کلید دقیقاً کدوم شارده. انعطاف بیشتری میده — میتونی هر موقع خواستی داده رو جابهجا کنی بدون اینکه فرمول هش عوض بشه — ولی خودش یک نقطهی اضافهست که باید مدیریتش کنی و مراقب باشی bottleneck نشه.
چیزی که واقعاً سخته: query هایی که چند شارد رو لمس میکنن
توی یک دیتابیس تکسروری، یک JOIN بین دو جدول یا یک عملیات تراکنشی روی چند ردیف، کار همیشگی و بیدردسریه. توی یک سیستم شارد شده، این همون کاریه که واقعاً سخت میشه. اگه دو ردیفی که میخوای join کنی روی دو شارد مختلف باشن، دیگه نمیتونی از یک JOIN سادهی SQL استفاده کنی؛ باید یا داده رو توی اپلیکیشن خودت از دو شارد بخونی و دستی join کنی، یا از یک لایهی query routing استفاده کنی که این کار رو برات مخفی کنه.
همین مسئله برای تراکنشها هم صدق میکنه. یک تراکنش که باید همزمان روی دو ردیف از دو شارد مختلف atomic عمل کنه (یا هر دو موفق بشن یا هیچکدوم)، به یک پروتکل به اسم two-phase commit یا الگوهای پیچیدهتری مثل Saga نیاز داره. این دقیقاً همون چیزیه که شاردینگ رو از یک تصمیم سادهی زیرساختی به یک تصمیم معماری تبدیل میکنه؛ وقتی شارد میکنی، عملاً داری از دنیای تراکنشهای سادهی ACID فاصله میگیری، مگر اینکه خیلی هوشمندانه shard key رو طوری انتخاب کنی که دادههای مرتبط همیشه کنار هم بمونن.
re-sharding: کابوس واقعی
فرض کن با hash-based sharding شروع کردی و چهار شارد داری. حالا نیاز داری شاردهای بیشتری اضافه کنی. مشکل اینجاست که اگه فرمول هشت چیزی ساده مثل hash(key) % 4 باشه، وقتی این عدد رو به ۵ تغییر بدی، تقریباً تمام mapping ها بههم میریزه — چون باقیماندهی تقسیم برای اکثر کلیدها عوض میشه. یعنی باید تقریباً کل داده رو جابهجا کنی، درست همون چیزی که موقع طراحی سیستم میخواستی ازش فرار کنی.
راهحل رایج برای این مشکل consistent hashing است — همون تکنیکی که توی مقالهی لود بالانسینگ دربارهی Maglev گوگل ازش گفتیم. با consistent hashing، اضافهکردن یک شارد جدید فقط باعث میشه بخش کوچیکی از داده جابهجا بشه، نه همهچیز. برای همین سیستمهای بزرگمقیاسی مثل Cassandra و DynamoDB این تکنیک رو بهعنوان پایهی مکانیزم شاردینگشون انتخاب کردن.
مثالهای واقعی
Vitess، که اصلش رو یوتیوب برای مقیاسدادن MySQL ساخت (و بعداً Slack و GitHub هم ازش استفاده کردن)، دقیقاً یک لایهی میانی روی MySQL میذاره که شاردینگ رو تا حد زیادی از دید اپلیکیشن مخفی میکنه. Citus هم همین کار رو برای PostgreSQL انجام میده — جدولها رو بهصورت شفاف بین چند نود پخش میکنه و کوئریها رو بهصورت خودکار روت میکنه. MongoDB هم شاردینگ رو بهعنوان یک قابلیت داخلی و نه یک ابزار جانبی ارائه میده، که همین یکی از دلایلیه که خیلی از تیمها برای دادهی خیلی بزرگ سراغش میرن.
جمعبندی
شاردینگ آخرین ابزاریه که باید بهش فکر کنی، نه اولین. قبل از رسیدن به این مرحله معمولاً ایندکسگذاری بهتر، کش، و read replica ها میتونن مدت زیادی جوابگو باشن. شاردینگ رو وقتی به سراغش میری که واقعاً داده یا نرخ نوشتن از ظرفیت یک ماشین رد شده، چون همراهش پیچیدگیهای واقعی میاد: query های چندشارده سخت میشن، تراکنشها پیچیده میشن، و re-sharding میتونه یک پروژهی چندهفتهای بشه اگه از اول درست طراحی نشده باشه.
یک تمایز مهم که خیلی وقتها گیجکنندهست، فرق ایندکس clustered و non-clustered است. توی ایندکس clustered، ترتیب فیزیکی داده روی دیسک دقیقاً همون ترتیب ایندکسه — یعنی خود جدول، به شکل ایندکس مرتب شده. هر جدول فقط میتونه یک ایندکس clustered داشته باشه، چون داده فقط یک ترتیب فیزیکی روی دیسک میتونه داشته باشه. توی MySQL با InnoDB، این معمولاً همون primary key است.
ایندکس non-clustered یک ساختار جداست که فقط اشارهگر به ردیف اصلی نگه میداره، نه خود داده رو. میتونی تعداد دلخواهی از این نوع ایندکس روی یک جدول داشته باشی. تفاوتش توی عمل اینه که خوندن از ایندکس clustered یک مرحله کمتر داره (چون داده همونجاست)، ولی non-clustered برای ستونهای غیر primary key انعطاف بیشتری میده.
ایندکس ترکیبی و ترتیب ستونها
وقتی کوئریهات معمولاً چند شرط با هم دارن — مثلاً WHERE user_id = ? AND status = 'active' — میتونی یک composite index روی هر دو ستون بسازی. نکتهی مهمی که خیلی از دولوپرها نادیده میگیرن اینه که ترتیب ستونها توی ایندکس ترکیبی مهمه. یک ایندکس روی (user_id, status) برای کوئریهایی که با user_id فیلتر میکنن (با یا بدون status) مفیده، ولی برای کوئریهایی که فقط روی status فیلتر میکنن و اصلاً کاری با user_id ندارن، عملاً بیفایدهست — چون درست مثل فهرست کتابیه که بر اساس فصل مرتب شده، نه بر اساس موضوع؛ اگه فصل رو ندونی، فهرست کمکت نمیکنه.
CREATE INDEX idx_user_status ON orders (user_id, status);

-- این کوئری از ایندکس بالا خوب استفاده میکنه
SELECT * FROM orders WHERE user_id = 42 AND status = 'active';

-- این یکی عملاً از این ایندکس استفاده نمیکنه
SELECT * FROM orders WHERE status = 'active';
چطور بفهمیم دیتابیس واقعاً از ایندکس استفاده میکنه
خیلی وقتها فرض میکنیم چون ایندکس ساختیم، کوئری هم ازش استفاده میکنه، درحالیکه همیشه اینطور نیست. ابزار اصلی برای فهمیدن این موضوع دستور EXPLAIN (یا EXPLAIN ANALYZE توی PostgreSQL) است که نشون میده دیتابیس دقیقاً چه plan ای برای اجرای کوئری انتخاب کرده — آیا از ایندکس استفاده کرده یا رفته سراغ full table scan.
EXPLAIN ANALYZE
SELECT * FROM orders WHERE user_id = 42;
اگه توی خروجی این دستور عبارتی مثل Seq Scan ببینی بهجای Index Scan، یعنی دیتابیس تصمیم گرفته ایندکس رو نادیده بگیره — که میتونه چند دلیل داشته باشه: شاید جدول اونقدر کوچیکه که دیتابیس تشخیص داده full scan سریعتره، شاید آمار (statistics) دیتابیس قدیمی شده، یا شاید شرط کوئری طوری نوشته شده که ایندکس اصلاً قابل استفاده نیست (مثلاً استفاده از تابع روی ستون ایندکسشده، مثل WHERE LOWER(email) = ...).
وقتی ایندکس ضرر میزنه
جالبه که بدونی ایندکس همیشه سریعتر نیست. روی جدولهای خیلی کوچیک، یا وقتی یک شرط WHERE درصد بزرگی از جدول رو برمیگردونه (مثلاً بیش از ۲۰-۳۰ درصد ردیفها)، دیتابیس معمولاً ترجیح میده مستقیم برگرده به full scan، چون رفتن سراغ ایندکس و بعد پرش بین ردیفهای پراکنده روی دیسک، از یک خوندن پیوسته و ساده کندتره. این یکی از نکاتییه که خیلی از مهندسهای تازهکار تعجب میکنن وقتی برای اولین بار میبینن دیتابیس با وجود ایندکس، ازش استفاده نکرده — درحالیکه این تصمیم دیتابیس اتفاقاً درسته، نه باگ.
جمعبندی
ایندکس یک معاملهست، نه یک ترفند رایگان: سرعت خوندن رو در ازای سرعت نوشتن و فضای اضافی میخری. تصمیم درست این نیست که «همهچیز رو ایندکس کن»، بلکه اینه که بفهمی کدوم کوئریها واقعاً توی سیستم پرتکرارن، دقیقاً چه ستونهایی رو فیلتر یا مرتب میکنن، و بر همون اساس ایندکس بسازی — و بعد با EXPLAIN چک کنی که فرضت درست بوده.
async function getTopProducts() {
  const cached = await redis.get('top_products');
  if (cached) return JSON.parse(cached);

  const products = await db.query('SELECT ... ORDER BY sales DESC LIMIT 10');
  await redis.set('top_products', JSON.stringify(products), 'EX', 300); // 5 دقیقه
  return products;
}
این الگو رو cache-aside میگن: اول کش رو چک میکنی، اگه خالی بود از منبع اصلی میگیری و توی کش میذاری. رایجترین الگوی کش توی دنیای بکاند همینه، چون منطق سادهست و کنترل کامل دستته.
کش توی دیتابیس
خود دیتابیسها هم لایههای کش داخلی دارن که معمولاً کمتر بهشون فکر میکنیم. مثلاً PostgreSQL یک بخش به اسم shared buffers داره که صفحات پرکاربرد دیتابیس رو توی رم نگه میداره تا لازم نباشه هر بار از دیسک بخونه. MySQL هم مکانیزمهای مشابهی داره. این یعنی حتی وقتی فکر میکنی داری «مستقیم از دیتابیس» میخونی، احتمالاً بخشی از اون داده از قبل توی حافظهی خود دیتابیس کش شده و دیسک اصلاً درگیر نشده.
کش توی اپلیکیشنهای موبایل
توی اپهای موبایل هم همین منطق تکرار میشه، فقط با اسمهای دیگه. مثلاً یک اپلیکیشن ممکنه لیست محصولات یا فید خبری رو یک بار از سرور بگیره و توی حافظهی محلی گوشی (یا یک دیتابیس سبک مثل SQLite) نگه داره، تا کاربر بدون اینترنت هم بتونه محتوای قبلی رو ببینه، و تا وقتی دادهی جدیدی نیومده، دوباره از سرور درخواست نده. این هم برای تجربهی کاربری بهتره (لود سریعتر) و هم برای مصرف داده و باتری صرفهجویی میکنه.
چیزی که واقعاً برای یک مهندس نرمافزار جذابه: invalidation
جملهی معروفی توی دنیای برنامهنویسی هست که میگه فقط دو چیز سخت توی علوم کامپیوتر وجود داره: invalidate کردن کش، نامگذاری متغیرها، و off-by-one errors. این جمله شوخیه، ولی نکتهی جدی پشتش اینه: نگهداشتن داده توی کش کار سختی نیست؛ سخت اینه که بفهمی دقیقاً کِی اون داده دیگه معتبر نیست و باید پاکش کنی یا آپدیتش کنی.
فرض کن قیمت یک محصول توی دیتابیس عوض بشه، ولی نسخهی کششدهاش هنوز قیمت قدیمی رو نشون بده. اگه TTL طولانی گذاشته باشی، این عدمتطابق میتونه دقیقهها یا حتی ساعتها طول بکشه. راهحلهای رایج برای این مشکل چندتاست: یکی اینکه هر وقت داده توی دیتابیس آپدیت شد، مستقیماً همون کلید رو از کش پاک کنی (invalidate on write). یکی دیگه اینه که از TTL کوتاهتر استفاده کنی تا حداکثر «قدیمیبودن» داده محدود باشه. روش سوم که پیچیدهتره ولی قویتره، استفاده از event-based invalidation است: وقتی یک تغییر توی سیستم اتفاق میفته، یک event منتشر میشه و هر سرویسی که کش مرتبط داره، خودش رو آپدیت میکنه.
یک مشکل کمتر شناختهشده: cache stampede
این یکی از اون چیزهاییه که وقتی برای اولین بار باهاش برخورد میکنی، واقعاً غافلگیرت میکنه. فرض کن یک کلید کش با TTL پنج دقیقهای منقضی بشه، و دقیقاً همون لحظه هزار درخواست همزمان برسه. چون کش خالیه، هر هزار درخواست میرن سراغ منبع اصلی (مثلاً دیتابیس) تا همون مقدار رو دوباره محاسبه کنن — درحالیکه فقط یکی از این محاسبات کافی بود. این پدیده رو cache stampede یا thundering herd میگن، و میتونه یک دیتابیس سالم رو در عرض چند ثانیه از پا دربیاره.
راهحل رایج برای این مشکل یک قفل موقته: اولین درخواستی که میبینه کش خالیه، یک lock میگیره و شروع میکنه به محاسبه؛ بقیهی درخواستها یا منتظر میمونن تا اون قفل آزاد بشه، یا موقتاً همون مقدار قدیمی (حتی اگه منقضی شده) رو برمیگردونن تا محاسبهی جدید تموم بشه. به این تکنیک دوم گاهی stale-while-revalidate میگن، و توی خیلی از CDN ها و کتابخانههای کش هم پیادهسازی شده.
سیاستهای حذف: چه چیزی رو نگه داریم، چه چیزی رو دور بریزیم
چون حافظهای که کش توش نگهداری میشه (چه RAM چه هر چیز دیگه) محدوده، وقتی کش پر میشه باید یک چیزی رو حذف کنی تا جا برای دادهی جدید باز بشه. رایجترین سیاست LRU (Least Recently Used) است: چیزی که مدت طولانیتری استفاده نشده، اول حذف میشه. یک سیاست دیگه LFU (Least Frequently Used) است که بهجای «آخرین بار کِی استفاده شده» به «چند بار استفاده شده» نگاه میکنه. انتخاب بین این دو به رفتار واقعی ترافیکت بستگی داره — مثلاً برای یک فید خبری که محتوای پرطرفدار مدام عوض میشه، LRU معمولاً منطقیتره؛ برای دادههایی که یک زیرمجموعهی ثابت همیشه پرتکرارن، LFU میتونه بهتر عمل کنه.
جمعبندی
نکتهی جالب کش اینه که هیچوقت یک تصمیم یکباره نیست. هر لایهای از سیستم —از مرورگر تا CDN تا اپلیکیشن تا دیتابیس— نسخهی خودش رو از همین ایدهی ساده پیاده میکنه: یک بار محاسبه کن، سریع نگه دار، و مراقب باش که کِی این نسخهی سریع دیگه با واقعیت همخونی نداره. بخش سخت کش هیچوقت «نگهداشتن» نبوده؛ همیشه «دونستن کِی باید فراموشش کنی» بوده.
Layout ➔ Template ➔ Page
چه زمانی باید از template.tsx استفاده کنیم؟
زمانی که عدم حفظ State و اجرای مجدد کد با هر تغییر صفحه رفتار مطلوب ما باشد!
۱. انیمیشنهای ورود و خروج (Enter/Exit Animations)
یکی از کاربردیترین سناریوها، صفحاتی مثل ورود و ثبتنام (Sign In / Sign Up) است. اگر در این صفحات وکتورها، المانهای گرافیکی انتزاعی یا انیمیشنهای موشن (مثلاً با Framer Motion) دارید و میخواهید کاربر با رفتن از فرم Sign In به Sign Up، دوباره اجرای کامل انیمیشنها و ریست شدن حالتها را تجربه کند، template.tsx گزینه انتخابی شماست.
۲. لاگبرداری و Analytics بر اساس بازدید صفحه
اگر نیاز دارید با هربار ورود کاربر به هرکدام از صفحات فرعی، یک useEffect اجرا شده و اطلاعاتی مثل Page View ارسال شود.
۳. ریست شدن فرمها یا Stateهای وابسته به Route
وقتی میخواهید با جابهجایی بین مسیرها، حالتهای ورودی کاربر کلاً پاک شوند.
نمونه کد عملی
برای تعریف پروپهای کامپوننت در ریاکت و نکست، استفاده از type ساختار تمیزتر و یکدستتری ایجاد میکند:
// app/auth/template.tsx
import { ReactNode } from 'react';
type TemplateProps = {
children: ReactNode;
};
export default function AuthTemplate({ children }: TemplateProps) {
return (
<div className="auth-container animate-fade-in">
{/* المان گرافیکی یا وکتور دارای انیمیشن که در هر تغییر مسیر دوباره اجرا میشود */}
<div className="vector-illustration" />
<main>{children}</main>
</div>
);
}
چرا باید با احتیاط از آن استفاده کرد؟
استفاده بیمورد از template.tsx به جای layout.tsx میتواند روی تجربه کاربری و عملکرد برنامه تأثیر منفی بگذارد:
افت فریم و انیمیشنهای اضافی: اگر المانهای سنگینی درون Template قرار دهید، با هر جابهجایی کوچک فریمها مجدداً ساخته میشوند که میتواند باعث Perceived Latency (حس کندی) شود.
از دست رفتن Scroll Position یا حالتهای داخلی: فرمها یا کامپوننتهایی که انتظار دارید حالتشان حفظ شود، با هر Navigation کلاً ریست خواهند شد.
خلاصه تصمیمگیری
اگر میخواهید هدر، فوتر، Sidebar یا Stateها ثابت بمانند ➔ از layout.tsx استفاده کنید.
اگر میخواهید با هر تغییر مسیر، انیمیشنها مجدداً اجرا شده و Effectها ریست شوند ➔ از template.tsx استفاده کنید.
/api
/static
الگوریتمهای تقسیم ترافیک
خود لود بالانسر باید یک قانون داشته باشه که تصمیم بگیره کدوم درخواست بره کدوم سرور. رایجترینش round robin است: درخواستها بهترتیب و دورهای بین سرورها پخش میشن، بدون توجه به اینکه هر سرور الان چقدر مشغوله. سادهست ولی همیشه منصفانه نیست — اگه یک درخواست سنگینتر باشه و روی یک سرور طول بکشه، اون سرور همچنان درخواست بعدی رو هم میگیره.
الگوریتم least connections این مشکل رو حل میکنه: درخواست جدید میره سراغ سروری که الان کمترین تعداد کانکشن فعال رو داره. برای ترافیکی که مدت زمان پردازش درخواستهاش خیلی متفاوته (مثلاً بعضی درخواستها سریع جواب داده میشن، بعضی طول میکشن)، این روش عادلانهتره.
یک روش دیگه IP hash است، جایی که بر اساس IP کاربر یک هش محاسبه میشه و همیشه همون کاربر به همون سرور فرستاده میشه. این برای موقعیتهایی مفیده که session کاربر روی یک سرور خاص ذخیره شده و باید همیشه همون کاربر به همون سرور برسه — البته این خودش یک ضعف داره، چون اگه توزیع IP ها نامتوازن باشه، بعضی سرورها بیشتر از بقیه بار میگیرن.
ابزارهای واقعی
اگه بخوای خودت یک لود بالانسر راه بندازی، دو تا از رایجترین گزینهها Nginx و HAProxy هستن. یک تنظیم سادهی Nginx برای پخش ترافیک بین سه سرور backend اینشکلیه:
upstream backend_servers {
    least_conn;
    server 10.0.0.1:3000;
    server 10.0.0.2:3000;
    server 10.0.0.3:3000;
}

server {
    listen 80;
    location / {
        proxy_pass http://backend_servers;
    }
}
اینجا least_conn مشخص میکنه از الگوریتم least connections استفاده بشه، و هر درخواستی که به این سرور برسه بین این سه backend پخش میشه. HAProxy هم همین کار رو میکنه، ولی معمولاً برای سناریوهای پیچیدهتر و ترافیک بسیار بالا انتخاب اول خیلی از تیمهاست، چون از ابتدا برای همین کار طراحی شده و قابلیتهای health check و مانیتورینگش قویتره.
اگه نخوای خودت این لایه رو مدیریت کنی، سرویسهای ابری مثل Cloudflare یک لود بالانسر مدیریتشده ارائه میدن که هم روی لایهی DNS کار میکنه (یعنی حتی قبل از رسیدن ترافیک به سرورهات، بین چند دیتاسنتر جغرافیایی پخشش میکنه) و هم health check خودکار داره؛ اگه یک سرور جواب نده، خودش بهصورت خودکار از چرخه خارجش میکنه تا برگرده.
چند لود بالانسر مرجع که ارزش دیدن دارن
تا اینجا از Nginx و HAProxy و Cloudflare گفتم، ولی چند تا نمونهی دیگه هست که دیدنشون برای یک مهندس نرمافزار واقعاً جالبه، چون هرکدوم یک مسئلهی متفاوت رو حل کردن.
اولیش Maglev گوگله. این یک لود بالانسر لایهی ۴ نرمافزاریه که گوگل خودش ساخته و یک مقالهی مهندسی دربارش منتشر کرده. نکتهی جالب Maglev اینه که بهجای اینکه از هش معمولی استفاده کنه، از یک روش به اسم consistent hashing با یک جدول lookup بزرگ استفاده میکنه. چرا این مهمه؟ چون وقتی یک backend اضافه یا حذف میشه، اکثر connection های موجود همچنان به همون backend قبلیشون میرسن — فقط بخش کوچیکی جابهجا میشه. توی یک لود بالانسر ساده با mod hash، اضافهکردن یا حذف یک سرور میتونه تقریباً همهی mapping ها رو بههم بریزه، که برای سرویسهایی که connection طولانی دارن فاجعهست.
دومی Envoy Proxy است، که اولین بار توی Lyft ساخته شد و بعد به یکی از پروژههای اصلی CNCF تبدیل شد. چیزی که Envoy رو خاص میکنه اینه که configuration اش رو میشه بهصورت داینامیک و از راه دور، از طریق یک API به اسم xDS، تغییر داد، بدون اینکه پروسه ریاستارت بشه. این دقیقاً همون چیزیه که service mesh هایی مثل Istio بهش نیاز دارن: هزاران sidecar proxy که هر کدوم کنار یک سرویس نشستن، و باید بتونن بدون downtime روتها و policy هاشون رو آپدیت کنن.
سومی AWS است، که سه نوع لود بالانسر جدا ارائه میده و این خودش نشونهی خوبیه که چرا تفکیک لایهها مهمه: Network Load Balancer (NLB) برای لایهی ۴ با تأخیر خیلی پایین، Application Load Balancer (ALB) برای لایهی ۷ با قابلیتهایی مثل روتینگ بر اساس path یا host header، و Classic Load Balancer که نسخهی قدیمیتر و امروز کمتر توصیهشدهست. اینکه AWS این سه رو جدا از هم نگه داشته، نشون میده هیچ لود بالانسر «همهکاره» ای وجود نداره؛ انتخاب درست کاملاً به نوع ترافیک بستگی داره.
چهارمی که شاید برای خیلی از دولوپرها آشناتر باشه، خود Kubernetes است. سرویسهای Kubernetes از یک کامپوننت به اسم kube-proxy استفاده میکنن که روی هر node اجرا میشه و ترافیک بین Pod ها رو با استفاده از iptables یا IPVS پخش میکنه. جالبیش اینه که این لود بالانسینگ کاملاً decentralized اتفاق میفته — هیچ نقطهی مرکزی وجود نداره که همهی ترافیک از اون رد بشه، برخلاف مدل سنتی که یک لود بالانسر جلوی همهچیز میشینه.
اگه بخوای یک قدم عمیقتر بری، سراغ Linux Virtual Server (LVS) و IPVS برو — این تکنولوژی مستقیم توی kernel لینوکس پیادهسازی شده و پایهی خیلی از لود بالانسرهای بزرگمقیاس دنیا از جمله همون kube-proxy است. چیزی که این رو برای یک مهندس جالب میکنه اینه که کل تصمیمگیری لود بالانسینگ توی kernel space اتفاق میفته، نه توی user space، که یعنی سربار (overhead) بهشدت پایینتر از یک reverse proxy معمولیه.
نکتهای که معمولاً فراموش میشه
چیزی که خیلی از تیمها موقع راهاندازی اولین لود بالانسرشون فراموش میکنن، مدیریت session است. اگه اپلیکیشنت session رو توی حافظهی خود سرور نگه میداره (نه توی یک دیتابیس یا Redis مشترک)، وقتی کاربر بار دوم درخواست بده و لود بالانسر اون رو به یک سرور دیگه بفرسته، session گم میشه و کاربر عملاً logout میشه. راهحل درست این نیست که مجبور کنی کاربر همیشه به همون سرور برسه (چون این کار انعطاف لود بالانسر رو از بین میبره)؛ راهحل درست اینه که session رو از حافظهی محلی سرور جدا کنی و توی یک storage مشترک بین همهی سرورها نگه داری. این یکی از اون نکاتیه که تا خودت باهاش برخورد نکنی، احتمالاً موقع طراحی اولیه بهش فکر نمیکنی.
وقتی ویدیویی آپلود میشود، این سیستم آن را به بلوکهای کوچکتری به نام «شِرد» (Shard) تقسیم میکند. این بلوکها سپس در هزاران سرور مختلف در دیتاسنترهای گوناگون پخش میشوند. علاوه بر این، از هر بلوک حداقل سه نسخه (Replica) در مکانهای فیزیکی متفاوت ساخته میشود. اگر یکی از سرورها آتش بگیرد یا هارد دیسک آن از کار بیفتد، دو نسخه دیگر بلافاصله جایگزین آن میشوند و کاربر هیچگاه متوجه خرابی نمیشود.
راز دوم: جادوی فشردهسازی و کدکهای ویدیویی
چگونه یوتیوب این حجم عظیم را در خود جای میدهد؟ پاسخ در «فشردهسازی» نهفته است. ویدیوی خام آپلود شده توسط شما، حجمی وحشتناک دارد. یوتیوب بلافاصله پس از دریافت، آن را با استفاده از الگوریتمهای پیچیده ریاضی فشرده میکند.
یوتیوب از چندین «کدک» (Codec) استفاده میکند:
H.264: قدیمیتر اما با سازگاری بالا برای دستگاههای قدیمی.
VP9: کدک متنباز توسعهیافته توسط گوگل که فشردهسازی بهتری نسبت به H.264 دارد.
AV1: جدیدترین و کارآمدترین کدک. AV1 میتواند حجم ویدیو را تا ۳۰ درصد بیشتر از VP9 بدون افت کیفیت محسوس کاهش دهد. این یعنی صرفهجویی عظیم در پهنای باند و فضای ذخیرهسازی.
راز سوم: چگونه همه کیفیتها را همزمان دارد؟ (Transcoding و ABR)
این بخش جذابترین قسمت ماجراست. وقتی شما ویدیویی را با کیفیت ۱۰۸۰p آپلود میکنید، یوتیوب آن را به عنوان یک فایل واحد نگه نمیدارد.
۱. ترنسکدینگ (Transcoding): مزارع سروری یوتیوب (که اغلب از سختافزارهای تخصصی رمزنگاری ویدیو استفاده میکنند)، ویدیوی اصلی را میگیرند و آن را به چندین نسخه با رزولوشنهای مختلف (۱۴۴p, 240p, 360p, 480p, 720p, 1080p, 1440p, 2160p) تبدیل میکنند.
۲. قطعهقطعه کردن (Chunking): هر کدام از این نسخههای کیفیت، به تکههای بسیار کوچکی به مدت ۲ تا ۱۰ ثانیه تقسیم میشوند.
۳. استریم تطبیقی (Adaptive Bitrate Streaming - ABR): یوتیوب از پروتکلی به نام DASH استفاده میکند. پلیر یوتیوب در مرورگر یا اپلیکیشن شما، به طور مداوم سرعت اینترنتتان را رصد میکند. اگر اینترنت شما قوی باشد، تکههای ۱۰۸۰p را درخواست میکند. اگر اینترنت ضعیف شود، بدون اینکه ویدیو متوقف (Buffer) شود، به طور نامحسوس تکههای بعدی را با کیفیت ۴۸۰p درخواست میکند. این تغییر کیفیت همان چیزی است که گاهی در حین تماشای ویدیو آن را حس میکنید.
راز چهارم: نقش حیاتی CDN در تحویل سریع
حتی با فشردهسازی و قطعهقطعه کردن، اگر سرور یوتیوب در آمریکا باشد و شما در ایران باشید، تاخیر شبکه (Latency) باعث کندی میشود. اینجا شبکه توزیع محتوا (CDN) وارد عمل میشود.
گوگل یکی از بزرگترین CDNهای جهان را با نام Google Global Cache اداره میکند. آنها سرورهایی را در داخل دیتاسنترهای شرکتهای ارائهدهنده اینترنت (ISP) در سراسر جهان قرار میدهند. وقتی شما ویدیویی را تماشا میکنید، به احتمال زیاد آن تکههای چند ثانیهای را از سروری دریافت میکنید که از نظر فیزیکی فقط چند کیلومتر با شما فاصله دارد، نه چند هزار کیلومتر.
مقایسه یوتیوب با هاستینگ ویدیوی سنتی
در یک هاستینگ ویدیوی سنتی، معمولاً یک فایل واحد (مثلاً MP4) روی یک سرور ذخیره میشود. اگر اینترنت کاربر نوسان کند، ویدیو متوقف میشود تا بافر پر شود. کاربر نمیتواند کیفیت را به صورت پویا تغییر دهد و فشار زیادی به سرور اصلی وارد میشود.
در مقابل، معماری یوتیوب بر پایه توزیع، افزونگی (Redundancy) و تطبیقپذیری بنا شده است. این سیستم نه تنها تجربه کاربری را بدون وقفه نگه میدارد، بلکه بار ترافیکی را به بهینهترین شکل ممکن بین هزاران سرور تقسیم میکند.
مزایا و چالشهای این معماری عظیم
مزایا:
پایداری فوقالعاده: خرابی یک دیتاسنتر کل سرویس را از کار نمیاندازد.
تجربه کاربری یکپارچه: تغییر خودکار کیفیت بر اساس سرعت شبکه، بدون نیاز به توقف ویدیو.
بهینهسازی منابع: استفاده از کدکهایی مثل AV1 هزینههای پهنای باند گوگل را به شدت کاهش میدهد.
چالشها:
مصرف انرژی بالا: ترنسکدینگ و نگهداری دیتاسنترها در این مقیاس، مصرف برق بسیار بالایی دارد.
هزینه محاسباتی سنگین: پردازش ویدیو برای تولید چندین کیفیت و فرمت، نیازمند سختافزارهای گرانقیمت و تخصصی است.
پیچیدگی نگهداری: مدیریت هماهنگی بین میلیونها سرور و تریلیونها فایل کوچک، یکی از سختترین چالشهای مهندسی نرمافزار در جهان است.
جمعبندی نهایی و نگاه شخصی
به عنوان یک مهندس نرمافزار، هر بار که به معماری یوتیوب فکر میکنم، حس احترام عمیقی پیدا میکنم. این سیستم «جادو» نیست؛ نتیجه دههها تحقیق، شکست، و سرمایهگذاری عظیم روی الگوریتمهای فشردهسازی و سیستمهای توزیعشده است.
باید صادقانه بگویم که بسیاری از استارتاپها سعی کردهاند رقیب یوتیوب شوند، اما شکست خوردهاند. دلیل شکست آنها تکنولوژی نبود، بلکه ناتوانی در مدیریت هزینههای سرسامآور ذخیرهسازی و پهنای باند در این مقیاس بود. یوتیوب نه تنها یک پلتفرم محتوا، بلکه یک شاهکار مهندسی داده است که مرزهای ممکن را جابهجا کرده است.
سوالات متداول
چرا گاهی اوقات کیفیت ویدیو در یوتیوب خود به خود پایین میآید؟ این یک ویژگی است، نه باگ. پروتکل ABR (استریم تطبیقی) تشخیص میدهد که سرعت اینترنت شما لحظهای کاهش یافته است. برای جلوگیری از توقف ویدیو (Buffering)، پلیر به طور خودکار تکههای بعدی ویدیو را با کیفیت پایینتر درخواست میکند تا پخش روان باقی بماند.
آیا یوتیوب ویدیوهای قدیمی و کمبازدید را پاک میکند تا فضا آزاد شود؟ خیر. هزینه ذخیرهسازی داده در مقیاس گوگل نسبت به ارزش نگهداری آن داده ناچیز است. با این حال، یوتیوب از سیستمهای «ذخیرهسازی سرد» (Cold Storage) استفاده میکند. ویدیوهای قدیمی که به ندرت تماشا میشوند، به هارد دیسکهای کندتر اما بسیار ارزانتر منتقل میشوند و فقط در صورت درخواست کاربر، با کمی تاخیر اولیه در دسترس قرار میگیرند.
تفاوت اصلی کدک AV1 با نسلهای قبلی چیست؟ AV1 توسط اتحادیهای باز (شامل گوگل، نتفلیکس، آمازون و دیگران) توسعه یافته تا از پرداخت حق امتیاز (Royalty) معاف باشد. مهمتر از آن، الگوریتم فشردهسازی آن بسیار هوشمندتر است و میتواند ویدیوهایی با کیفیت مشابه را با حجمی حدود ۳۰ درصد کمتر از VP9 یا H.265 ارائه دهد که برای پخش ویدیو در موبایل و اینترنتهای ضعیفتر انقلابی است.
مشکل فقط تاخیر نیست. اگر هزاران کاربر همزمان از یک سرور واحد درخواست کنند، آن سرور به سرعت اشباع شده و سایت کند یا حتی از دسترس خارج میشود. CDN این دو مشکل را همزمان حل میکند:
کاهش فاصله فیزیکی: محتوا از نزدیکترین نقطه جغرافیایی به کاربر تحویل داده میشود.
توزیع بار ترافیکی: درخواستها بین صدها سرور پخش میشوند و هیچ سرور واحدی تحت فشار قرار نمیگیرد.
CDN چگونه کار میکند؟
معماری CDN بر پایه چند مفهوم کلیدی ساخته شده است:
سرورهای لبه (Edge Servers)
اینها سرورهای کوچکی هستند که در نقاط مختلف جغرافیایی (به نام PoP یا Point of Presence) قرار دارند. وظیفه آنها نگهداری نسخه کش شده از محتوای سایت اصلی است.
فرآیند تحویل محتوا
وقتی کاربری برای اولین بار صفحهای را درخواست میکند، سرور لبه آن را از سرور اصلی (Origin Server) میگیرد، ذخیره میکند و به کاربر تحویل میدهد. درخواستهای بعدی همان صفحه، مستقیماً از سرور لبه پاسخ داده میشوند و دیگر نیازی به ارتباط با سرور اصلی نیست.
قوانین کش (Cache Rules)
مدیر سایت میتواند تعیین کند چه محتوایی کش شود و برای چه مدت. فایلهای استاتیک مثل تصاویر، CSS و جاوا اسکریپت معمولاً برای مدت طولانی کش میشوند، در حالی که محتوای پویا ممکن است اصلاً کش نشود.
انواع CDN بر اساس روش ذخیرهسازی
دو روش اصلی برای تحویل محتوا در CDN وجود دارد:
Pull CDN
در این روش، سرور لبه فقط زمانی محتوا را از سرور اصلی میگیرد که کاربر آن را درخواست کند. یعنی اولین کاربری که از یک منطقه جغرافیایی خاص صفحهای را باز میکند، کمی تاخیر را تجربه میکند، اما کاربران بعدی از همان منطقه سرعت بالایی خواهند داشت. این روش برای سایتهایی با محتوای متنوع و پویا مناسب است.
Push CDN
در این روش، صاحب سایت خودش محتوا را به صورت دستی یا خودکار روی سرورهای لبه آپلود میکند. این روش برای سایتهایی که محتوای ثابت و مشخصی دارند (مثل فایلهای دانلودی یا ویدیوهای از پیش تعیین شده) بهتر عمل میکند و اولین کاربر هم سرعت بالایی را تجربه میکند.
مزایا و معایب استفاده از CDN
مزایا:
افزایش چشمگیر سرعت: کاهش Latency و بارگذاری سریعتر برای کاربران در سراسر جهان.
کاهش هزینه پهنای باند: با کش کردن محتوا، ترافیک سرور اصلی به شدت کاهش مییابد.
مقیاسپذیری بالا: سایت میتواند ترافیکهای ناگهانی و سنگین را بدون مشکل مدیریت کند.
امنیت بیشتر: اکثر CDNهای مدرن دارای فایروال، محافظت در برابر حملات DDoS و گواهینامه SSL رایگان هستند.
بهبود سئو: سرعت بارگذاری یکی از فاکتورهای مهم رتبهبندی گوگل است.
معایب:
هزینه اضافی: برای سایتهای بزرگ با ترافیک بالا، هزینه CDN میتواند قابل توجه باشد.
پیچیدگی پیکربندی: تنظیمات نادرست کش میتواند باعث نمایش محتوای قدیمی به کاربران شود.
وابستگی به سرویسدهنده: در صورت قطعی سراسری CDN، سایت شما نیز از دسترس خارج میشود.
محدودیت در محتوای پویا: صفحاتی که برای هر کاربر متفاوت هستند (مثل داشبورد کاربری) نمیتوانند به راحتی کش شوند.
مقایسه CDN با میزبانی سنتی
در میزبانی سنتی، تمام کاربران دنیا به یک سرور واحد متصل میشوند. این روش برای سایتهای کوچک و محلی کاملاً مناسب است، اما برای سایتهایی با مخاطبان جهانی، با مشکلات سرعت و پایداری مواجه میشود.
CDN در واقع یک لایه اضافی بین کاربر و سرور اصلی است. این دو تکنولوژی رقیب یکدیگر نیستند، بلکه مکمل هماند. شما همچنان به یک سرور اصلی نیاز دارید، اما CDN بار آن را کاهش میدهد و تجربه کاربری را بهبود میبخشد.
ارائهدهندگان معروف CDN
در بازار امروز، چند بازیگر اصلی وجود دارند:
Cloudflare: محبوبترین گزینه برای سایتهای کوچک و متوسط. پلن رایگان آن بسیار قدرتمند است و راهاندازی آن تنها با تغییر DNS امکانپذیر است.
Akamai: یکی از قدیمیترین و بزرگترین ارائهدهندگان CDN که بیشتر برای سازمانهای بزرگ و شرکتهای Enterprise مناسب است.
Fastly: معروف به CDN نسل جدید با قابلیت Real-time Purging. بسیاری از سایتهای بزرگ خبری و استریم از آن استفاده میکنند.
AWS CloudFront: برای کسانی که از زیرساخت آمازون استفاده میکنند، یکپارچگی بینظیری دارد.
BunnyCDN: یک گزینه اقتصادی با کیفیت بالا که در سالهای اخیر بسیار محبوب شده است.
جمعبندی نهایی و نگاه شخصی
به عنوان کسی که سالها با سایتهای مختلف کار کردهام، باید صادقانه بگویم که استفاده از CDN برای هر سایتی که مخاطبان جدی دارد، دیگر یک انتخاب نیست، بلکه یک ضرورت است. خودم شخصاً بعد از فعالسازی Cloudflare روی یکی از سایتهایم، کاهش ۴۰ درصدی زمان بارگذاری را تجربه کردم و این عدد اصلاً کوچک نیست.
با این حال، یک هشدار دوستانه بدهم: CDN جادو نمیکند. اگر سایت شما به دلیل کدهای بهینهنشده، تصاویر سنگین یا کوئریهای دیتابیس کند باشد، CDN فقط بخشی از مشکل را حل میکند. اول سایت خود را بهینه کنید، سپس از CDN به عنوان یک تقویتکننده استفاده کنید.
در نهایت، اگر تازه کار هستید، پیشنهاد میکنم با پلن رایگان Cloudflare شروع کنید. هم ساده است، هم امن و هم تاثیر آن را خیلی سریع مشاهده خواهید کرد.
سوالات متداول
آیا CDN برای سایتهای کوچک هم لازم است؟ برای سایتهای کوچک با مخاطبان محلی، CDN ضروری نیست اما میتواند مزایای امنیتی و سرعتی خوبی ارائه دهد. با پلنهای رایگان مثل Cloudflare، امتحان کردن آن هیچ هزینهای ندارد.
آیا CDN باعث میشود سایت همیشه در دسترس باشد؟ CDN به شدت در برابر حملات DDoS مقاومت میکند و اگر سرور اصلی شما برای لحظاتی از دسترس خارج شود، میتواند محتوای کش شده را تحویل دهد. اما اگر سرور اصلی برای مدت طولانی قطع باشد و محتوای پویا نیاز به دیتابیس داشته باشد، سایت با مشکل مواجه میشود.
آیا CDN روی سئو تاثیر مثبت دارد؟ بله. سرعت بارگذاری یکی از فاکتورهای رسمی رتبهبندی گوگل است و CDN با کاهش Latency و بهبود Core Web Vitals، میتواند به بهبود رتبه سایت کمک کند. همچنین SSL رایگان و محافظت در برابر حملات از دیگر مزایای غیرمستقیم آن برای سئو هستند.
آیا استفاده از CDN باعث میشود کاربران IP ما را نبینند؟ بله، وقتی از CDN استفاده میکنید، کاربران با IP سرورهای لبه CDN ارتباط برقرار میکنند و IP واقعی سرور اصلی شما پنهان میشود. این موضوع یک لایه امنیتی اضافی ایجاد میکند.
سیستم DNS چیست؟
سیستم نام دامنه یا DNS، دقیقاً برای حل همین مشکل طراحی شد. به زبان ساده، DNS دفترچه تلفن اینترنت است.
همانطور که شما شماره تلفن دوستتان را حفظ نیستید و نام او را در دفترچه تلفن جستجو میکنید تا شمارهاش را پیدا کنید، کامپیوتر شما هم نام دامنه (مثل codoloper.com) را به DNS میدهد تا آدرس IP معادل آن را دریافت کند.
این سیستم یک پایگاه داده عظیم، توزیعشده و سلسلهمراتبی در سراسر جهان است. هیچ سرور مرکزی و واحدی وجود ندارد که همه اطلاعات را نگه دارد. این توزیعشدگی باعث میشود اینترنت هرگز به دلیل خرابی یک سرور متوقف نشود.
DNS چگونه کار میکند؟
وقتی آدرسی را در مرورگر وارد میکنید، یک فرآیند چندمرحلهای و بسیار سریع آغاز میشود. بیایید این مسیر را قدم به قدم بررسی کنیم.
مراحل یک جستجوی DNS
۱. بررسی حافظه نهان (Cache): قبل از هر چیز، مرورگر و سیستم عامل شما بررسی میکنند که آیا آدرس IP این دامنه را قبلاً ذخیره کردهاند یا خیر. اگر پیدا شد، کار در همان لحظه تمام میشود.
۲. ارسال درخواست به Resolver: اگر در کش محلی نبود، درخواست به یک سرور DNS Resolver (معمولاً متعلق به ارائهدهنده اینترنت شما یا ISP) ارسال میشود. این سرور وظیفه دارد کل فرآیند جستجو را برای شما انجام دهد.
۳. مراجعه به سرور ریشه (Root Server): اگر Resolver هم آدرس را نداشت، به یکی از سرورهای ریشه در جهان مراجعه میکند. سرور ریشه آدرس را نمیداند، اما میداند که برای پیدا کردن پسوند com. باید به کجا مراجعه کند.
۴. مراجعه به سرور TLD: Resolver حالا به سرور TLD (Top-Level Domain) مخصوص com. میرود. سرور TLD هم آدرس دقیق را نمیداند، اما آدرس سرور مرجعی که مسئول دامنه شماست را در اختیار Resolver قرار میدهد.
۵. مراجعه به سرور مرجع (Authoritative Server): در مرحله آخر، Resolver به سرور مرجع دامنه شما متصل میشود. این سرور دقیقاً میداند که IP معادل نام دامنه شما چیست. آن را به Resolver برمیگرداند.
۶. ذخیره و تحویل: Resolver آدرس IP را در حافظه کش خود ذخیره میکند (برای درخواستهای بعدی) و آن را به مرورگر شما تحویل میدهد.
بعد از DNS: وقتی آدرس را پیدا کردیم
بسیاری از افراد فکر میکنند با پیدا شدن IP، کار تمام است. اما DNS فقط خط شروع مسابقه است. بعد از اینکه مرورگر IP سرور مقصد را به دست آورد، اتفاقات زیر رخ میدهد:
۱. ارتباط TCP: مرورگر یک اتصال TCP با سرور مقصد برقرار میکند تا از رسیدن صحیح دادهها اطمینان حاصل کند. ۲. دستدهی امنیتی (TLS/SSL): اگر سایت از پروتکل HTTPS استفاده کند، یک رمزنگاری امن بین مرورگر و سرور برقرار میشود. ۳. ارسال درخواست HTTP: مرورگر درخواست صفحه وب را به سرور میفرستد. ۴. دریافت پاسخ: سرور فایلهای HTML، CSS و جاوا اسکریپت را برمیگرداند و مرورگر آنها را رندر میکند.
بنابراین، DNS فقط وظیفه ترجمه نام به عدد را دارد و بقیه مسیر بر عهده پروتکلهای دیگر شبکه است.
مقایسه DNS سنتی با روشهای مدرن
DNS سنتی که در پورت ۵۳ کار میکند، سالهاست استفاده میشود. اما یک مشکل بزرگ دارد: ترافیک آن رمزنگاری نشده و به صورت متن ساده (Plain Text) ارسال میشود. این موضوع باعث مشکلات امنیتی و حریم خصوصی میشود.
به همین دلیل، پروتکلهای جدیدی معرفی شدهاند:
DoT (DNS over TLS): ترافیک DNS را از طریق پروتکل امن TLS رمزنگاری میکند.
DoH (DNS over HTTPS): ترافیک DNS را درون ترافیک HTTPS پنهان میکند. این روش باعث میشود ارائهدهندگان اینترنت نتوانند به راحتی درخواستهای DNS شما را رصد یا مسدود کنند.
در حالی که DNS سنتی سرعت بالاتری دارد (به دلیل سربار کمتر)، روشهای مدرن مثل DoH امنیت و حریم خصوصی بسیار بهتری را ارائه میدهند.
مزایا و چالشهای سیستم DNS
مزایا:
سهولت استفاده: نیاز به حفظ کردن اعداد پیچیده را از بین میبرد.
مقیاسپذیری: به دلیل ساختار توزیعشده، با رشد اینترنت هیچ مشکلی پیدا نمیکند.
انعطافپذیری: میتوانید IP سرور خود را تغییر دهید بدون اینکه کاربران نیاز باشد آدرس دامنه را تغییر دهند.
چالشها:
آسیبپذیری امنیتی: حملاتی مانند DNS Spoofing یا DNS Cache Poisoning میتوانند کاربران را به سایتهای جعلی هدایت کنند.
تاخیر (Latency): اگر سرور DNS Resolver کند باشد یا کش خالی باشد، چند میلیثانیه تاخیر در بارگذاری سایت ایجاد میشود.
حملات DDoS: سرورهای ریشه و TLD همواره در معرض حملات منع سرویس هستند.
جمعبندی نهایی و نگاه شخصی
به عنوان یک توسعهدهنده، همیشه وقتی به معماری DNS فکر میکنم، شگفتزده میشوم. ما هر روز دهها بار از آن استفاده میکنیم، اما تا زمانی که خراب نشود، متوجه حضورش نمیشویم. DNS یک شاهکار مهندسی است که توانست هرج و مرج روزهای اولیه اینترنت را به یک سیستم منظم و جهانی تبدیل کند.
صادقانه بگویم، اگرچه پروتکلهای جدید مثل DoH امنیت را بالا بردهاند، اما هنوز هم پیچیدگیهای مدیریت DNS برای کسبوکارهای بزرگ چالشبرانگیز است. با این حال، درک عمیق از نحوه کار DNS، نه تنها دید شما را به شبکه باز میکند، بلکه در عیبیابی مشکلات شبکه و سرور به شدت به شما کمک خواهد کرد. امیدوارم این مقاله توانسته باشد تصویر روشنی از این سیستم حیاتی در ذهن شما ایجاد کند.
سوالات متداول
چرا باید DNS پیشفرض خود را به 8.8.8.8 یا 1.1.1.1 تغییر دهیم؟ تغییر DNS به سرورهای عمومی مثل گوگل (8.8.8.8) یا کلادفلر (1.1.1.1) معمولاً به دو دلیل انجام میشود: اول، افزایش سرعت به دلیل زیرساخت قویتر این شرکتها، و دوم، دور زدن محدودیتها و جلوگیری از ردیابی درخواستهای DNS توسط ارائهدهنده اینترنت محلی.
منظور از DNS Propagation یا انتشار DNS چیست؟ وقتی رکوردهای DNS یک دامنه را تغییر میدهید، این تغییر بلافاصله در تمام سرورهای جهان اعمال نمیشود. سرورهای مختلف در سراسر جهان بر اساس زمان TTL (Time to Live) کش خود را آپدیت میکنند. این پروسه که به آن انتشار DNS میگویند، ممکن است از چند دقیقه تا ۴۸ ساعت طول بکشد.
آیا DNSSEC همان رمزنگاری DNS است؟ خیر. DNSSEC (Domain Name System Security Extensions) برای رمزنگاری ترافیک طراحی نشده است، بلکه برای امضای دیجیتال دادههای DNS استفاده میشود. DNSSEC تضمین میکند که آدرس IP دریافتی واقعاً متعلق به همان دامنه است و در مسیر دستکاری نشده است. برای رمزنگاری خود ترافیک باید از DoH یا DoT استفاده کنید.
از تجربهی شخصی: ArvanCloud برای مدت طولانی مطمئنترین انتخاب بود، ولی اخیراً Liara هم عملکرد بهتری داشته. هر دو رو چک کن و ببین کدوم توی لحظهای که داری کار میکنی بهتر جواب میده.
۳. میرور پکیج منیجرهای اپلیکیشن
باید مطمعن بشی که هر پکیج منیجری که استفاده میکنی داره از میرور های داخل ایران استفاده میکنه.
مثال میزنم اگر از npm استفاده میکنی برای پکیج های جاوا اسکریپتی / تایپ اسکریپتی باید بری میرور ایران ان پی ام رو پیدا کنی و ست کنی. چیزایی که الان کار میکنن لیارا و رانفلر هستند اما از اونجایی که رانفلر پول میگیره فقط در صورتی استفاده کنید که خیلی سرعت براتون مهمه وگرنه میرور های دیگه کارتون راه میندازن.
از پی اچ چی دارید و از کامپوزر استفاده میکنید همینطور.
کارگو برای راست. ناگت برای سی شارپ و هر چیزی خلاصه ببینید پکیج منیجرتون چیه و میرورشو به روشی که توضیح میدن ست کنید.
اگر پکیج منیجرتون لینک دانلود و یا وریفای پکیج هارو ذخیره میکنه در جایی - مثلا npm در package-lock اینکارو میکنه - مطمعن شید که اون لینک ها هم آپدین شدن مثلا برای ان پی ام:
اینجاست که ماجرا کمی دردسرتر میشه. مثلاً آرچ PostgreSQL 17 به بعد رو توی repo رسمیش نداره. معمولاً باید میرور رسمی خود PostgreSQL رو اضافه کنی — ولی اون میرور از ایران جواب نمیده.
راهحل: به devneeds.ir مراجعه کن. میرور ایرانی از نسخههای مختلف PostgreSQL اونجا هست که از نت ملی هم پاسخگوئه.
برای اوبونتو، PostgreSQL repository رسمی معمولاً توی apt بدون مشکل کار میکنه — ولی اگه روی نت ملی isolated هستی، اینجا هم باید میرور ایرانی پیدا کنی.
۵. تست روی سیستم خودت قبل از deploy
یه قدم که خیلیها رد میکنن اینه که همهی این تنظیمات رو روی ماشین محلی خودت هم چک کنی. اگه روی ماشین خودت با همین میرورها npm install بزنی و همه چیز دانلود بشه، با اطمینان بیشتری میتونی روی سرور هم همین کار رو بکنی.
این یه شبیهسازی سادهست: مطمئن میشی که lockfile ها درست هستن و هیچ dependency ای نیست که فقط از خارج قابل دسترسه.
SSL روی سرور ایرانی
این یه بحث جداست — و صادقانه بگم، راحت نیست. Let's Encrypt از ایران مشکل داره، و خیلی از راهحلهای خودکار SSL روی شبکهی ملی کار نمیکنن. devneeds.ir مستندات مربوط به ست کردن SSL در این شرایط رو داره — بهتره مستقیم از اونجا بخونی چون وضعیت ممکنه تغییر کرده باشه و اطلاعات بهروز باشه.
شوخی نیست — دردسره. ولی مجبوریم.
خلاصهی checklist
قبل از deploy روی هر سرور ایرانی:
میرور توزیع لینوکس → devneeds.ir یا ArvanCloud
میرور Docker daemon → ArvanCloud یا Liara
میرور پکیج منیجرها (npm، pip، Composer و بقیه) → liara.ir/mirrors
lockfile ها رو پاک و rebuild کن تا لینکها آپدیت بشن
پایگاه دادههای خارج از repo سیستم عامل → devneeds.ir چک کن
روی ماشین محلی با همین میرورها تست کن قبل از deploy
اگه اینها رو انجام بدی، احتمال اینکه deploy ات بدون مشکل بره بالاست — و مهمتر از اون، اگه یه روز نت قطع شد، میتونی بدون وابستگی به اینترنت خارجی آپدیت و نگهداری کنی. این آمادگی نباید ضروری باشه، ولی متأسفانه هست.
AI توی debugging هم کمک میکنه — ولی فقط اگه بدونی چه اطلاعاتی بهش بدی. اگه ندونی دنبال چی میگردی، error log رو copy میکنی توی chat و امیدوار میشی مدل جواب بده. گاهی میده. ولی این یه روش قابل اعتماد نیست.
یه نقطهی ظریف دربارهی سرعت
یه غلطفهمی وجود داره که «اصول یاد گرفتن» یعنی زمان زیادی میبره و در آخر هم مستقیماً استفاده نمیشه. ولی اصول قراره چیزی باشن که دیگه بهشون فکر نمیکنی — اتوماتیک تبدیل میشن به شهود.
وقتی یه توسعهدهنده باتجربه یه codebase جدید رو میبینه، میفهمه مشکل architecture کجاست — نه بهخاطر اینکه یه checklist داره، بلکه چون دیدهها و تجربههاش به یه حس تبدیل شدن. این همون چیزیه که با AI codingهای سطحی از دست میره.
هرچقدر اصول قویتر باشن، از AI هم بهتر استفاده میکنی. چون prompt های بهتری مینویسی، خروجی رو بهتر ارزیابی میکنی، و زودتر میفهمی کِی باید از مدل کمک بخوای و کِی باید خودت فکر کنی.
اصول چه چیزی نیستن
اینجا یه تفاوت مهم هست که باید مشخص بشه: یاد گرفتن اصول با حفظ کردن syntax یه زبان یا دونستن تمام APIهای یه فریمورک فرق داره. دومی رو الان واقعاً AI بهتر از تو میدونه. اگه نمیدونی Array.reduce چطور کار میکنه، بپرس. اگه نمیدونی کدوم CSS property برای این استفاده میشه، بپرس.
ولی اینکه چرا state management پیچیده میشه، چرا database query ات کند شده، چرا این race condition فقط توی production اتفاق میافته — اینا رو باید بفهمی. اینا قراره بخشی از طرز فکر تو بشن، نه اینکه هر بار از صفر از مدل بپرسی.
جواب سوال اول
پس چرا باید اصول یاد بگیری؟
نه برای اینکه AI کدت رو بنویسه و تو باید بدونی که نوشته. نه برای اینکه شاید یه روز AI نباشه — هست و بیشتر هم میشه.
بلکه چون کار یه توسعهدهنده همیشه بیشتر از نوشتن کد بوده. طراحی سیستم، تصمیمگیری، تشخیص مشکل، ارزیابی trade-off ها — اینا هنوز جایی هستن که ابزار جایگزین فکر نمیشه. AI سرعت رو بالا میبره، ولی اگه نقطهی شروع ضعیف باشه، فقط سریعتر به جای اشتباه میرسی.
اصول یاد میگیری تا بتونی از AI درست استفاده کنی — نه بهرغم اینکه AI هست.