قضیهی CAP: چرا هیچ دیتابیس توزیعشدهای نمیتونه همهچیز رو با هم داشته باشه
حدود ۵ دقیقه مطالعه
یه بار که داری بین چند تا دیتابیس توزیعشده (مثل Cassandra، MongoDB، یا CockroachDB) یکی رو انتخاب میکنی، دیر یا زود به یه جمله میرسی که همه جا تکرار میشه: «این دیتابیس CP هست» یا «اون یکی AP هست». اگه پشت این حرفها ندونی چه مصالحهای واقعاً داره اتفاق میافته، خیلی راحت ممکنه دیتابیسی رو انتخاب کنی که دقیقاً برعکس چیزیه که سیستمت بهش نیاز داره.
سه ضلع قضیه
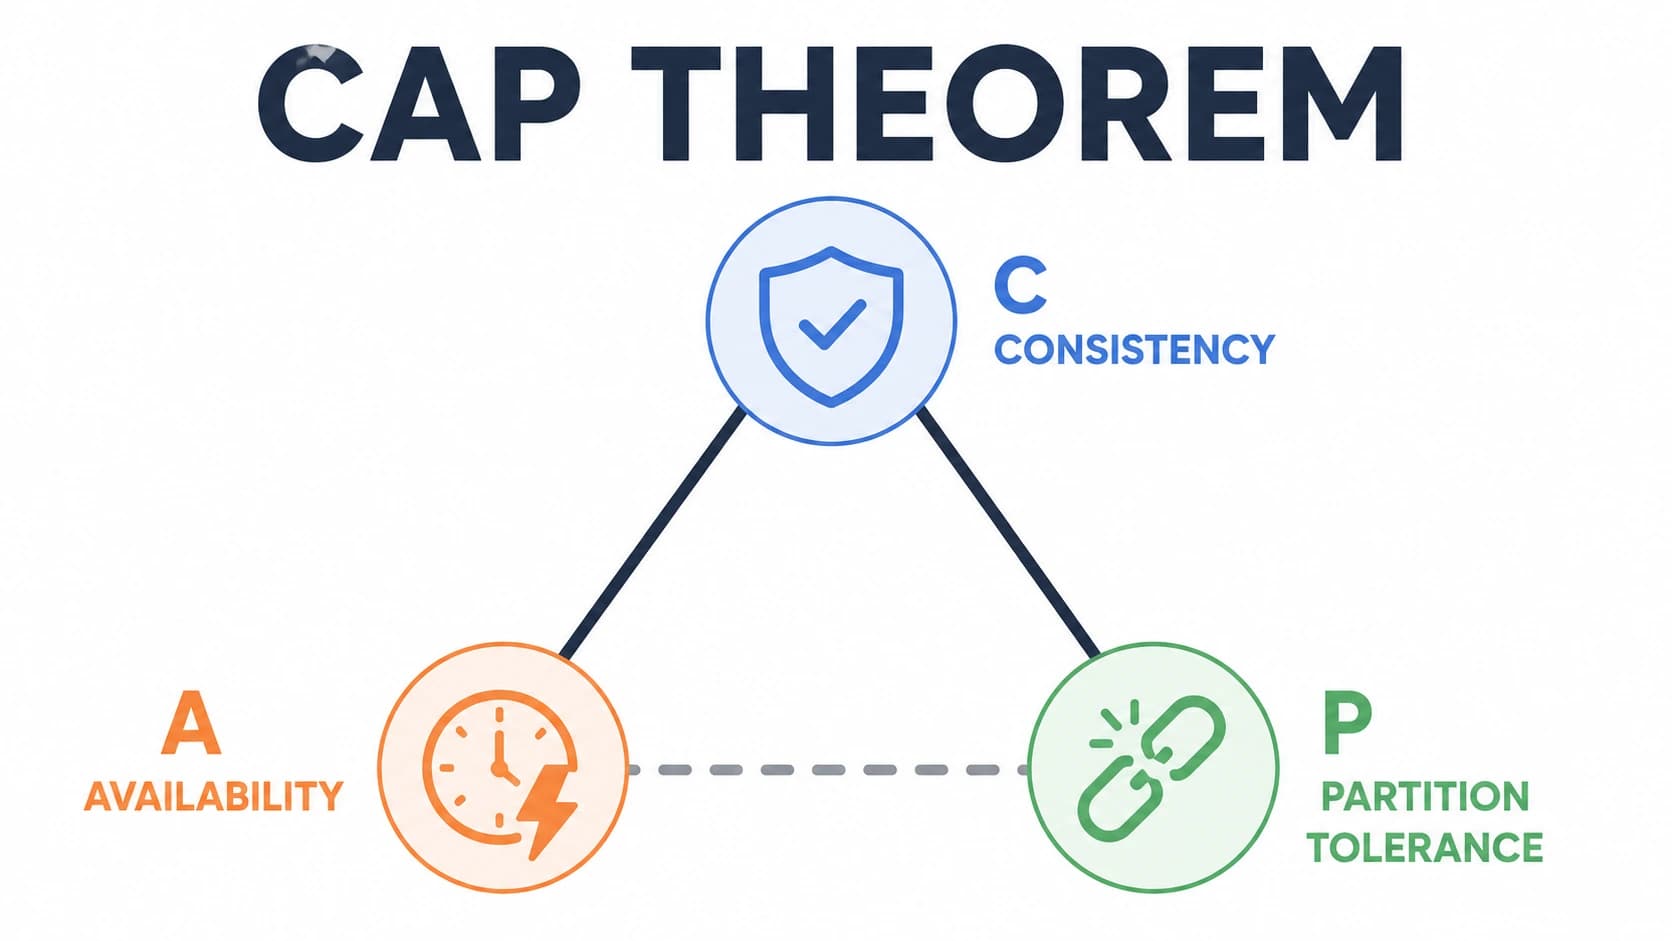
قضیهی CAP (که اریک برور اولین بار مطرحش کرد) میگه یه سیستم دیتابیس توزیعشده، وقتی network partition اتفاق میافته (یعنی ارتباط بین بخشی از node ها قطع میشه)، فقط میتونه یکی از این دو تا رو تضمین کنه، نه هر دو رو با هم:
Consistency: هر خواندنی، آخرین نوشتهی موفق رو برمیگردونه. یعنی همهی node ها همیشه یه نسخهی یکسان و بهروز از داده رو نشون میدن.
Availability: هر درخواستی (چه خواندن، چه نوشتن) یه جواب دریافت میکنه، حتی اگه بعضی node ها از کار افتاده باشن. سیستم هیچوقت با یه خطا جواب رد نمیده.
ضلع سومِ قضیه، Partition tolerance است: توانایی سیستم برای ادامهی کار حتی وقتی شبکه بین node ها قطع میشه. نکتهی مهم اینجاست که partition tolerance تو دنیای واقعی یه انتخاب نیست؛ شبکه دیر یا زود قطع میشه، پس هر سیستم توزیعشدهی واقعی باید partition tolerant باشه. این یعنی انتخاب واقعی همیشه بین C و A است، نه بین سهتا گزینه.
یعنی چی وقتی partition اتفاق میافته؟
فرض کن یه کلاستر سهnode ای داری و ارتباط شبکه بین node یک با node های دو و سه قطع میشه. حالا دو گروه جدا از هم داری. وقتی یه کلاینت به node یک درخواست نوشتن میفرسته، دو مسیر پیش رو داری:
اگه سیستم انتخاب کنه Consistency رو حفظ کنه (CP)، node یک باید درخواست رو رد کنه یا صبر کنه، چون نمیتونه مطمئن بشه node های دیگه هم همین مقدار رو دارن. کاربر یه خطا میگیره، ولی داده هیچوقت inconsistent نمیشه.
اگه سیستم انتخاب کنه Availability رو حفظ کنه (AP)، node یک همون لحظه به کاربر جواب میده و نوشتن رو قبول میکنه، حتی اگه ندونه node های دیگه چه مقداری دارن. بعداً وقتی partition برطرف شد، سیستم باید یه مکانیزم برای reconcile کردن این تناقضها داشته باشه (مثلاً last-write-wins یا vector clocks).
چند تا مثال واقعی
MongoDB بهصورت پیشفرض بیشتر به سمت CP گرایش داره؛ وقتی primary node در دسترس نباشه یا اکثریت replica ها قابلدسترس نباشن، نوشتنها متوقف میشن تا consistency حفظ بشه.
Cassandra طراحیش از پایه AP-محور بوده؛ همیشه به درخواستها جواب میده، حتی اگه بعضی replica ها هنوز بهروز نشده باشن، و از مدل eventual consistency استفاده میکنه.
CockroachDB و Google Spanner سعی میکنن با استفاده از الگوریتمهای consensus مثل Raft یا Paxos، در اکثر شرایط هر دو رو تا حد ممکن نزدیک هم نگه دارن، ولی باز هم زیر پوستشون، وقتی واقعاً partition جدی اتفاق بیفته، اولویت رو به consistency میدن.
چرا این مدل سادهشده هم کامل نیست
یه نقد رایج به CAP اینه که این مدل بیشازحد سادهست، چون partition ها همیشه یا کامل هستن یا اصلاً نیستن، در حالی که تو دنیای واقعی شبکه معمولاً بهجای قطع کامل، فقط کند میشه یا packet loss داره. برای همین، یه فریمورک تکمیلی به اسم PACELC مطرح شده که میگه: در حالت Partition، بین Availability و Consistency انتخاب کن (همون CAP)، ولی حتی وقتی partition نداری (Else)، بین Latency و Consistency هم باید یه مصالحه انجام بدی. یعنی حتی تو حالت عادی شبکه، دیتابیسهایی مثل Cassandra ترجیح میدن latency پایینتری بدن به قیمت consistency ضعیفتر، در حالی که چیزی مثل Spanner حاضره latency بیشتری رو تحمل کنه تا consistency قویتری داشته باشه.
این یعنی چی برای انتخاب دیتابیس
وقتی داری معماری یه سیستم رو طراحی میکنی، سؤال درست این نیست که «کدوم دیتابیس بهتره؟»، بلکه اینه که «سیستمم چه چیزی رو نمیتونه تحمل کنه؟» برای یه سیستم بانکی که موجودی حساب رو مدیریت میکنه، نشون دادن یه مقدار قدیمی یا اشتباه فاجعهباره؛ پس CP منطقیتره، حتی اگه یعنی بعضی وقتها کاربر با تأخیر مواجه بشه. ولی برای چیزی مثل تعداد لایک یه پست تو شبکهی اجتماعی، اگه چند ثانیه یه عدد قدیمیتر نشون داده بشه هیچ فاجعهای اتفاق نمیافته، ولی اگه کل سایت پایین بیاد چون یه node قطع شده، تجربهی کاربری خیلی بدتری رقم میخوره. اینجا AP انتخاب درستتریه.
نکتهی آخر اینکه CAP فقط دربارهی رفتار سیستم زیر partition حرف میزنه، نه دربارهی performance عمومی یا مقیاسپذیری. یه دیتابیس میتونه CP باشه و همچنان خیلی سریع و مقیاسپذیر باشه؛ این دو مفهوم کاملاً مستقل از هم هستن و نباید با هم قاطی بشن.