آیا واستون سؤال شده که مثلاً ChatGPT یا Gemini چطوری با اینکه یه LLM هستن و منطقا فقط باید بتونن متن ورودی بگیرن، عکس شما رو میفهمن؟
مثلاً شما یه عکس به ChatGPT میدین و میپرسین «توی این عکس چی میبینی؟» و مدل هم شروع میکنه دربارهی عکس توضیح دادن.
اینجا یه سؤال طبیعی پیش میاد:
آیا یه ابزار جداگانه وجود داره که اول عکس رو به متن تبدیل کنه و بعد اون متن رو بده به LLM؟
مثلاً عکس رو بگیره، تشخیص بده «یه گربه روی صندلی نشسته» و بعد این جمله رو به مدل زبانی بده؟
خیر.
ماجرا این شکلی نیست.
پس عکس چطوری وارد LLM میشه؟
برای فهمیدن این موضوع باید یه چیز رو دربارهی LLMهای جدید کنار بذاریم: اینکه LLM لزوماً فقط متن میگیره.
مدلهایی مثل GPT و Gemini در نسخههای Multimodal میتونن با چند نوع ورودی مختلف کار کنن. یعنی در کنار متن، میتونن تصویر و حتی ورودیهایی مثل صدا و ویدئو رو هم پردازش کنن.
ولی خب هنوز یه سؤال مهم باقی میمونه.
مدل زبانی که با عدد و توکن و embedding کار میکنه، دقیقاً با یه عکس چه کار میکنه؟
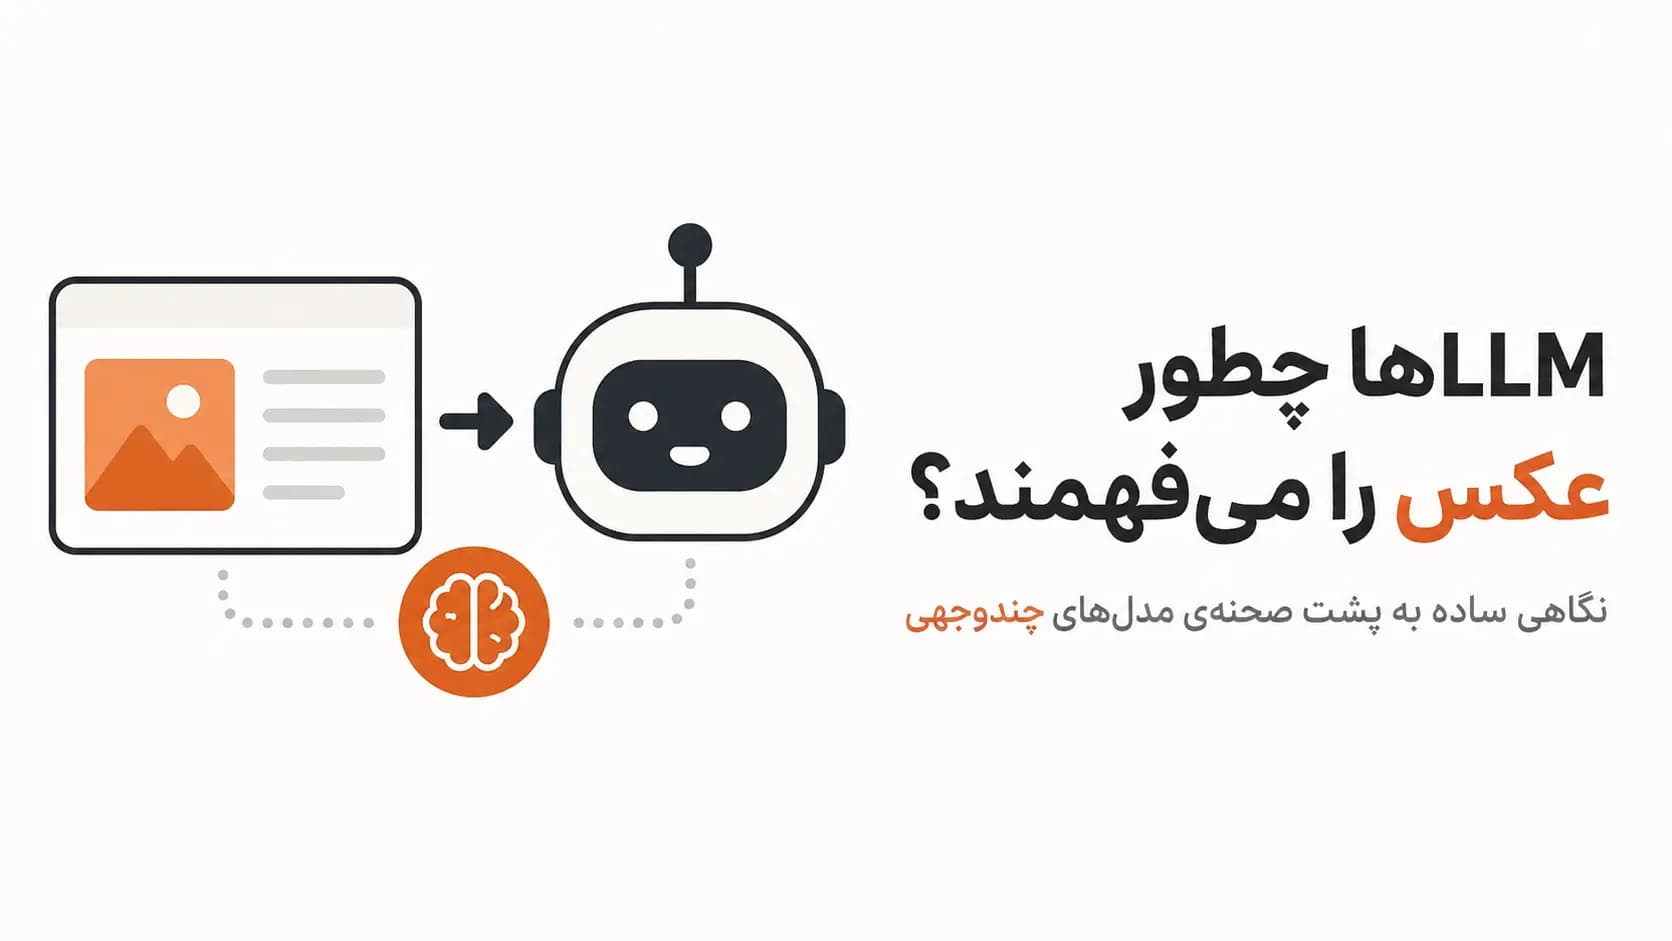
اینجا پای یه بخش دیگه از مدل وسط میاد که معمولاً بهش Vision Encoder یا Image Encoder میگن.
Image Encoder چه کار میکنه؟
تصویری که شما آپلود میکنید، برای کامپیوتر در نهایت یه عالمه عدد مربوط به پیکسلهاست.
اما اینکه همین اعداد خام رو بندازیم جلوی LLM و انتظار داشته باشیم بفهمه توی عکس چه خبره، طبیعتاً جواب نمیده.
پس اول تصویر وارد Image Encoder میشه.
Image Encoder یه مدل بیناییه که از روی تصویر سعی میکنه اطلاعات مهم اون رو استخراج کنه. مثلاً اینکه چه شکلهایی توی تصویر وجود دارن، چه الگوهایی دیده میشن و بخشهای مختلف تصویر چه ارتباطی با هم دارن.
معمولاً اینجا با معماریهایی مثل Vision Transformer یا ViT سروکار داریم.
خروجی هم دیگه خود عکس نیست. تصویر تبدیل میشه به یه سری بردار عددی یا Embedding که اطلاعات تصویر رو در خودشون نگه میدارن.
یعنی تا اینجا تقریباً داریم:
عکس → Image Encoder → Embeddingهای تصویری
اما هنوز یه مشکل وجود داره.
مشکل اینجاست که زبان و تصویر یکی نیستن
برای متن هم یه چیزی شبیه همین اتفاق میافته.
متنی که شما مینویسید اول توسط Tokenizer به توکنها تقسیم میشه و بعد این توکنها به embedding تبدیل میشن.
پس الان دو طرف داریم:
متن → Tokenizer → Embedding متنی
و
عکس → Image Encoder → Embedding تصویری
ولی این دو embedding الزاماً توی یه فضای مشترک نیستن.
اینجاست که Projection وارد داستان میشه.
Projection؛ پلی بین تصویر و متن
Projection رو میشه خیلی ساده مثل یه پل در نظر گرفت.
ویژگیهایی که از تصویر استخراج شدن، از طریق این بخش به شکلی تبدیل میشن که برای مدل زبانی قابل استفاده باشن.
در نتیجه اطلاعات تصویر میتونه در کنار اطلاعات متنی وارد فرایند پردازش مدل بشه.
یعنی بهصورت خیلی ساده:
عکس → Vision Encoder → Projection → مدل زبانی
و همزمان:
متن → Tokenizer → مدل زبانی
حالا مدل میتونه این دو نوع اطلاعات رو کنار هم داشته باشه.
مثلاً فرض کنید یه عکس از یه خیابون به ChatGPT میدید و میپرسید:
«چه ماشینی سمت راست تصویر پارک شده؟»
مدل لازم نیست اول عکس رو به یه جملهی ساده مثل «یک خیابون با یک ماشین در آن وجود دارد» تبدیل کنه.
اطلاعات تصویری به شکل embedding وارد سیستم شده و مدل میتونه اون رو در کنار سؤال شما پردازش کنه.
به همین دلیله که میتونید سؤالهای خیلی دقیقتری هم بپرسید:
«رنگ ماشین سمت راست چیه؟»
«چند نفر توی تصویر هستن؟»
«این نمودار چی رو نشون میده؟»
یا حتی:
«کد داخل این اسکرینشات چه مشکلی داره؟»
پس ChatGPT واقعاً عکس رو میبینه؟
خب، اینجا باید یه کم مراقب کلمهی «دیدن» باشیم.
ChatGPT به معنای انسانی کلمه عکس رو نمیبینه. چیزی که اتفاق میافته اینه که تصویر از طریق بخش بینایی مدل به یه نمایش عددی تبدیل میشه و این اطلاعات به شکلی در اختیار مدل زبانی قرار میگیره که بتونه روی اونها کار کنه.
از طرف دیگه، متن سؤال شما هم به توکنها و embedding تبدیل میشه.
مدل در نهایت با ترکیبی از این اطلاعات سروکار داره و بر اساس اونها پاسخ تولید میکنه.
پس چیزی که از بیرون شبیه اینه که:
«عکس رو دادم → مدل عکس رو دید → جواب داد»
در پشت صحنه خیلی بیشتر شبیه اینه:
«عکس رو دادم → بخش بینایی اون رو به نمایش عددی تبدیل کرد → این اطلاعات با ورودی متنی ترکیب شد → مدل زبانی بر اساس هر دو پاسخ تولید کرد.»
پس Multimodal دقیقاً یعنی چی؟
اسم Multimodal از همینجا میاد.
مودالیتی یا Modality یعنی نوع یا شکل اطلاعات.
متن یه modality محسوب میشه، تصویر یه modality دیگه، صدا هم یکی دیگه.
مدلهای چندوجهی بهجای اینکه فقط با یک نوع اطلاعات کار کنن، طوری طراحی شدن که بتونن چند نوع اطلاعات مختلف رو دریافت و با هم استفاده کنن.
و این دقیقاً همون چیزیه که باعث میشه بتونید یه عکس، یه سؤال متنی و حتی در بعضی مدلها فایل صوتی یا ویدئو رو به سیستم بدید و انتظار داشته باشید همهی اینها رو در کنار هم درک کنه.
یه نکته مهم
البته نباید تصور کنیم که همهی مدلهای Multimodal دقیقاً همین معماری رو دارن.
GPT، Gemini و مدلهای دیگه ممکنه از روشهای متفاوتی برای پردازش تصویر و وصل کردن اطلاعات تصویری به مدل زبانی استفاده کنن.
اما ایدهی کلی همینه:
تصویر مستقیماً به یک جملهی متنی تبدیل نمیشه؛ اول به یک نمایش عددی تبدیل میشه که مدل بتونه باهاش کار کنه.
بنابراین دفعهی بعد که یه عکس رو به ChatGPT میدید و ازش دربارهی جزئیات اون سؤال میکنید، پشت این قابلیت یه «عکس به متن» ساده وجود نداره.
یه مدل بینایی، embedding، projection و در نهایت یه مدل زبانی بزرگ دارن با هم کار میکنن تا چیزی که برای ما شبیه «فهمیدن عکس» به نظر میرسه، اتفاق بیفته.