Message Queue چیه و چرا هر برنامهنویسی باید باهاش آشنا باشه
حدود ۶ دقیقه مطالعه
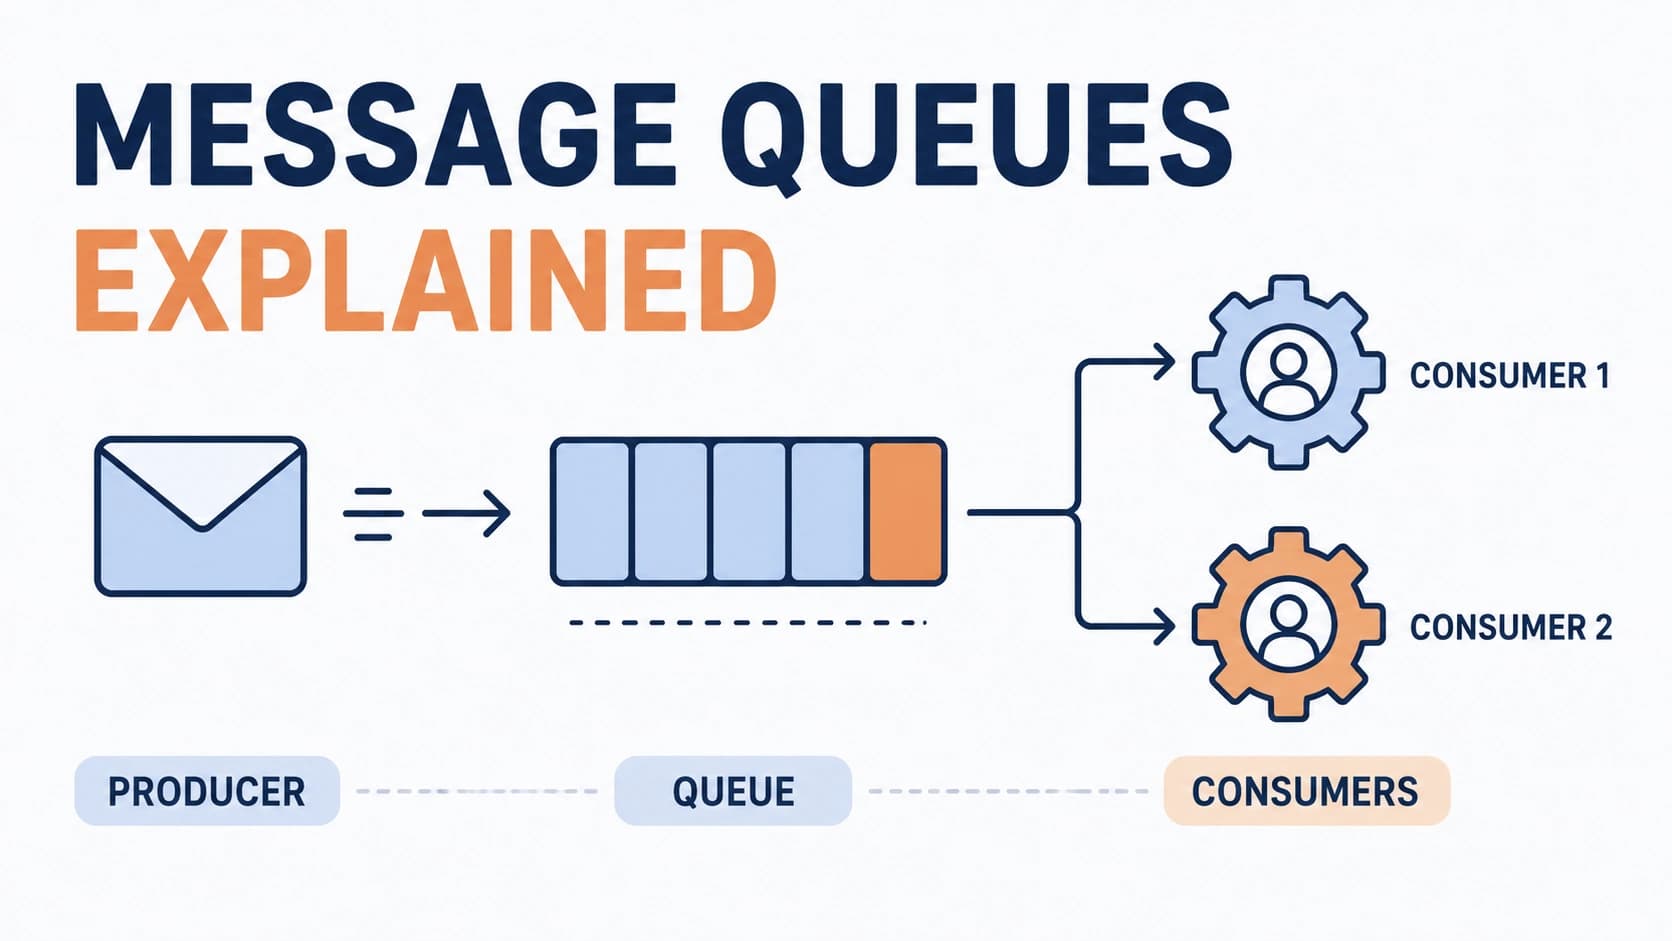
یه سناریوی خیلی رایج رو تصور کن: کاربر روی دکمه «ثبتنام» کلیک میکنه، سرور باید یوزر رو تو دیتابیس بسازه، یه ایمیل خوشآمدگویی بفرسته، یه گزارش برای تیم مارکتینگ بسازه و شاید یه پیامک هم بده. اگه همهی این کارها رو تو همون request-response انجام بدی، کاربر باید چند ثانیه منتظر بمونه تا SMTP جواب بده، و اگه سرویس ایمیل یه لحظه کند بشه یا قطع بشه، کل ثبتنام fail میشه. این دقیقاً جایی است که message queue وارد بازی میشه.
ایدهی اصلی چیه
به زبان ساده، message queue یه واسطه است بین بخشی از سیستم که کار رو تولید میکنه (producer) و بخشی که اون کار رو انجام میده (consumer). بهجای اینکه producer مستقیم consumer رو صدا بزنه و منتظر جواب بمونه، یه پیام رو تو صف میذاره و میره سراغ کار بعدی. consumer هر وقت آماده بود، پیام رو از صف برمیداره و پردازش میکنه.
این جدایی زمانی (decoupling) دقیقاً همون چیزی است که مشکل بالا رو حل میکنه. سرور فقط یه پیام کوچیک میفرسته به صف با مضمون «این یوزر ثبتنام کرد، کارهای بعدیش رو انجام بده» و بلافاصله به کاربر جواب میده. یه worker جدا، پشت صحنه، ایمیل و پیامک و گزارش رو مدیریت میکنه. اگه سرویس ایمیل قطع باشه، پیام تو صف میمونه تا وقتی که سرویس برگرده.
چرا فقط یه تابع async کافی نیست
اینجا سؤال منطقی پیش میاد: چرا از یه thread pool یا background job ساده تو خود اپلیکیشن استفاده نکنیم؟ جواب اینه که queue واقعی چند تا امتیاز اضافه میده که یه goroutine یا thread ساده نداره:
پایداری (durability): اگه سرور کرش کنه، پیامهایی که تو حافظهی یه thread pool بودن از بین میرن. ولی پیامهایی که تو RabbitMQ یا Kafka نوشته شدن، روی دیسک persist میشن و بعد از ریستارت هم سر جاشون هستن.
مقیاسپذیری مستقل: میتونی producer و consumer رو کاملاً جدا از هم scale کنی. اگه صف پر شد، فقط تعداد worker ها رو زیاد میکنی، بدون اینکه به API لایه دست بزنی.
retry و backoff: اکثر broker ها مکانیزم retry دارن. اگه consumer یه لحظه fail بشه (مثلاً دیتابیس موقتاً در دسترس نبود)، پیام دوباره به صف برمیگرده و بعد از چند ثانیه دوباره تلاش میشه، بدون اینکه خودت این منطق رو از صفر بنویسی.
چند تا الگوی رایج
یه چیزی که تو مستندات خیلی جاها ساده جلوه داده میشه ولی تو عمل مهمه، تفاوت بین الگوهای مختلف صفبندیه:
Point-to-point (work queue): یه صف داریم و چند تا consumer که هر پیام فقط توسط یکی از اونها پردازش میشه. مناسب کارهایی مثل پردازش تصویر، ارسال ایمیل، یا هر کاری که باید دقیقاً یکبار انجام بشه.
# producer با pika (کلاینت RabbitMQ برای پایتون)
import pika

connection = pika.BlockingConnection(pika.ConnectionParameters('localhost'))
channel = connection.channel()
channel.queue_declare(queue='email_tasks', durable=True)

channel.basic_publish(
    exchange='',
    routing_key='email_tasks',
    body='{"user_id": 42, "type": "welcome_email"}',
    properties=pika.BasicProperties(delivery_mode=2)  # پیام روی دیسک persist بشه
)
Publish-subscribe: پیام به یه exchange یا topic فرستاده میشه و همهی subscriber ها (نه فقط یکی) یه کپی از اون رو میگیرن. برای رویدادهایی که چند تا سرویس مختلف باید بهشون واکنش نشون بدن مناسبه؛ مثلاً وقتی سفارشی ثبت میشه، هم سرویس انبار باید بدونه، هم سرویس ایمیل، هم آنالیتیکس.
Kafka خودش رو بیشتر حول همین مدل ساخته، با این تفاوت که پیامها بعد از مصرف حذف نمیشن و میتونن دوباره از اول خونده بشن — که این برای event sourcing یا replay کردن دادهها خیلی بهدردبخوره.
RabbitMQ یا Kafka؟
این سؤالی است که تو تقریباً هر تیمی یه بار مطرح میشه و جواب قطعی نداره، به این دلیل که این دو تا اصلاً برای یه هدف ساخته نشدن.
RabbitMQ یه message broker سنتیه، قوی تو routing پیچیده (exchange های direct، topic، fanout)، و مناسب وقتیه که کارها (task) داری که باید دقیقاً یکبار پردازش بشن و ترتیبشون خیلی حیاتی نیست. برای صفهای کاری معمولی، جواب میده و راهاندازیش هم نسبتاً سادهست.
Kafka بیشتر یه distributed log هست تا یه صف کلاسیک. throughput خیلی بالاتری داره، پیامها رو برای مدت طولانی نگه میداره، و برای stream processing و جایی که چند consumer باید مستقل از هم همون داده رو بخونن (و شاید بعداً دوباره بخونن) طراحی شده. ولی overhead عملیاتیش بیشتره؛ نیاز به Zookeeper یا KRaft داره و tuning اش پیچیدهتره.
قانون کلی که خودم بهش رسیدم: اگه صرفاً یه task queue میخوای (پردازش پسزمینه، job scheduling)، RabbitMQ یا حتی چیزی سبکتر مثل Redis + BullMQ کافیه. اگه داری event-driven architecture میسازی که چند سرویس باید stream یکسانی از رویدادها رو دنبال کنن، Kafka انتخاب منطقیتریه.
چیزهایی که معمولاً کسی بهت نمیگه
یه چیزی که تو اکثر tutorial ها نادیده گرفته میشه، مسئلهی idempotency است. queue تضمین میکنه پیام حتماً تحویل داده میشه، ولی این تضمین معمولاً به معنی «حداقل یکبار» (at-least-once) هست، نه دقیقاً یکبار. یعنی اگه consumer پیامی رو پردازش کنه ولی قبل از فرستادن ack کرش کنه، همون پیام دوباره تحویل داده میشه. اگه handler ات idempotent نباشه (مثلاً دوباره یه ایمیل یا دوباره کم کردن موجودی انبار)، این میتونه به باگهای عجیبی منجر بشه که فقط زیر لود بالا خودشون رو نشون میدن.
راهحل معمولش اینه که یه شناسهی یکتا (idempotency key) رو تو خود پیام بذاری و قبل از پردازش چک کنی که این key قبلاً پردازش شده یا نه — معمولاً با یه جدول یا کلید تو Redis با TTL مناسب.
نکتهی دیگه، dead letter queue است. اگه یه پیام چندین بار fail بشه (مثلاً یه فرمت دادهی خراب)، نباید بذاری برای همیشه بین صف اصلی و consumer رد و بدل بشه. اکثر broker ها امکان تعریف یه صف جداگانه رو دارن که بعد از N بار retry ناموفق، پیام به اونجا منتقل میشه تا بعداً دستی بررسیش کنی. بدون این، یه پیام خراب میتونه کل صف رو مسدود کنه یا لاگها رو پر کنه.
کِی اصلاً به queue نیاز نداری
با همهی این حرفها، queue همیشه جواب درست نیست. اگه عملیاتت سریعه و کاربر واقعاً باید نتیجهی فوری رو ببینه (مثلاً یه محاسبهی قیمت لحظهای)، اضافه کردن یه لایهی async فقط پیچیدگی اضافه میکنه بدون هیچ فایدهای. queue بیشتر برای کارهایی معنی داره که میتونن «بعداً» انجام بشن، یا وقتی حجم درخواستها نامنظمه و میخوای consumer رو از فشار لحظهای محافظت کنی.
اگه تازه داری معماری یه سیستم رو طراحی میکنی، بهتره اول ببینی کدوم بخش از پردازشت واقعاً میتونه صبر کنه، بعد queue رو دقیقاً همونجا اضافه کنی — نه اینکه از اول همهچیز رو async کنی چون «الگوی بهتریه».