end-to-end یا E2E test رفتار واقعی کاربر رو توی یه محیط کامل شبیهسازی میکنه — از باز کردن یه صفحهی ساده تا سناریوهای پیچیدهتر مثل پرداخت آنلاین یا دریافت ایمیل تأیید. این تستها خیلی مفیدن، ولی هم گرون هستن و هم نگهداریشون سخته؛ برای همین توصیهی رایج اینه که فقط چند تا سناریوی کلیدی رو با E2E پوشش بدی و بیشتر تکیهت روی یونیت و integration تست باشه که سریعتر مشکل رو نشونت میدن.
acceptance test
acceptance test یه تست رسمیتره که چک میکنه آیا کل سیستم نیازمندیهای کسبوکار رو برآورده میکنه یا نه؛ نیاز داره کل اپلیکیشن در حال اجرا باشه و روی رفتار واقعی کاربر تمرکز داره. بعضی وقتها فراتر هم میره و performance سیستم رو هم اندازه میگیره، و اگه به یه هدف مشخص نرسه، تغییرات رو رد میکنه.
performance test
performance test میسنجه سیستم زیر یه بار مشخص چطور رفتار میکنه — قابلیت اطمینان، سرعت، مقیاسپذیری و responsiveness. مثلاً میتونه زمان پاسخدهی رو زیر تعداد زیادی request بسنجه، یا رفتار سیستم رو با حجم زیادی داده تست کنه. اینجور تستها کمک میکنن گلوگاهها (bottleneck) رو پیدا کنی و پایداری سیستم رو زیر ترافیک اوج بسنجی.
smoke test
smoke test یه تست پایه و سریعه که فقط چک میکنه عملکردهای اصلی سیستم کار میکنن یا نه. هدفش این نیست که همهچیز رو دقیق بررسی کنه، فقط میخواد یه اطمینان اولیه بده. جای خوب استفادهازش درست بعد از یه build جدید (برای تصمیمگیری که آیا ارزش داره تستهای گرونتر رو اجرا کنی یا نه) یا بلافاصله بعد از یه deploy هست، تا مطمئن بشی محیط جدید درست بالا اومده.
اتوماسیون این تستها چطور انجام میشه؟
برای خودکارسازی این تستها، اول باید اونها رو با یه framework مناسب زبانت بنویسی — چیزهایی مثل PHPUnit برای PHP، Mocha برای جاوااسکریپت، یا RSpec برای روبی. بعد از اینکه تستهات از طریق ترمینال و با یه دستور ساده قابل اجرا شدن، میتونی بذاری یه CI server یا سرویس ابری مثل Bitbucket Pipelines هر بار که یه تغییر جدید push میشه، خودکار اجراشون کنه.
exploratory testing، جایی که تست دستی هنوز جواب میده
با اینکه اتوماسیون کلید اصلی مقیاسپذیری تسته، این به این معنی نیست که تست دستی کاملاً بیفایده شده. اینجاست که exploratory testing وارد میشه — یه رویکرد دستی و بدون اسکریپت از پیش نوشتهشده که هدفش پیدا کردن باگهای غیربدیهیه، چیزهایی که هیچ تست خودکاری از قبل براش نوشته نشده چون کسی اصلاً فکرش رو نکرده بود. یه توصیهی عملی برای این نوع تست اینه که هر نشست exploratory بیشتر از دو ساعت طول نکشه و یه محدودهی مشخص داشته باشه، تا تسترها روی یه بخش خاص از سیستم تمرکز کنن.
یه نکتهی مهم دربارهی هدف تست
یه چیزی که خیلی وقتها فراموش میشه اینه که تست فقط برای چک کردن «آیا کاربر میتونه کارشو انجام بده» نیست؛ به همون اندازه مهمه که چک کنی اپلیکیشن با دادهی بد یا رفتار غیرمنتظره خراب نمیشه. باید پیشبینی کنی وقتی کاربر یه تایپو میزنه، یه فرم ناقص رو submit میکنه، یا از یه API به شکل اشتباه استفاده میکنه چه اتفاقی میفته، و اینکه آیا کسی میتونه راحت دادهای رو دستکاری کنه یا به منبعی که نباید بهش دسترسی داشته باشه برسه. یه test suite خوب باید تلاش کنه اپ رو بشکنه، نه فقط ثابت کنه کار میکنه.
یه نکتهی آخر هم هست که ارزش تکرار داره: تستها هم خودشون کد هستن. یعنی موقع code review نباید فراموششون کنی — گاهی همین تستها آخرین دروازهای هستن که جلوی یه باگ رو قبل از رسیدن به production میگیرن.
این تقسیمبندی که اینجا مرور کردیم، بر پایهی یه راهنمای خوب از Atlassian دربارهٔ انواع تست نرمافزاره؛ اگه دوست داری جزئیات بیشتری از دید خود Atlassian ببینی، میتونی این مقاله رو هم بخونی.
نکتهی requestCert: true و rejectUnauthorized: true اینجاست که اگه کلاینت certificate معتبر نداشته باشه، اصلاً اجازهی وصل شدن پیدا نمیکنه — قبل از اینکه حتی یه خط از کد اپلیکیشنت اجرا بشه. برای API های داخلی حساس، mTLS یکی از قویترین گزینههاست. مشکلش اینه که مدیریت certificate ها (تمدید، revoke کردن، rotate کردن) خودش یه پروژهی جداست؛ اگه چند تا سرویس داری و مدیریتش برات سخته، ابزارهایی مثل service mesh (Istio، Linkerd) این کار رو خودکار میکنن.
از JWT کاربر برای ارتباط سرویس به سرویس استفاده نکن
یه اشتباه رایج اینه که همون JWT ای که برای احراز هویت کاربر نهایی صادر شده رو برای ارتباط بین دو تا سرویس backend هم دوبارهکاری میکنن — یعنی چیزی شبیه Authorization: Bearer <user-jwt> رو بین سرویسها پاس میدن. این کار مرز بین «هویت کاربر» و «هویت سرویس» رو از بین میبره و باعث میشه permission های کاربر و سرویس قاطی بشن. به جاش باید یه credential مخصوص machine-to-machine داشته باشی. گزینههای خوب اینجا شامل OAuth 2.0 Client Credentials، mTLS، درخواستهای امضاشده (signed requests)، ترکیب API key و HMAC، و توکنهای کوتاهمدت سرویسمحور هستن.
برای بیشتر زیرساختهای متوسط، ترکیب OAuth 2.0 Client Credentials بههمراه HTTPS انتخاب معقولیه؛ برای ارتباطات داخلی که واقعاً حساس هستن، mTLS بههمراه توکنهای کوتاهمدت گزینهی قویتریه.
هر سرویس هویت خودش رو داشته باشه
یه اشتباه دیگه که خیلی رایجه: یه کلید API واحد و master برای همهچیز. چیزی شبیه یه متغیر محیطی به اسم MASTER_API_KEY که همهی سرویسها ازش استفاده میکنن. مشکل این روش اینه که وقتی یکی از سرویسها compromise بشه، عملاً کل سیستم compromise شده — چون همه از یه کلید استفاده میکردن.
راه درستتر اینه که هر سرویس یه service account مخصوص خودش داشته باشه، و به هر کدوم فقط همون permission هایی که واقعاً بهش نیاز داره داده بشه. مثلاً اگه سرویس A فقط باید کاربر بسازه و بخونه، نباید اصلاً امکان حذف کاربر یا دسترسی به بخش پرداخت رو داشته باشه:
سرویس A → مجاز به: create_user, read_user, update_access
سرویس A → غیرمجاز به: delete_user, access_payments, access_admin, access_database
به این اصل، least privilege میگن: هر جزء از سیستم فقط دسترسیای رو داشته باشه که برای انجام کارش لازمه، نه بیشتر. این سادهترین و در عین حال مؤثرترین اصلی هست که خیلی از تیمها فراموشش میکنن.
احراز هویت با تعیین دسترسی فرق داره
احراز هویت (authentication) به این سؤال جواب میده: «تو کی هستی؟» و تعیین دسترسی (authorization) به این سؤال: «تو اجازهی چه کاری رو داری؟» یه فرض اشتباه رایج اینه که فکر کنیم چون یه request احراز هویت شده، پس قابل اعتماده. این درست نیست. باید هر endpoint جداگانه چک بشه که آیا سرویسی که این درخواست رو فرستاده، مجوز انجام همین عملیات خاص رو داره یا نه. مثلاً POST /users ممکنه نیاز به مجوز user:create داشته باشه، در حالی که DELETE /users/:id ممکنه به یه مجوز کاملاً متفاوت نیاز داشته باشه که خیلی محدودتر بهش داده میشه.
امضای درخواستها با HMAC
برای APIهایی که سطح امنیتی بالاتری میخوان، امضای درخواست (request signing) با HMAC یه لایهی اضافهی خیلی خوبیه. ایده اینه که هر دو سرویس یه secret مشترک دارن، و هر request قبل از ارسال با اون secret امضا میشه:
سمت سرور، همین امضا دوباره از روی method، path، timestamp و body محاسبه میشه و با چیزی که تو header اومده مقایسه میشه. اگه یکی وسط راه request رو بگیره و مثلاً ایمیل داخل body رو عوض کنه، امضا دیگه match نمیکنه و request رد میشه — بدون اینکه اصلاً لازم باشه محتوای request رمزنگاری بشه؛ همین که تغییرناپذیریش تضمین بشه کافیه.
محافظت در برابر replay attack
فقط امضا کردن request کافی نیست. اگه کسی یه request معتبر و امضاشده رو ضبط کنه و بعداً دوباره همونو بفرسته، امضا هنوز معتبره چون چیزی توش عوض نشده. این همون replay attack هست. راهحلش ترکیب سه چیزه: timestamp، یه شناسهی یکتا برای هر request (نانس یا request-id)، و امضا:
منطق سمت سرور این شکلیه: اول چک میشه timestamp توی یه بازهی معقول هست (مثلاً کمتر از پنج دقیقه اختلاف با زمان فعلی سرور)، بعد چک میشه که این request-id قبلاً پردازش نشده (این بخش معمولاً با یه cache سریع مثل Redis پیاده میشه، با یه TTL برابر با همون بازهی زمانی)، و اگه هر دو شرط برقرار بود، امضا verify میشه و در نهایت request-id ذخیره میشه تا دفعهی بعد تکراری تشخیص داده بشه. بدون این مکانیزم، حتی امضای HMAC هم در برابر یه حملهی سادهی «ضبط و پخش دوباره» بیدفاعه.
شبکه رو محدود کن، این شاید مهمترین قدمه
اگه سرویس B فقط قراره از طرف سرویس A صدا زده بشه، هیچ دلیلی نداره که اصلاً از اینترنت عمومی در دسترس باشه. این یکی از نکاتی هست که تأثیرش روی امنیت کلی سیستم از خیلی چیزهای دیگه بیشتره، چون هر لایهی امنیتی دیگهای که بذاری (authentication، rate limit، signature) باز هم در معرض حمله قرار میگیره اگه شبکه بهطور عمومی باز باشه.
ابزارهایی که برای این کار به کار میان شامل قوانین فایروال، security group های ابری، شبکهی خصوصی (VPC)، VPN یا WireGuard، IP allowlist، و DNS داخلی هستن. ایدهآل اینه که ترافیک بین دو سرویس فقط از یه شبکهی خصوصی رد بشه، نه از مسیر عمومی اینترنت که بعد پشت فایروال فیلتر بشه. این دو تا از نظر امنیتی خیلی با هم فرق دارن، حتی اگه نتیجهی نهایی مشابه به نظر برسه.
هیچوقت دسترسی مستقیم دیتابیس نده
یه اشتباه خطرناک که گاهی توی معماریهای عجلهای دیده میشه اینه که یه سرویس بیرونی، مستقیماً credential دیتابیس سرویس دیگه رو داشته باشه. حتی اگه این credential محدود به یه کاربر readonly باشه، این کار لایهی authorization اپلیکیشن رو کاملاً دور میزنه. مسیر درست همیشه از طریق API میگذره: سرویس A فقط باید از طریق HTTPS و API عمومی سرویس B باهاش حرف بزنه، و سرویس B خودش تصمیم میگیره که این عملیات با توجه به authorization چطور روی دیتابیس اجرا بشه. سرویس A هیچوقت نباید بتونه کاری بیشتر از اونی که API صراحتاً exposed کرده انجام بده.
اعتماد کورکورانه به ورودی، حتی از سرویس داخلی
حتی اگه یه request از یه سرویس authenticated بیاد، بازم باید ورودیهاش validate بشن — schema، طول رشتهها، فرمت شناسهها، URL ها، اسم فایلها، enum ها، بازهی عددی، و حجم payload. یه نکتهی خاص اینجا مربوط به SSRF هست: اگه سرور تو بر اساس یه URL که از سمت کاربر یا سرویس دیگه اومده (مثلاً یه فیلد callback_url) یه request جدید میسازه، بدون validate کردن اون آدرس ممکنه یه آسیبپذیری SSRF ایجاد بشه که مهاجم بتونه از طریق سرورت به منابع داخلی شبکه دسترسی پیدا کنه که اصلاً نباید بهشون دسترسی داشته باشه.
rate limit فقط برای ترافیک بیرونی نیست
یه سرویس authenticated لزوماً امن نیست. اگه سرویس A به هر دلیلی — یه باگ، یه حلقهی بینهایت، یه retry logic خراب — شروع کنه به بمباران کردن سرویس B، معتبر بودن token یا امضا هیچ کمکی نمیکنه. گذاشتن rate limit حتی روی ترافیک کاملاً داخلی، چیزیه که خیلی وقتها دیر بهش فکر میکنیم؛ معمولاً بعد از اینکه یه بار یه سرویس داخلی کل کلاستر رو از پا درآورده. منطقیترین کار اینه که برای هر endpoint بر اساس هزینهی محاسباتیش یه سقف جدا تعریف کنی؛ یه request خواندنی ساده و یه عملیات export سنگین طبیعتاً نباید سقف یکسانی داشته باشن.
لاگ کردن، اما نه هر چیزی
وقتی یه چیزی خراب میشه، اولین جایی که سراغش میری لاگهاست. صرفاً لاگ کردن مسیر و متد request (POST /users) کافی نیست؛ چیزهایی که واقعاً کمککننده هستن شامل timestamp، اسم سرویس فرستنده، endpoint، شناسهی یکتای request، نتیجهی عملیات، تصمیم authorization، آدرس IP مبدأ، و latency میشن. نکتهی خیلی مهم اینه که هیچوقت secret ها یا credential های حساس رو توی لاگ ننویسی — این خودش یه منبع رایج نشت اطلاعاته که کمتر بهش توجه میشه.
مقایسهی روشهای ارتباطی
انتخاب پروتکل بین دو سرویس بیشتر به الگوی استفاده بستگی داره تا امنیت، هرچند بعضی گزینهها ذاتاً برای یه سناریوی خاص مناسبترن:
روش
مناسب برای
REST روی HTTPS
APIهای عمومی پلتفرم، انعطافپذیر و پرکاربرد
GraphQL روی HTTPS
کوئریهای منعطف سمت کلاینت
gRPC با mTLS
ارتباط سرویسبهسرویس داخلی، latency پایین
WebSocket
ارتباط real-time دوطرفه
صف پیام (Message Queue)
عملیات async و پسزمینهای
اتصال مستقیم به دیتابیس
باید کاملاً پرهیز بشه
HTTP بدون TLS
هیچوقت
برای ارتباط بین دو پلتفرم مستقل، REST بههمراه HTTPS و OAuth2 (یا mTLS برای موارد حساستر) یه انتخاب کاملاً محکمه. برای میکروسرویسهای داخلی که تعداد زیادی درخواست کوچیک و پرتکرار با هم رد و بدل میکنن، gRPC یا یه message broker معمولاً منطقیتره.
نکتهای که در آخر ارزش تکرار کردن داره: هدف طراحی یه API که «هک کردنش غیرممکنه» نیست — چنین چیزی وجود خارجی نداره. هدف اینه که سیستم رو طوری بچینی که compromise شدن یه جزء، خودکار به compromise شدن همهچیز منجر نشه. ایزوله کردن شبکه، least privilege، credential های جداگانه برای هر سرویس، محدود کردن دسترسی دیتابیس، و دفاع در عمق، در عمل خیلی بیشتر از انتخاب REST یا GraphQL یا هر پروتکل دیگهای روی امنیت واقعی سیستم تأثیر میذارن.
اما هنوز یه مشکل وجود داره.
مشکل اینجاست که زبان و تصویر یکی نیستن
برای متن هم یه چیزی شبیه همین اتفاق میافته.
متنی که شما مینویسید اول توسط Tokenizer به توکنها تقسیم میشه و بعد این توکنها به embedding تبدیل میشن.
پس الان دو طرف داریم:
متن → Tokenizer → Embedding متنی
و
عکس → Image Encoder → Embedding تصویری
ولی این دو embedding الزاماً توی یه فضای مشترک نیستن.
اینجاست که Projection وارد داستان میشه.
Projection؛ پلی بین تصویر و متن
Projection رو میشه خیلی ساده مثل یه پل در نظر گرفت.
ویژگیهایی که از تصویر استخراج شدن، از طریق این بخش به شکلی تبدیل میشن که برای مدل زبانی قابل استفاده باشن.
در نتیجه اطلاعات تصویر میتونه در کنار اطلاعات متنی وارد فرایند پردازش مدل بشه.
یعنی بهصورت خیلی ساده:
عکس → Vision Encoder → Projection → مدل زبانی
و همزمان:
متن → Tokenizer → مدل زبانی
حالا مدل میتونه این دو نوع اطلاعات رو کنار هم داشته باشه.
مثلاً فرض کنید یه عکس از یه خیابون به ChatGPT میدید و میپرسید:
«چه ماشینی سمت راست تصویر پارک شده؟»
مدل لازم نیست اول عکس رو به یه جملهی ساده مثل «یک خیابون با یک ماشین در آن وجود دارد» تبدیل کنه.
اطلاعات تصویری به شکل embedding وارد سیستم شده و مدل میتونه اون رو در کنار سؤال شما پردازش کنه.
به همین دلیله که میتونید سؤالهای خیلی دقیقتری هم بپرسید:
«رنگ ماشین سمت راست چیه؟»
«چند نفر توی تصویر هستن؟»
«این نمودار چی رو نشون میده؟»
یا حتی:
«کد داخل این اسکرینشات چه مشکلی داره؟»
پس ChatGPT واقعاً عکس رو میبینه؟
خب، اینجا باید یه کم مراقب کلمهی «دیدن» باشیم.
ChatGPT به معنای انسانی کلمه عکس رو نمیبینه. چیزی که اتفاق میافته اینه که تصویر از طریق بخش بینایی مدل به یه نمایش عددی تبدیل میشه و این اطلاعات به شکلی در اختیار مدل زبانی قرار میگیره که بتونه روی اونها کار کنه.
از طرف دیگه، متن سؤال شما هم به توکنها و embedding تبدیل میشه.
مدل در نهایت با ترکیبی از این اطلاعات سروکار داره و بر اساس اونها پاسخ تولید میکنه.
پس چیزی که از بیرون شبیه اینه که:
«عکس رو دادم → مدل عکس رو دید → جواب داد»
در پشت صحنه خیلی بیشتر شبیه اینه:
«عکس رو دادم → بخش بینایی اون رو به نمایش عددی تبدیل کرد → این اطلاعات با ورودی متنی ترکیب شد → مدل زبانی بر اساس هر دو پاسخ تولید کرد.»
پس Multimodal دقیقاً یعنی چی؟
اسم Multimodal از همینجا میاد.
مودالیتی یا Modality یعنی نوع یا شکل اطلاعات.
متن یه modality محسوب میشه، تصویر یه modality دیگه، صدا هم یکی دیگه.
مدلهای چندوجهی بهجای اینکه فقط با یک نوع اطلاعات کار کنن، طوری طراحی شدن که بتونن چند نوع اطلاعات مختلف رو دریافت و با هم استفاده کنن.
و این دقیقاً همون چیزیه که باعث میشه بتونید یه عکس، یه سؤال متنی و حتی در بعضی مدلها فایل صوتی یا ویدئو رو به سیستم بدید و انتظار داشته باشید همهی اینها رو در کنار هم درک کنه.
یه نکته مهم
البته نباید تصور کنیم که همهی مدلهای Multimodal دقیقاً همین معماری رو دارن.
GPT، Gemini و مدلهای دیگه ممکنه از روشهای متفاوتی برای پردازش تصویر و وصل کردن اطلاعات تصویری به مدل زبانی استفاده کنن.
اما ایدهی کلی همینه:
تصویر مستقیماً به یک جملهی متنی تبدیل نمیشه؛ اول به یک نمایش عددی تبدیل میشه که مدل بتونه باهاش کار کنه.
بنابراین دفعهی بعد که یه عکس رو به ChatGPT میدید و ازش دربارهی جزئیات اون سؤال میکنید، پشت این قابلیت یه «عکس به متن» ساده وجود نداره.
یه مدل بینایی، embedding، projection و در نهایت یه مدل زبانی بزرگ دارن با هم کار میکنن تا چیزی که برای ما شبیه «فهمیدن عکس» به نظر میرسه، اتفاق بیفته.
یکی از جذابترین بخشهای Wasp، مدل ارتباطی client-server شه. بهجای اینکه خودت endpoint بسازی و بعد جدا یه fetch call بنویسی، فقط یه تابع سرور رو تعریف میکنی و Wasp خودش یه hook تایپشده تو کلاینت تولید میکنه:
// سمت کلاینت: استفاده مستقیم، بدون نوشتن fetch یا API route
import { useQuery, getTasks } from 'wasp/client/operations';

function TaskList() {
  const { data: tasks, isLoading } = useQuery(getTasks);
  if (isLoading) return <div>در حال بارگذاری...</div>;
  return <ul>{tasks.map(t => <li key={t.id}>{t.description}</li>)}</ul>;
}
نکتهی مهم اینجاست که تایپهای TypeScript بین سرور و کلاینت بهصورت خودکار sync میشن؛ اگه ساختار دادهای که از سرور برمیگرده عوض بشه، همون لحظه تو کلاینت هم خطای type-check میگیری، بدون اینکه خودت مجبور باشی این هماهنگی رو دستی نگه داری.
قابلیتهای آماده که معمولاً باید خودت بسازی
Wasp خودش رو «batteries-included» معرفی میکنه، و این ادعا با فهرست قابلیتهاش پشتیبانی میشه:
Auth کامل: ایمیل/پسورد، گوگل، گیتهاب، اسلک، مایکروسافت، همه با پیکربندی چند خطی.
Background jobs: برای کارهایی که نباید request رو بلاک کنن.
ارسال ایمیل: بدون نیاز به تنظیم دستی SMTP یا SDK جدا.
Type-safety کامل full-stack: از دیتابیس تا کامپوننت React.
Deploy با یه دستور:wasp deploy میتونه اپ رو مستقیم رو زیرساختهای پشتیبانیشده بالا بیاره.
نکتهی مهم: بدون lock-in
برخلاف پلتفرمهایی مثل Firebase یا Supabase که کدت به سرویس اونا وابسته میشه، Wasp ادعا میکنه هیچ lock-in ای نداره. خروجی کامپایل، کد خام React و Node.js و Prisma است که میتونی مستقیم تو پوشهی .wasp/ ببینیش. یعنی اگه یه روز تصمیم گرفتی از Wasp CLI فاصله بگیری، کد تولیدشده رو برمیداری و مستقل ازش ادامه میدی؛ بدون runtime اختصاصی یا لایهی مخفی سمت سرور.
چرا این روزها خودش رو «فریمورک عصر AI» معرفی میکنه
نکتهی جالب اینه که Wasp این روزها تمرکز بازاریابیش رو گذاشته رو اینکه برای کدنویسی با agent های هوش مصنوعی بهینهست. استدلالشون اینه: چون Wasp یه توصیف سطحبالا و declarative از کل اپلیکیشن داره (نه هزاران فایل پراکندهی boilerplate)، یه agent کدنویس میتونه ساختار کامل اپ رو خیلی سریعتر «بفهمه» و تغییرات درستی اعمال کنه. خود پروژه یه سری plugin و skill هم برای ابزارهایی مثل Claude Code منتشر کرده که مستقیم دانش Wasp رو به agent اضافه میکنه.
جالبه که این رویکرد هیچ ارتباطی به یه provider خاص هوش مصنوعی نداره؛ Wasp خودش هیچ AI داخلی نداره و اگه بخوای یه ویژگی AI به اپت اضافه کنی (مثلاً چتبات)، باید مدل دلخواهت (OpenAI، آنتروپیک، یا یه مدل local) رو مثل یه dependency معمولی Node.js وصل کنی؛ چیزی که خودشون توش دخالتی ندارن.
کجا این فریمورک جای خودش رو پیدا میکنه
Wasp دقیقاً یه خلأ خاص رو پر میکنه: جایی بین انعطاف کامل ولی کاردستی Next.js یا Remix (که همهچیز رو خودت وایر میکنی)، و انتزاع بالا ولی وابستهبه-سرویس Firebase یا Supabase (که برای هر چیزی به یه پلتفرم شخص ثالث وابستهای). اگه دنبال یه تجربهی شبیه Rails یا Laravel هستی، ولی میخوای تو دنیای TypeScript و React بمونی، Wasp دقیقاً همین رو ارائه میده.
معایب و محدودیتها
طبیعتاً این سطح از انتزاع هزینه هم داره. اکوسیستم Wasp نسبت به Next.js یا حتی Nuxt خیلی کوچیکتره؛ تعداد پروژههای واقعی، منابع آموزشی، و توسعهدهندههای آشنا محدودتره. یادگیری DSL اختصاصیش هم یه گام اضافهست، هرچند سینتکسش نسبتاً سادهست. و چون فریمورک هنوز رسماً تو مرحلهی beta است (با اینکه برای ساخت بیش از ۵۰ هزار پروژه استفاده شده)، برای پروژههای خیلی بزرگمقیاس یا سازمانی، ممکنه بلوغ لازم رو نداشته باشه. علاوه بر این، طبیعت «opinionated» فریمورک یعنی برای اپلیکیشنهایی که ساختارشون خیلی از الگوی معمول CRUD/auth/jobs فاصله داره، ممکنه بیشتر از اینکه کمک کنه، محدودت کنه.
جمعبندی
اگه داری یه SaaS یا اپلیکیشن full-stack نسبتاً استاندارد میسازی (auth، دیتابیس، چند تا صفحه، شاید یه سری background job) و میخوای سریعتر از صفر شروع کنی، بدون اینکه هفتهها وقت صرف wiring کردن قطعات مختلف کنی، Wasp ارزش امتحان کردن داره؛ مخصوصاً که رایگان، متنباز، و بدون lock-in است. اگه پروژهت نیاز به کنترل خیلی دقیق روی هر جزئیات معماری داره، یا از قبل تیمی داری که با Next.js یا Nuxt راحته، احتمالاً همون مسیر آشناتر منطقیتره.
یه مثال ساده
فرض کن یه تابع محاسباتی سنگین به Rust داری:
#[no_mangle]
pub fn fibonacci(n: u32) -> u64 {
    if n <= 1 {
        return n as u64;
    }
    let mut a = 0u64;
    let mut b = 1u64;
    for _ in 2..=n {
        let temp = a + b;
        a = b;
        b = temp;
    }
    b
}
با ابزاری مثل wasm-pack، این کد به یه فایل .wasm compile میشه که میشه مستقیم تو جاوااسکریپت import و صداش زد:
import init, { fibonacci } from './pkg/my_wasm_module.js';

async function run() {
    await init();
    console.log(fibonacci(50)); // اجرا با سرعت نزدیک به native
}

run();
از دید جاوااسکریپت، fibonacci فقط یه تابع معمولیه، ولی پشت صحنه داره یه باینری کامپایلشده و بهینه اجرا میشه، نه کد تفسیرشدهی جاوااسکریپت.
کجاها واقعاً استفاده میشه
ابزارهای سنگین که به مرورگر آوردن: Figma بخش زیادی از موتور رندرش رو با WebAssembly پیاده کرده تا بتونه performance شبیه یه اپلیکیشن دسکتاپ رو تو مرورگر ارائه بده. AutoCAD نسخهی وب خودش رو با پورت کردن دههها کد C++ به Wasm ساخته.
بازیها و موتورهای گرافیکی: موتورهایی مثل Unity و Unreal Engine امکان export کردن بازی به WebAssembly رو دارن، که یعنی بازیهای نسبتاً سنگین میتونن مستقیم تو مرورگر، بدون نصب هیچ پلاگینی، اجرا بشن.
پردازش تصویر و ویدیو: ابزارهایی مثل ffmpeg.wasm امکان encode/decode کردن ویدیو مستقیم تو مرورگر رو میدن، بدون اینکه فایل به سرور آپلود بشه؛ هم سریعتره، هم حریم خصوصی کاربر حفظ میشه.
اجرای زبونهای دیگه تو مرورگر: پروژههایی مثل Pyodide، پایتون رو کامل به WebAssembly compile کردن، یعنی میتونی کد پایتون واقعی رو مستقیم تو مرورگر، بدون سرور، اجرا کنی.
فراتر از مرورگر: WebAssembly دیگه محدود به مرورگر نیست. با استانداردی به اسم WASI (WebAssembly System Interface)، میشه Wasm رو مستقل از مرورگر، رو سرور یا edge computing هم اجرا کرد. کلادفلر Workers و Fastly Compute دقیقاً از همین قابلیت استفاده میکنن تا کد رو تو صدها دیتاسنتر مختلف، با startup time خیلی کمتر از یه کانتینر معمولی، اجرا کنن.
چیزی که WebAssembly نیست
یه سوءتفاهم رایج اینه که فکر کنیم Wasm قراره جای جاوااسکریپت رو بگیره. اینطور نیست؛ Wasm نمیتونه مستقیم به DOM دسترسی داشته باشه یا event handler ثبت کنه. برای هر تعامل با صفحه (کلیک، تغییر استایل، دستکاری DOM)، هنوز باید از جاوااسکریپت بهعنوان واسط استفاده کنی. Wasm بیشتر مکمل جاوااسکریپته تا جایگزینش؛ جاهایی که محاسبات سنگین لازمه، کار رو به Wasm میسپاری و بقیهی تعامل با کاربر همچنان با جاوااسکریپت انجام میشه.
کِی واقعاً بهش نیاز داری
اگه داری یه اپلیکیشن وب معمولی میسازی (فرم، داشبورد، فروشگاه آنلاین)، به احتمال زیاد هیچوقت مستقیم با WebAssembly سروکار پیدا نمیکنی؛ جاوااسکریپت (یا فریمورکهای روش) کاملاً کافیه. Wasm زمانی وارد بازی میشه که یه بخش خاص از اپلیکیشنت واقعاً محاسبات سنگین داره (پردازش تصویر/صوت/ویدیو، رمزنگاری، فیزیک، parsing فایلهای حجیم) و همون بخش داره performance اپ رو محسوس کند میکنه. تو اون حالت، میتونی فقط همون بخش خاص رو به Rust یا C++ بنویسی و به Wasm compile کنی، بدون اینکه مجبور بشی کل اپلیکیشن رو از جاوااسکریپت خارج کنی.
# Driven port: domain فقط این interface رو میشناسه
from abc import ABC, abstractmethod
class OrderRepository(ABC):
@abstractmethod
def save(self, order: 'Order') -> None:
pass
@abstractmethod
def find_by_id(self, order_id: str) -> 'Order | None':
pass
class NotificationSender(ABC):
@abstractmethod
def send_order_confirmation(self, order: 'Order') -> None:
pass
پیادهسازی: هستهی domain
هستهی domain فقط به این port ها وابستهست، نه به هیچ پیادهسازی خاصی:
class Order:
    def __init__(self, order_id: str, customer_email: str, total: float):
        self.order_id = order_id
        self.customer_email = customer_email
        self.total = total
        self.status = "pending"


class PlaceOrderService:
    def __init__(self, repository: OrderRepository, notifier: NotificationSender):
        self.repository = repository
        self.notifier = notifier

    def place_order(self, order_id: str, customer_email: str, total: float) -> Order:
        if total <= 0:
            raise ValueError("مبلغ سفارش باید مثبت باشه")

        order = Order(order_id, customer_email, total)
        self.repository.save(order)
        self.notifier.send_order_confirmation(order)
        return order
این کلاس PlaceOrderService هیچ ایدهای نداره که آیا OrderRepository واقعاً یه دیتابیس PostgreSQL رو صدا میزنه یا فقط یه dictionary تو حافظهست. برای همینه که تست کردنش خیلی سادهست:
class InMemoryOrderRepository(OrderRepository):
    def __init__(self):
        self.orders = {}

    def save(self, order):
        self.orders[order.order_id] = order

    def find_by_id(self, order_id):
        return self.orders.get(order_id)


class FakeNotifier(NotificationSender):
    def __init__(self):
        self.sent = []

    def send_order_confirmation(self, order):
        self.sent.append(order)


def test_place_order_saves_and_notifies():
    repo = InMemoryOrderRepository()
    notifier = FakeNotifier()
    service = PlaceOrderService(repo, notifier)

    order = service.place_order("ord_1", "ali@example.com", 150.0)

    assert repo.find_by_id("ord_1") == order
    assert len(notifier.sent) == 1
آداپترهای واقعی
حالا وقتی زمان استفادهی واقعی میرسه، همون port ها رو با پیادهسازی واقعی adapt میکنیم:
import psycopg2

class PostgresOrderRepository(OrderRepository):
    def __init__(self, connection):
        self.connection = connection

    def save(self, order):
        with self.connection.cursor() as cursor:
            cursor.execute(
                "INSERT INTO orders (id, email, total, status) VALUES (%s, %s, %s, %s)",
                (order.order_id, order.customer_email, order.total, order.status)
            )
        self.connection.commit()

    def find_by_id(self, order_id):
        with self.connection.cursor() as cursor:
            cursor.execute("SELECT * FROM orders WHERE id = %s", (order_id,))
            row = cursor.fetchone()
            return Order(*row) if row else None


class EmailNotifier(NotificationSender):
    def __init__(self, smtp_client):
        self.smtp_client = smtp_client

    def send_order_confirmation(self, order):
        self.smtp_client.send(
            to=order.customer_email,
            subject="تأیید سفارش",
            body=f"سفارش {order.order_id} با موفقیت ثبت شد."
        )
خود PlaceOrderService بدون هیچ تغییری، هم با نسخهی تستی کار میکنه و هم با نسخهی واقعی؛ فقط adapter ای که موقع wiring کردن اپلیکیشن بهش تزریق میشه فرق میکنه.
این معماری با Dependency Inversion Principle چه ربطی داره
اگه مقالهی SOLID رو خونده باشی، احتمالاً این الگو برات آشناست؛ معماری هگزاگونال عملاً یه اعمال سیستماتیک از Dependency Inversion Principle تو سطح کل اپلیکیشنه. بهجای اینکه domain به یه پیادهسازی خاص (مثل PostgreSQL) وابسته باشه، هم domain و هم پیادهسازی، به یه abstraction مشترک (port) وابستهن. جهت وابستگی همیشه به سمت داخل (به سمت domain) است؛ هیچوقت برعکس.
کجا این معماری واقعاً ارزش داره
این معماری برای اپلیکیشنهایی معنی داره که منطق کسبوکار پیچیده و قابلتغییری دارن، یا احتمال داره زیرساختهاشون (دیتابیس، پیامرسان، API های خارجی) تو طول زمان عوض بشه. سیستمهای مالی، پلتفرمهای e-commerce با قوانین قیمتگذاری پیچیده، یا هر جایی که تیم میخواد تستهای سریع و ایزوله داشته باشه، از این جداسازی سود میبره.
در مقابل، برای یه CRUD ساده که فقط داره داده رو از دیتابیس میخونه و نمایش میده، بدون منطق کسبوکار پیچیدهای، اضافه کردن لایههای port و adapter فقط پیچیدگی اضافه میکنه بدون فایدهی متناسب. مثل خیلی از الگوهای معماری دیگه، سؤال درست این نیست که «آیا این الگو خوبه؟»، بلکه اینه که «آیا پیچیدگی پروژهم این سرمایهگذاری رو توجیه میکنه؟»
Vue از یه مدل fine-grained reactivity استفاده میکنه؛ سیستم دقیقاً میدونه کدوم بخش از template به کدوم متغیر وابستهست، پس وقتی یه مقدار عوض میشه، فقط همون بخش خاص آپدیت میشه، بدون نیاز به اجرای دوبارهی کل تابع یا محاسبهی diff:
این تفاوت معماری یعنی Vue معمولاً بدون نیاز به optimization دستی (مثل useMemo یا useCallback تو React) عملکرد خوبی میده، در حالی که تو اپهای React بزرگ، مدیریت re-render های غیرضروری خودش به یه مهارت جدا تبدیل میشه.
سینتکس و ساختار فایل
React از JSX استفاده میکنه؛ یعنی HTML مستقیم داخل جاوااسکریپت نوشته میشه. این یعنی منطق و ساختار تو یه فایل و یه زبون هستن، که برای بعضیها طبیعیتره و برای بعضی دیگه ادغام دو دنیای متفاوت به نظر میرسه.
Vue از Single-File Component ها (فایلهای .vue) استفاده میکنه که سه بخش جدا داره: <template> برای HTML، <script> برای منطق، و <style> برای CSS، همه تو یه فایل ولی از هم مجزا. این ساختار برای کسایی که از پسزمینهی HTML/CSS سنتی میان، معمولاً آشناتر و راحتتر برای شروعه.
منحنی یادگیری
Vue معمولاً بهعنوان فریمورک سادهتر برای شروع شناخته میشه؛ مستندات رسمیش هم به همین دلیل معروفه که خیلی واضح و گامبهگامه. مفاهیم پایه (directive هایی مثل v-if، v-for، v-model) خیلی شبیه HTML گسترشیافته هستن و برای کسی که تازه شروع کرده، ورودی نرمتری فراهم میکنن.
React برای شروع هم سخت نیست، ولی چون خودش فقط کتابخونهی UI است، رسیدن به یه استک کامل (routing، state management، فرمها، styling) یعنی باید چند تا کتابخونهی جدا رو هم یاد بگیری، و هر کدوم فلسفهی خودشون رو دارن. همینطور مفاهیمی مثل closure، dependency array تو useEffect، و re-render logic، برای تازهکارها معمولاً چالشبرانگیزترن.
اکوسیستم و بازار کار
اینجا React بهوضوح جلوتره. اکوسیستمش بزرگتره، تعداد کتابخونههای شخص ثالث بیشتره، و تو بازار کار (بهخصوص تو شرکتهای بزرگ آمریکایی و اروپایی) تقاضای بیشتری داره؛ خیلی از این تقاضا هم به خاطر React Native برای توسعهی موبایله که مستقیم از همون دانش React استفاده میکنه.
Vue تو کشورهایی مثل چین و بعضی جاهای اروپا و آسیا محبوبیت بالایی داره، و اکوسیستمش هم بهطور پیوسته در حال رشده (مخصوصاً بعد از معرفی Vue 3 و Composition API)، ولی از نظر حجم موقعیت شغلی جهانی، هنوز از React عقبتره.
Next.js و Nuxt: وقتی فریمورکهای بالادستی وارد میشن
امروز خیلی از پروژههای واقعی مستقیم از React یا Vue خام استفاده نمیکنن، بلکه از یه meta-framework روی همون پایه استفاده میکنن. برای React، Next.js استاندارد de facto شده؛ server-side rendering، routing فایل-محور، و بهینهسازیهای image/font رو بهصورت آماده میده. برای Vue، معادلش Nuxt است که همون فلسفه رو دنبال میکنه. اگه داری یه پروژهی جدید شروع میکنی، احتمالاً سؤال واقعیت نه «React یا Vue»، بلکه «Next.js یا Nuxt» است، چون اینها تصمیمات معماری بیشتری رو از قبل برات گرفتن.
کدوم رو انتخاب کنیم
اگه تیمت از قبل با جاوااسکریپت راحته و میخواد از یه اکوسیستم بزرگ، فرصت شغلی بیشتر، و قابلیت اشتراک کد با موبایل (از طریق React Native) بهره ببره، React انتخاب امنتریه؛ مخصوصاً برای پروژههای بزرگ و تیمهای بزرگ که به انعطاف معماری نیاز دارن.
اگه دنبال یه منحنی یادگیری ملایمتر، مستندات واضح، و یه استک هماهنگ و رسمی (بدون نیاز به تصمیمگیریهای زیاد دربارهی کتابخونهها) هستی، یا تیمت کوچیکتره و میخوای سریعتر به نتیجه برسی، Vue گزینهی راحتتریه.
نکتهی آخر اینه که از نظر عملکرد خام، هر دو فریمورک برای اکثریت قریببهاتفاق پروژهها بهاندازهی کافی سریع هستن؛ تفاوت عملکردشون تو دنیای واقعی بهندرت فاکتور تعیینکنندهست. انتخاب واقعی معمولاً بیشتر به تجربهی تیم، اکوسیستم مورد نیاز، و فلسفهی توسعهای که باهاش راحتتری برمیگرده، نه یه برتری فنی قطعی یکی نسبت به اون یکی.
به چه چیزهایی دسترسی داره و به چه چیزهایی نه
از نظر دسترسی داده، Agent Lee میتونه به تنظیمات zone، رکوردهای DNS، قوانین فایروال و WAF، اسکریپتها و route های Workers، اسم باکتهای R2، تنظیمات Cloudflare Tunnel، و متادیتای پلن و مصرف اکانت سر بزنه. در مقابل، به روشهای پرداخت، تاریخچهی صورتحساب، پسورد و API token ها، لاگهای خام یا دادهی Logpush، و دادهی اکانتهای دیگه هیچ دسترسیای نداره.
مکالمات بهصورت جدا برای هر کاربر، با استفاده از Durable Objects ذخیره میشن و طبق سیاست نگهداری دادهی کلادفلر تا یک سال باقی میمونن. یه نکتهی جالب اینه که فعلاً Agent Lee به مکالمات قبلی رجوع نمیکنه؛ یعنی هر سشن از صفر شروع میشه و چیزی از گفتگوهای قبلی به یاد نمیمونه.
محدودیتهاش
Agent Lee نمیتونه اسکریپت Workers بنویسه یا کد اپلیکیشن تولید کنه، جایگزین پشتیبانی کلادفلر برای مسائل صورتحساب یا بازیابی اکانت نیست، و بین چند اکانت مختلف کار نمیکنه؛ هر سشن محدود به همون اکانتیه که باهاش لاگین کردی. همچنین کاملاً اختیاریه: اگه پنل Ask AI رو باز نکنی، هیچ دادهای بهش فرستاده نمیشه.
در حال حاضر کجا در دسترسه
فعلاً Agent Lee تو مرحلهی beta هست و فقط برای اکانتهای پلن Free در دسترسه. طبق اعلام کلادفلر، این ویژگیها و رفتارها ممکنه تغییر کنن، پس اگه امروز باهاش کار میکنی، انتظار داشته باش رفتارش تو ماههای آینده تکامل پیدا کنه.
Deno: امنیت و سازگاری با استانداردهای وب
Deno رو همون کسی ساخته که اصلاً Node.js رو ساخته بود (Ryan Dahl)، با هدف رفع کردن چیزهایی که خودش بعداً تو طراحی Node.js مشکل میدید. دو تا ویژگی Deno رو از بقیه متمایز میکنه:
مدل امنیتی sandbox: بر خلاف Node که بهصورت پیشفرض دسترسی کامل به فایلسیستم، شبکه، و متغیرهای محیطی داره، Deno بهصورت پیشفرض هیچکدوم از اینها رو نداره. باید صراحتاً اجازه بدی:
# اجرای یه اسکریپت با دسترسی محدود به فایلسیستم و شبکه
deno run --allow-read --allow-net server.ts
این مدل خصوصاً وقتی داری کد third-party رو اجرا میکنی، امنیت بیشتری میده؛ یه پکیج مخرب نمیتونه بیاجازه به شبکه یا فایلسیستمت دسترسی پیدا کنه.
پشتیبانی native از TypeScript و ES module: Deno هم مثل Bun نیازی به مرحلهی جدا برای TypeScript نداره، و بهجای node_modules، از import مستقیم URL یا specifier های npm پشتیبانی میکنه، شبیه به چیزی که تو مرورگر میبینی.
نقطهضعف Deno نسبت به Bun و Node، اکوسیستم کوچیکتره؛ هرچند تو نسخههای اخیر سازگاری خوبی با npm پیدا کرده، ولی هنوز بعضی پکیجها یا ابزارهای خیلی وابسته به Node API ممکنه بدون تنظیم اضافه درست کار نکنن.
جدول مقایسهی سریع
ویژگی
Node.js
Bun
Deno
موتور جاوااسکریپت
V8
JavaScriptCore
V8
TypeScript native
نه (نیاز به compile)
بله
بله
مدل امنیتی
دسترسی کامل پیشفرض
دسترسی کامل پیشفرض
sandbox، نیاز به اجازهی صریح
بلوغ اکوسیستم
خیلی بالا
متوسط، در حال رشد
متوسط
سرعت نصب پکیج
متوسط
بالا
بالا
کدوم رو انتخاب کنیم
اگه داری یه پروژهی production میسازی که قراره رو زیرساختهای موجود deploy بشه، یا تیمت از قبل با Node راحته، همچنان Node.js امنترین انتخابه؛ اکوسیستمش از همه بالغتره و احتمال برخورد با مشکلات سازگاری خیلی کمتره.
اگه سرعت (چه سرعت توسعه، چه سرعت اجرا) برات اولویته و میخوای بدون درگیر شدن با تنظیمات اضافه مستقیم TypeScript بنویسی، Bun گزینهی جذابیه، مخصوصاً برای پروژههای جدید یا اسکریپتها و ابزارهای داخلی که وابستگی سنگینی به پکیجهای خیلی خاص ندارن.
اگه امنیت برات اولویت بالایی داره (مثلاً داری کد نامعتمد یا third-party اجرا میکنی)، یا میخوای کدی بنویسی که تا حد امکان به استانداردهای وب نزدیک باشه، Deno انتخاب منطقیتریه.
در نهایت، هر سهشون فعال توسعه داده میشن و هیچکدوم انتخاب اشتباهی نیست؛ سؤال واقعی اینه که پروژهت به چه چیزی بیشتر نیاز داره: بلوغ و سازگاری، سرعت خام، یا امنیت و استانداردهای مدرن.
وقتی میگی «من از Observer استفاده کردم»، طرف مقابل فوری میفهمه ساختار کد چجوریه، بدون اینکه لازم باشه خط به خط بخونتش.
مشکلی که الان داری حلش میکنی، احتمالاً قبلاً هزاران بار توسط بقیه حل شده. چرا دوباره از صفر شروع کنی؟
خیلی از این پترنها دقیقاً واسه این طراحی شدن که وقتی نیاز جدید اومد، مجبور نباشی کد قدیمی رو دستکاری کنی.
کدی که رو یه پترن شناختهشده بنا شده، هم واسه بقیه راحتتر خونده میشه، هم واسه خودت تو شش ماه آینده.
Design Pattern با Architecture چه فرقی داره
این سوالی هست که تقریباً همهی تازهکارها میپرسن. Architecture تصمیمیه که رو کل سیستم تاثیر میذاره؛ مثلاً اینکه پروژهت Microservices باشه یا Monolith. دیزاین پترن اما رو یه مقیاس خیلی کوچیکتر عمل میکنه، یه کلاس یا چند تا کلاس مرتبط. به زبون ساده، Architecture میگه ساختمونت چند طبقه باشه و اتاقها کجا باشن، ولی دیزاین پترن میگه هر در چجوری باز و بسته بشه.
بریم سراغ خود پترنها
پترنهای کلاسیک GoF تو سه دسته جا میگیرن: ساختی، ساختاری، و رفتاری. بذار چندتاشون رو با کد نشون بدم تا دستت بیاد قضیه از چه قراره.
۱. Creational (پترنهای ایجادی یا سازنده — به نحوهی ساخته شدن اشیا مربوطن)
Singleton احتمالاً معروفترین و در عین حال بحثبرانگیزترین پترنه. کارش اینه که مطمئن بشه فقط یه نمونه از یه کلاس تو کل برنامه وجود داره، مثلاً واسه یه اتصال به دیتابیس یا یه سرویس Config:
class Database:
    _instance = None

    def __new__(cls):
        if cls._instance is None:
            cls._instance = super().__new__(cls)
        return cls._instance
هر بار که Database() رو صدا بزنی، همون نمونهی قبلی رو بهت برمیگردونه، نه یه نمونهی جدید.
Factory Method منطق ساخت شی رو از کد اصلی جدا میکنه. مثلاً یه سیستم پرداخت که بسته به نوع درگاه، آبجکت مناسب رو میسازه:
class PaymentFactory:
    def create_payment(self, method):
        if method == "paypal":
            return PayPalPayment()
        elif method == "stripe":
            return StripePayment()
اضافه کردن یه درگاه جدید یعنی فقط یه elif دیگه یا حتی بهتر، یه dictionary mapping؛ نه اینکه کل کد پرداخت رو زیر و رو کنی.
Decorator بهت اجازه میده یه قابلیت جدید به یه شی اضافه کنی بدون اینکه ساختار اصلیش رو تغییر بدی. دقیقاً همون کاری که میدلورهای Express انجام میدن:
app.use(logger);       // یه لایه رفتار جدید
app.use(authenticate);  // یه لایه دیگه
app.use(rateLimiter);   // و یکی دیگه
هر Middleware یه لایه رفتار به Request اضافه میکنه، بدون اینکه به کد اصلی Request دست بزنه.
Adapter هم یه چیز خیلی رایجه؛ وقتی یه کتابخونهی قدیمی خروجی XML میده ولی بقیه سیستمت با JSON کار میکنه، یه Adapter میذاری وسط که این ناسازگاری رو حل کنه. Facade هم مشابهشه، فقط به جای سازگار کردن دو تا اینترفیس، یه اینترفیس ساده رو میذاره جلوی یه سیستم پیچیده — مثل یه کلاس VideoConverter که پشت صحنه دهها کلاس پیچیده رو مدیریت میکنه ولی خودش فقط یه متد ساده داره.
۳. Behavioral (پترنهای رفتاری — به نحوهی ارتباط بین اشیا مربوطن)
Strategy بهت اجازه میده الگوریتم رو تو زمان اجرا عوض کنی، بدون اینکه کلاس اصلی رو دستکاری کنی:
class RoutingStrategy:
    def calculate_route(self, start, end):
        raise NotImplementedError

class WalkingRoute(RoutingStrategy):
    def calculate_route(self, start, end):
        # منطق مسیریابی پیاده
        pass

class DrivingRoute(RoutingStrategy):
    def calculate_route(self, start, end):
        # منطق مسیریابی با ماشین
        pass
دقیقاً همین اتفاقی که تو اپلیکیشنهای نقشه میافته، وقتی بین پیاده، ماشین یا دوچرخه سوییچ میکنی.
Observer هم شاید پرکاربردترین پترن رفتاری باشه. وقتی وضعیت یه شی تغییر میکنه، خودکار به بقیه خبر میده — دقیقاً همون مکانیزمی که پشت نوتیفیکیشن اینستاگرام یا تلگرامه. با هر پست جدید، همهی فالوورها مطلع میشن، بدون اینکه پستکننده لازم باشه بدونه دقیقاً کیا دارن گوش میدن.
بقیهی پترنها هم همین منطق رو دارن: Builder واسه ساخت اشیای پیچیده مرحله به مرحله (مثل ساخت یه Request تو Retrofit)، Command واسه تبدیل یه درخواست به یه شی مستقل (مثل دکمهی Undo تو ادیتورها)، State واسه تغییر رفتار بر اساس وضعیت داخلی (مثل وضعیت سفارش آنلاین: در حال پردازش، ارسالشده، لغوشده)، و Iterator واسه پیمایش یه مجموعه بدون افشای ساختار داخلیش (همون کاری که for-of تو جاوااسکریپت انجام میده).
کی این پترنها رو کنار بذاریم
این بخش شاید مهمتر از خود پترنها باشه. خیلی از برنامهنویسهای تازهکار، بعد از یادگیری این الگوها، سعی میکنن همهجا ازشون استفاده کنن. این کار معمولاً نتیجهی عکس میده.
اگه یه کلاس ساده کارت رو راه میندازه، لازم نیست بپیچیش تو یه Factory یا Strategy. اگه هدفت از استفادهی یه پترن اینه که خودتو حرفهای نشون بدی نه اینکه یه مشکل واقعی حل کنی، احتمالاً داری کد رو واسه بقیه سختتر میکنی. اگه پروژهت یه اسکریپت یکبار مصرف یا یه MVP سریعه، این سرمایهگذاری اضافه شاید هیچوقت به بازده نرسه. و اگه فریمورکی که داری استفاده میکنی از قبل این پترن رو تو خودش داره (خیلی از فریمورکهای مدرن Dependency Injection یا Observer رو بیلتاین دارن)، دوباره پیادهسازیش کردن دستی فقط تکرار کاره.
در کل یه قانون مهم که باید درنظر بگیری: این پترنها رو وقتی جدی بگیر که کدت داره به جایی میرسه که هر تغییر کوچیک چند جای دیگه رو هم میشکنه، یا وقتی میدونی چیزی میسازی که قراره تو آینده گسترش پیدا کنه. تا اون موقع، ساده نوشتن معمولاً بهتر از over-engineering کردنه.
اگه دیزاین پترنها رو صرفاً یه لیست ۲۳ تایی اسم عجیب ببینی، خیلی زود فراموششون میکنی. ولی اگه هر پترن رو جواب یه مشکل واقعی در نظر بگیری، کمکم میبینی خیلی از فریمورکها و پروژههای بزرگی که هر روز باهاشون کار میکنی، دقیقاً رو همین ایدهها ساخته شدن.
با curl میتونی method رو با -X مشخص کنی، هر تعداد header دلخواه با -H اضافه کنی، body رو با -d بفرستی، و حتی response headers رو با -i ببینی. wget هم میتونه بعضی از این کارها رو انجام بده (مثلاً --header و --post-data)، ولی سینتکسش برای اینجور کارها اصلاً طراحی نشده و خیلی زود دستوپاگیر میشه. برای همین تقریباً هیچوقت نمیبینی کسی wget رو برای تست API پیشنهاد بده.
دانلود recursive و آینه کردن یه سایت
اینجا برعکس میشه. اگه بخوای یه سایت کامل یا یه پوشه از فایلها رو recursive دانلود کنی:
این دستور تمام لینکهای داخل صفحه رو تا عمق دو سطح دنبال میکنه و دانلود میکنه، بدون اینکه از مسیر والد بره بیرون. curl اصلاً همچین قابلیتی نداره؛ چون از پایه برای گرفتن یه URL مشخص طراحی شده، نه دنبال کردن ساختار یه سایت.
ادامه دادن دانلود قطعشده
هر دو ابزار این قابلیت رو دارن، ولی رفتار پیشفرضشون فرق داره:
# wget: با -c دانلود ناقص رو از همونجا ادامه میده
wget -c https://example.com/large-file.iso
# curl: با -C - همین کار رو میکنه
curl -C - -O https://example.com/large-file.iso
هر دو این کار رو با چک کردن سایز فایل موجود و فرستادن یه Range header انجام میدن، ولی wget این رفتار رو سادهتر و با کانتکست دانلود فایل طراحی کرده (مثلاً retry خودکار در صورت قطع شدن اتصال با --tries).
جمعبندی: کدوم رو کِی استفاده کنیم
اگه داری یه API رو تست میکنی، یه request سفارشی با header و body خاص میفرستی، یا میخوای response رو دقیق بررسی کنی، curl انتخاب درسته؛ کنترلی که رو جزئیات HTTP بهت میده رقیب نداره.
اگه هدفت دانلود یه فایل بزرگ (مخصوصاً تو یه اسکریپت یا کرونجاب بدون نظارت مستقیم)، یا گرفتن recursive یه سایت یا یه ساختار پوشهست، wget انتخاب راحتتریه؛ چون همین کارها دقیقاً چیزیه که براش ساخته شده و نیازی به فلگهای اضافه برای رفتار پایه نداره.
نکتهی آخر اینکه تو خیلی از distro های لینوکس امروز، هر دو ابزار از قبل نصب هستن، پس هزینهی نگهداشتن هر دو تو ابزارهای روزمرهت تقریباً صفره؛ لازم نیست حتماً یکیشون رو انتخاب کنی و کنار بذاری.
این برعکس روشیه که خیلی از برنامهنویسها عادت دارن: اول کد رو مینویسن، بعد سعی میکنن براش تست بنویسن. تو اون حالت، تستها معمولاً فقط تأیید میکنن که کد چیکار میکنه (نه لزوماً چیزی که باید بکنه)، و چون کد از قبل نوشته شده، خیلی وقتها طراحیش برای تست کردن مناسب نیست؛ مثلاً پر از متدهای استاتیک یا وابستگی مستقیم به دیتابیس.
یه مثال واقعیتر: سرویس ثبتنام کاربر
بیایم یه ویژگی رو با TDD پیش ببریم که واقعاً تو یه پروژهی واقعی هم پیش میاد: سرویسی که یه کاربر جدید رو ثبتنام میکنه. این مثال عمداً یه dependency واقعی (دیتابیس) داره تا نشون بده TDD چطور طراحی رو به سمت قابلتستبودن هول میده.
اول، قبل از نوشتن هیچ کدی، مشخص میکنیم سرویس به چه چیزی نیاز داره: یه repository برای چک کردن و ذخیرهی کاربر. این dependency رو از همون اول بهصورت interface تزریق میکنیم، نه اینکه مستقیم داخل سرویس یه دیتابیس واقعی رو صدا بزنیم:
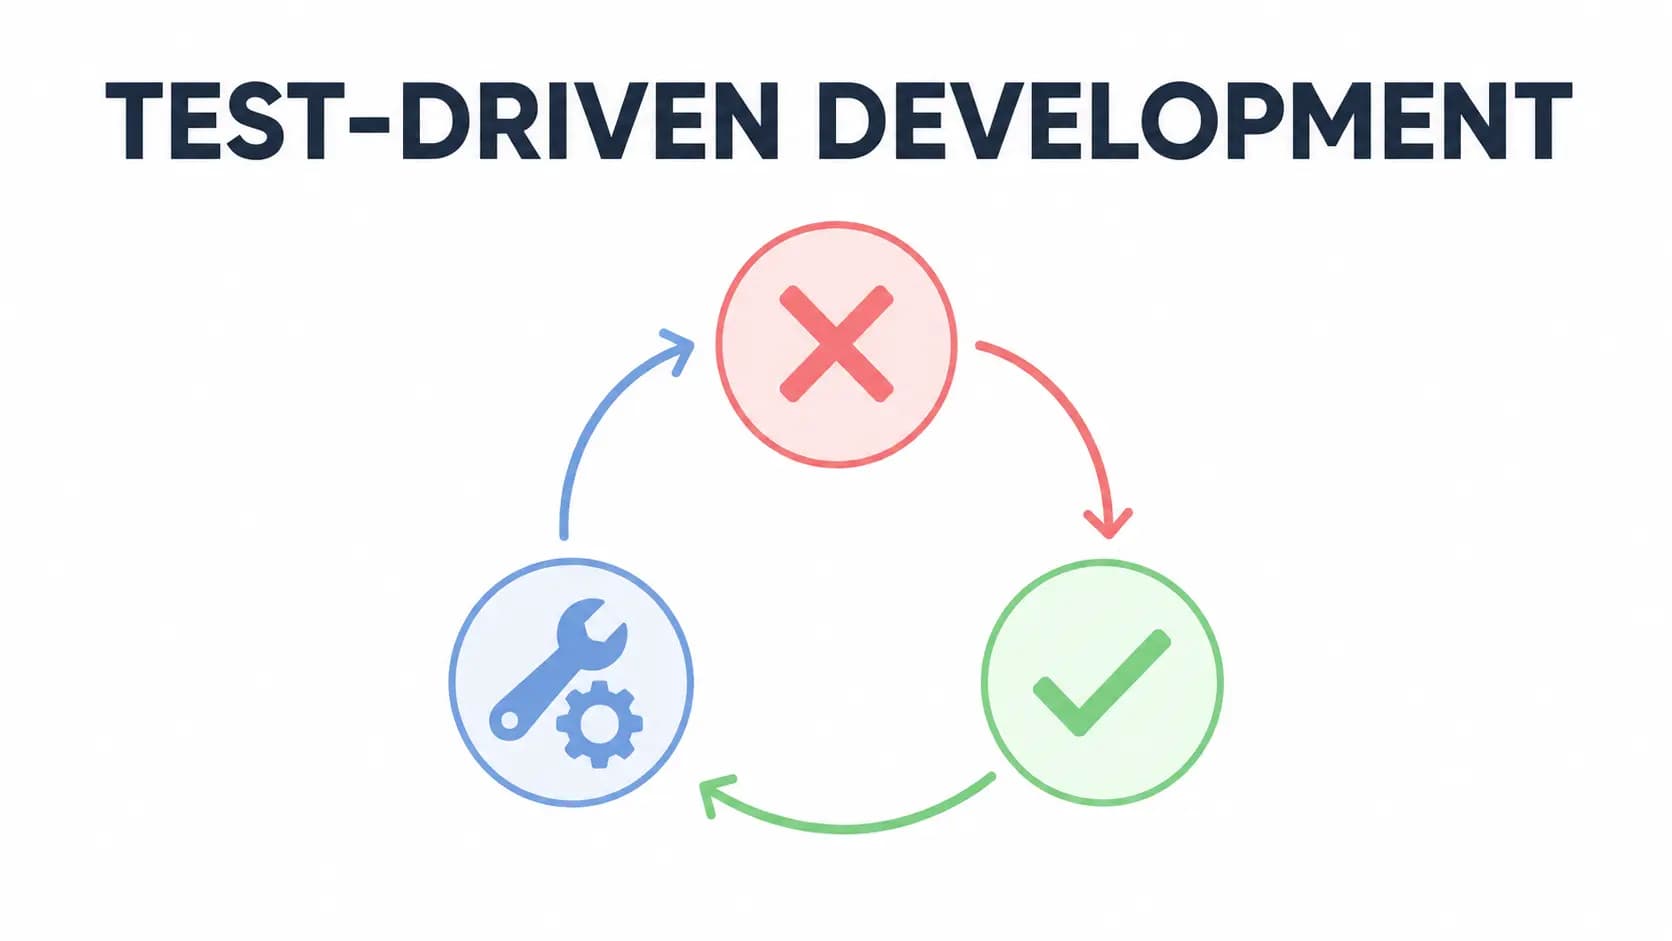
# قدم اول (Red): تستی برای رد کردن ایمیل تکراری
class FakeUserRepository:
    def __init__(self, existing_emails=None):
        self.existing_emails = existing_emails or set()
        self.saved_users = []

    def email_exists(self, email):
        return email in self.existing_emails

    def save(self, user):
        self.saved_users.append(user)

def test_rejects_duplicate_email():
    repo = FakeUserRepository(existing_emails={"ali@example.com"})
    service = UserRegistrationService(repo)

    result = service.register("ali@example.com", "password123")

    assert result.success is False
    assert result.error == "EMAIL_ALREADY_EXISTS"
    assert len(repo.saved_users) == 0
چون UserRegistrationService هنوز وجود نداره، این تست fail میشه. حالا کمترین کد ممکن رو مینویسیم تا سبز بشه:
# قدم دوم (Green)
class RegistrationResult:
    def __init__(self, success, error=None):
        self.success = success
        self.error = error

class UserRegistrationService:
    def __init__(self, repository):
        self.repository = repository

    def register(self, email, password):
        if self.repository.email_exists(email):
            return RegistrationResult(success=False, error="EMAIL_ALREADY_EXISTS")
        self.repository.save({"email": email, "password": password})
        return RegistrationResult(success=True)
حالا یه تست جدید برای قانون بعدی اضافه میکنیم؛ رد کردن پسورد ضعیف:
def test_rejects_weak_password():
    repo = FakeUserRepository()
    service = UserRegistrationService(repo)

    result = service.register("new@example.com", "123")

    assert result.success is False
    assert result.error == "PASSWORD_TOO_WEAK"
    assert len(repo.saved_users) == 0

def test_successful_registration_saves_user():
    repo = FakeUserRepository()
    service = UserRegistrationService(repo)

    result = service.register("new@example.com", "password123")

    assert result.success is True
    assert repo.saved_users[0]["email"] == "new@example.com"
با اضافه شدن این تستها، سرویس رو گسترش میدیم:
# قدم سوم (Green + Refactor)
class UserRegistrationService:
    MIN_PASSWORD_LENGTH = 8

    def __init__(self, repository):
        self.repository = repository

    def register(self, email, password):
        if self.repository.email_exists(email):
            return RegistrationResult(success=False, error="EMAIL_ALREADY_EXISTS")
        if len(password) < self.MIN_PASSWORD_LENGTH:
            return RegistrationResult(success=False, error="PASSWORD_TOO_WEAK")
        self.repository.save({"email": email, "password": password})
        return RegistrationResult(success=True)
نکتهی مهم اینجا FakeUserRepository است. چون از همون اول تصمیم گرفتیم دیتابیس رو بهصورت یه dependency قابل تزریق طراحی کنیم (نه اینکه مستقیم داخل سرویس به یه دیتابیس واقعی وصل بشیم)، تونستیم منطق ثبتنام رو کاملاً بدون نیاز به دیتابیس واقعی، سریع و ایزوله تست کنیم. این دقیقاً همون تأثیریه که TDD روی طراحی میذاره: مجبورت میکنه از اول به شکل قابلتست فکر کنی.
مزیتهایی که معمولاً کمتر بهشون اشاره میشه
فراتر از اینکه «باگ کمتر میشه»، TDD یه فایدهی مهم دیگه هم داره: تستها بهعنوان مستندات زنده عمل میکنن. وقتی یه توسعهدهندهی جدید به تیم میپیوندد و میخواد بفهمه یه تابع دقیقاً چه رفتاری داره، خوندن تستهاش خیلی وقتها روشنتر از خوندن کد اصلیه، چون تستها دقیقاً حالتهای مرزی و انتظارات رو مشخص میکنن.
فایدهی دیگه، اعتماد به refactor کردنه. تو کدبیسی که پوشش تست خوبی داره، تغییر دادن یه بخش از کد ترسناک نیست، چون اگه چیزی رو بشکنی، سریع خبردار میشی. بدون این پوشش، خیلی از تیمها از ترس خراب کردن چیزی، از refactor کردن کد قدیمی اجتناب میکنن، حتی وقتی میدونن که کد نیاز به تمیز شدن داره.
TDD موقع ساختن API
وقتی داری یه REST API میسازی، معمولاً با دو لایهی متفاوت طرفی: منطق کسبوکار (business logic) و لایهی HTTP که این منطق رو در قالب endpoint در معرض دید میذاره. اشتباه رایج اینه که TDD رو مستقیم روی endpoint اجرا کنیم؛ یعنی تست بنویسیم که یه request واقعی به /api/users میفرسته و response رو چک میکنه. این کار میشه، ولی اینجور تستها کند هستن (چون سرور واقعی بالا میاد) و وقتی fail میشن، سخته بفهمی مشکل تو لایهی HTTP بوده یا تو منطق کسبوکار.
روش بهتر، جدا کردن این دو لایه و تست کردن هر کدوم جداگانهست. لایهی business logic (مثل همون UserRegistrationService بالا) رو کاملاً بدون درگیر شدن با HTTP، با unit test پیش میبریم. بعد یه لایهی نازک controller/route داریم که فقط مسئول parse کردن request و صدا زدن سرویسه:
اینجا mock_service جای سرویس واقعی نشسته، پس این تستها فقط چک میکنن که controller درست request رو به سرویس پاس میده و status code مناسب رو برمیگردونه؛ نه اینکه منطق ثبتنام درست کار میکنه یا نه (که قبلاً با unit test پوشش دادیمش). این جداسازی باعث میشه هم تستها سریع اجرا بشن، هم وقتی چیزی fail میشه دقیقاً بدونی مشکل کجاست.
برای هر feature تست بنویسیم یا برای کل response؟
این سؤالی است که خیلی وقتها موقع تستنویسی API پیش میاد، و جواب درست «هر دو، ولی تو دو سطح متفاوت» است، نه انتخاب یکی بهجای اون یکی.
بخش اصلی تستها باید سطح feature/قانون کسبوکار باشن؛ یعنی همون چیزی که تو مثال UserRegistrationService دیدیم: یه تست برای ایمیل تکراری، یه تست برای پسورد ضعیف، یه تست برای ثبتنام موفق. این تستها سریع هستن، نیازی به بالا اومدن سرور واقعی ندارن، و وقتی fail میشن دقیقاً مشخصه کدوم قانون شکسته. اگه فقط به تست کردن کل response اکتفا کنی، وقتی یه تست fail بشه فقط میفهمی «یه جای ثبتنام خراب شده»، نه اینکه دقیقاً کدوم قانون.
در کنارش، به تعداد کمتر، به تستهایی هم نیاز داری که واقعاً endpoint رو صدا بزنن و کل response رو چک کنن؛ status code، شکل JSON خروجی، هدرها. این تستها چیزهایی رو میگیرن که unit test نمیتونه: مسیر اشتباه تو routing، خطای serialize شدن، middleware ای که درست کار نمیکنه، یا auth ای که درست وصل نشده. این تستها تضمین میکنن که تکهها واقعاً با هم درست کار میکنن، نه فقط هر کدوم جدا.
یه ترکیب عملی که خوب جواب میده اینه: به ازای هر قانون کسبوکار یا حالت مرزی، یه unit test (که تعدادشون زیاده و ارزون تمومن)، و به ازای هر route فقط چند تا تست سطح endpoint (یه مسیر موفق، و یکی دو تا از رایجترین حالتهای خطا) که فقط تأیید میکنن سیمکشی بین لایهها درسته. این دقیقاً همون ایدهی test pyramid است که چند پاراگراف پایینتر بهش میرسیم؛ یه عالمه تست باریک و سریع تو پایین، و یه لایهی نازکتر از تستهای گستردهتر روش.
علاوه بر این، برای API هایی که قرارداد مشخصی با کلاینت دارن (مثلاً یه فرانتاند جدا یا یه سرویس دیگه که ازش استفاده میکنه)، میتونی از contract test هم استفاده کنی؛ تستی که تضمین میکنه response API همیشه با یه schema مشخص (مثلاً OpenAPI) مطابقت داره، حتی اگه پیادهسازی داخلیش عوض بشه.
TDD موقع ساختن سرویسها و میکروسرویسها
تو معماری میکروسرویس، چالش اصلی TDD اینه که هر سرویس معمولاً به سرویسهای دیگه یا زیرساختهای خارجی (message queue، دیتابیس، یه API خارجی) وابستهست. اگه بخوای برای هر تست، این وابستگیهای واقعی رو بالا بیاری، تستهات هم کند میشن و هم شکننده (چون یه قطعی موقت تو شبکه میتونه تست رو fail کنه، نه لزوماً باگ تو کدت).
راهحل رایج، جدا کردن تستها به چند سطح:
Unit test با fake/mock: درست مثل مثال بالا، منطق داخلی سرویس رو با نسخههای fake از وابستگیهای بیرونی تست میکنیم. این تستها سریعترین و پرتکرارترین بخش هستن.
Integration test محدود: یه لایهی بالاتر، جایی که سرویس واقعاً به یه نسخهی تست از دیتابیس یا message broker وصل میشه (مثلاً با Docker) تا مطمئن بشیم کدی که با اون زیرساخت حرف میزنه (مثل query های SQL یا serialize کردن پیام) درست کار میکنه. این تستها کندترن، پس تعدادشون معمولاً خیلی کمتر از unit test هاست.
Contract test بین سرویسها: وقتی سرویس A از سرویس B استفاده میکنه، بهجای اینکه تو تستهای سرویس A واقعاً سرویس B رو صدا بزنی، یه قرارداد مشخص (مثلاً با Pact) تعریف میکنی که هر دو طرف بهش پایبند میمونن. این باعث میشه بتونی سرویسها رو مستقل از هم توسعه و deploy کنی، بدون اینکه برای هر تغییر کوچیک مجبور باشی کل زنجیره رو بالا بیاری.
این هرم (تعداد زیاد unit test، تعداد متوسط integration test، و تعداد کم contract/end-to-end test) دقیقاً همون چیزیه که بهعنوان test pyramid شناخته میشه، و TDD معمولاً بیشترین کاربردش رو تو پایینترین لایهی این هرم، یعنی unit test ها داره.
کجا TDD بهسختی جواب میده
TDD همیشه ابزار مناسبی نیست. برای کدی که ماهیتش اکتشافیه (مثلاً وقتی داری با یه API خارجی آشنا میشی یا یه پروتوتایپ سریع میسازی تا ببینی یه ایده اصلاً شدنیه یا نه)، نوشتن تست قبل از اینکه بدونی حتی چه شکلی قراره باشه راهحل نهایی، میتونه بیشتر وقتگیر باشه تا مفید. همینطور برای UI هایی که رفتارشون بیشتر بصریه تا منطقی، نوشتن تستهای یونیت خیلی وقتها کمک چندانی نمیکنه و باید سراغ ابزارهای دیگهای مثل تستهای end-to-end یا visual regression رفت.
یه اشتباه رایج دیگه اینه که تیمها سعی میکنن TDD رو صددرصد و برای هر خط کد اجرا کنن، در حالی که هدف اصلی این نیست که هر تابعی حتماً از قبل تست داشته باشه، بلکه اینه که فرآیند فکر کردن قبل از نوشتن کد، طراحی بهتری بسازه. جایی که این فرآیند فایده نداره (مثل کد اکتشافی یا اسکریپت یکبار مصرف)، اصراف روی TDD فقط باعث کندی بدون سودِ متناسب میشه.
تو نسخهی دوم، اضافه کردن یه نوع تخفیف جدید یعنی فقط یه کلاس جدید نوشتن، بدون اینکه به تابع اصلی دست بزنی. این دقیقاً همون چیزیه که ریسک شکستن رفتار قدیمی رو کم میکنه.
L — Liskov Substitution Principle
این اصل میگه هر جا که یه کلاس پایه استفاده میشه، باید بشه بهجاش از هر کدوم از زیرکلاسهاش استفاده کرد، بدون اینکه رفتار برنامه خراب بشه. مثال معروفش مشکل مربع و مستطیله:
class Rectangle:
    def set_width(self, w): self.width = w
    def set_height(self, h): self.height = h
    def area(self): return self.width * self.height

class Square(Rectangle):
    def set_width(self, w):
        self.width = w
        self.height = w  # چون مربعه، عرض و ارتفاع باید برابر بمونن
    def set_height(self, h):
        self.width = h
        self.height = h
از نظر ریاضی، مربع نوع خاصی از مستطیله، ولی از نظر رفتار برنامه، Square قرارداد Rectangle رو نقض میکنه؛ چون تغییر عرض بهطور غیرمنتظره ارتفاع رو هم تغییر میده. اگه یه تابع فرض کنه با set_width فقط عرض عوض میشه و ارتفاع دستنخورده میمونه، وقتی همون تابع با یه Square صدا زده بشه، رفتار غلطی میگیره. این مثال نشون میده که ارثبری باید بر اساس رفتار طراحی بشه، نه صرفاً بر اساس رابطهی مفهومی «این یه نوع از اونه».
I — Interface Segregation Principle
این اصل میگه هیچ کلاسی نباید مجبور بشه به متدهایی وابسته باشه که ازشون استفاده نمیکنه. تصور کن یه interface بزرگ برای Worker داری:
class Worker:
    def work(self): raise NotImplementedError
    def eat(self): raise NotImplementedError
اگه بخوای یه RobotWorker بسازی، مجبوری متد eat رو هم پیادهسازی کنی، در حالی که هیچ معنایی برای یه ربات نداره. راهحل اینه که این interface بزرگ رو به دو تا interface کوچیکتر بشکنیم: Workable و Eatable، و هر کلاس فقط اونی رو implement کنه که واقعاً بهش نیاز داره. این اصل خیلی وقتها تو زبانهایی مثل جاوا یا TypeScript که interface صریح دارن پررنگتره، ولی همون فلسفه تو پایتون هم با duck typing و ترکیب کلاسهای کوچیکتر قابل اعماله.
D — Dependency Inversion Principle
این اصل میگه ماژولهای سطح بالا نباید مستقیم به ماژولهای سطح پایین وابسته باشن؛ هر دو باید به یه abstraction وابسته باشن. مثال رایجش وابستگی مستقیم به یه دیتابیس خاصه:
# طراحی بد
class UserService:
def __init__(self):
self.db = MySQLDatabase() # وابستگی سخت به یه پیادهسازی خاص
# طراحی خوب
class UserService:
def __init__(self, db: DatabaseInterface):
self.db = db # هر چیزی که این interface رو implement کنه قابل تزریقه
با نسخهی دوم، میتونی بهراحتی تو تستها یه mock database تزریق کنی، یا بعداً از MySQL به PostgreSQL سوییچ کنی، بدون اینکه خط به خط UserService رو تغییر بدی. این همون ایدهای هست که پشت dependency injection تو فریمورکهایی مثل Spring یا NestJS قرار داره.
کی این اصول رو کنار بذاریم
نکتهای که خیلی وقتها نادیده گرفته میشه اینه که SOLID برای کدی طراحی شده که قراره رشد کنه و تغییر کنه. اگه داری یه اسکریپت یکبار مصرف مینویسی یا یه پروتوتایپ سریع میسازی، رعایت سفتوسخت این اصول فقط پیچیدگی اضافه میکنه بدون اینکه فایدهی واقعی داشته باشه. مثلاً درست کردن یه abstraction برای یه دیتابیسی که مطمئنی هیچوقت عوض نمیشه، فقط یه لایهی اضافهی بدون کاربرده.
قانونی که خودم بهش رسیدم اینه: این اصول رو وقتی جدی بگیر که کدت داره به یه نقطهای میرسه که هر تغییر کوچیک، چند جای دیگه رو هم میشکنه، یا وقتی داری چیزی میسازی که میدونی قراره تو آینده گسترش پیدا کنه. تا اون موقع، ساده نوشتن معمولاً بهتر از over-engineering کردنه.
Build سریعتر
Type checking سریعتر
SSR سریعتر
درخواستهای کمتر برای Prefetch
Cache بهتر برای فایلهای استاتیک
یعنی حتی اگر هیچکدام از قابلیتهای جدید را استفاده نکنی، باز هم احتمالاً تفاوت را حس میکنی.
Turbopack حالا تا ۹۰٪ حافظهی کمتری مصرف میکند
یکی از بزرگترین تغییرات Next.js 16.3 مربوط به Turbopack است.
تا قبل از این نسخه، یکی از شکایتهای رایج دربارهی dev server پروژههای بزرگ، مصرف بالای حافظه بود.
روی یک پروژهی کوچک شاید متوجه نشوی، اما وقتی پروژه چند صد Route، تعداد زیادی dependency و فایلهای زیاد دارد، مصرف RAM میتواند خیلی سریع بالا برود.
در Next.js 16.3 دو قابلیت مهم بهصورت پیشفرض فعال شدهاند:
Disk Cache برای توسعه
Memory Eviction
ترکیب این دو باعث شده Turbopack بتواند بهتر تصمیم بگیرد چه چیزهایی را در حافظه نگه دارد و چه چیزهایی را از RAM خارج کند.
البته مثل همیشه این عددها را نباید کورکورانه برای همهی پروژهها انتظار داشت. نوع پروژه، تعداد Routeها، dependencyها و نحوهی استفاده از Server Componentها تأثیر زیادی دارند.
اما جهت تغییر مشخص است: Turbopack دیگر فقط دنبال سریعتر شدن نیست، بلکه میخواهد در پروژههای واقعی منابع کمتری مصرف کند.
به نظر من این یکی از آن تغییراتی است که توسعهدهندههایی که لپتاپ معمولی دارند بیشتر از همه حسش میکنند.
چون سریع بودن فقط این نیست که یک build چند ثانیه زودتر تمام شود؛ اگر سیستم وسط کار شروع کند به swap کردن و کند شدن، آن سرعت روی کاغذ چندان کاربردی نیست.
Buildهای سریعتر با FileSystem Cache
همان Cacheای که از Next.js 16.1 برای dev معرفی شده بود، حالا وارد مرحلهی بعدی شده و برای next build هم فعال شده است.
ایده ساده است:
اگر قبلاً چیزی محاسبه شده و هنوز معتبر است، دوباره از صفر انجامش نده.
این موضوع مخصوصاً در CI مهم است.
در پروژههایی که مرتب build میشوند، زمان زیادی صرف کارهای تکراری میشود. حالا Turbopack میتواند بخشی از این خروجیها را ذخیره کند و در buildهای بعدی دوباره استفاده کند.
طبق تستهای تیم Next.js، بعضی پروژهها در CI تا ۵.۵ برابر build سریعتر داشتهاند.
این تغییر برای تیمهایی که روزانه چندین deploy انجام میدهند، شاید از هر قابلیت ظاهری دیگری مهمتر باشد.
چون چند ثانیه در یک build شاید مهم نباشد، اما وقتی صدها بار تکرار میشود، تبدیل به زمان واقعی تیم میشود.
TypeScript 7 و Type Checking سریعتر
Next.js 16.3 همزمان با نسل جدید TypeScript آمده است.
TypeScript 7 یک تغییر مهم دارد: بخشهایی از آن با یک پیادهسازی Native بازنویسی شده که هدفش سرعت بالاتر در type checking است.
طبق اعلام تیم TypeScript، این نسخه میتواند در بعضی سناریوها چند برابر سریعتر باشد.
برای استفاده از آن در پروژهی Next.js کافی است نسخهی dependency را تغییر بدهی:
npm i -D typescript@^7
البته اینجا یک نکته وجود دارد.
سرعت بالاتر همیشه به معنی این نیست که همهی پروژهها دقیقاً همان نتیجه را میبینند. پروژههایی با Type پیچیده، monorepoها یا dependencyهای سنگین ممکن است تفاوت بیشتری حس کنند.
اما برای پروژههایی که TypeScript بخش بزرگی از زمان build را میگیرد، این تغییر ارزش بررسی دارد.
رندر سمت سرور سریعتر با Native Node.js Streams
یکی از تغییرات فنی جالب Next.js 16.3 در لایهی رندرینگ App Router اتفاق افتاده است.
برای اینکه مرورگر بتواند محتوا را بهصورت تدریجی دریافت کند، Next.js از Streamها استفاده میکند. این مدل باعث میشود لازم نباشد کاربر تا آماده شدن کل صفحه صبر کند و بخشهای آمادهشده زودتر ارسال شوند.
اما یک مشکل وجود داشت.
در محیط Node.js، Streamهای داخلی Node با Web Streams که در استانداردهای جدید وب استفاده میشوند، یکسان نیستند. در نتیجه بخشی از زمان و منابع صرف تبدیل بین این دو مدل میشد.
در Next.js 16.3 این مسیر تغییر کرده و در لایهی رندرینگ App Router از Native Node.js Streams استفاده میشود.
نتیجه؟
کاهش overhead در SSR.
طبق بنچمارکهای تیم Next.js، اپلیکیشنها در شرایط بار بالا میتوانند تا ۲۲٪ درخواست بیشتری را با همان شرایط پردازش کنند.
یعنی:
وضعیت
عنوان
توضیح
قبل
Web Streams
Baseline
بعد
Native Node.js Streams
+22% Requests
این تغییر شاید چیزی نباشد که هنگام توسعهی روزمره فوراً ببینی، اما روی سرویسهایی که ترافیک بالا دارند، تفاوتش خودش را نشان میدهد.
این هم از آن دسته تغییراتی است که معمولاً کاربران متوجه وجودش نمیشوند؛ فقط متوجه میشوند سایت در فشار بالا بهتر دوام میآورد.
مستندات نسخهبندیشده برای AI Agentها
یکی از مسیرهایی که Next.js در نسخههای جدید جدیتر دنبال میکند، آماده کردن پروژهها برای ابزارهای هوش مصنوعی است.
چند سال پیش اگر کسی میگفت فریمورک باید برای AI Agentها بهینه شود، احتمالاً خیلیها تصور میکردند منظور فقط autocomplete داخل ادیتور است.
اما الان موضوع بزرگتر شده.
Agentها قرار است کد بخوانند، تغییر بدهند، تست اجرا کنند و حتی تصمیمهای معماری پیشنهاد کنند.
مشکل اینجاست که یک Agent بدون اطلاعات کافی دربارهی پروژه، ممکن است تصمیمهایی بگیرد که با ساختار پروژه هماهنگ نیست.
مثلاً:
از API اشتباه استفاده کند.
الگوی قدیمی پروژه را نادیده بگیرد.
قوانین داخلی تیم را رعایت نکند.
Next.js 16.3 با اضافه کردن پشتیبانی بهتر برای Versioned Docs این مسیر را سادهتر میکند.
ایده این است که Agent بتواند به اطلاعات دقیقتر و هماهنگ با نسخهی مورد استفادهی پروژه دسترسی داشته باشد.
یعنی اگر پروژه روی Next.js 16.3 است، Agent لازم نیست از اطلاعات مربوط به نسخههای قدیمیتر استفاده کند.
این تغییر شاید امروز برای همه ضروری نباشد، اما اگر با ابزارهایی مثل Cursor، Claude Code یا Agentهای مشابه کار میکنی، اهمیتش بیشتر میشود.
درخواستهای Prefetch کمتر، کنترل بهتر روی شبکه
یکی از بخشهایی که در Next.js همیشه بین سرعت و مصرف منابع تعادل ایجاد میکرد، Prefetch بود.
Prefetch یعنی قبل از اینکه کاربر روی یک لینک کلیک کند، Next.js حدس بزند که احتمالاً کاربر به آن صفحه میرود و بخشی از اطلاعات را از قبل دریافت کند.
این کار باعث Navigation سریعتر میشود.
اما یک مشکل دارد.
اگر تعداد لینکها زیاد باشد، ممکن است درخواستهای زیادی ایجاد شود؛ حتی برای صفحاتی که کاربر هیچوقت باز نمیکند.
در Next.js 16.3 رفتار Prefetch بهینهتر شده تا درخواستهای غیرضروری کمتر شوند.
هدف این نیست که Prefetch حذف شود؛ چون هنوز یکی از دلایل اصلی حس سریع بودن Next.js است.
هدف این است که هوشمندتر عمل کند.
یعنی:
اطلاعات مهم زودتر آماده شوند.
درخواستهای بیمصرف کمتر شوند.
فشار روی سرور و شبکه کاهش پیدا کند.
Cache بهتر برای Static Assetها
فایلهای استاتیک مثل:
تصویرها
فایلهای CSS
JavaScript bundleها
فونتها
معمولاً باید مدت زیادی Cache شوند.
اما تنظیمات اشتباه Cache میتواند مشکلساز شود.
اگر خیلی کوتاه باشد، کاربر مدام فایلهای تکراری دانلود میکند.
اگر خیلی طولانی باشد، ممکن است نسخهی قدیمی فایل نمایش داده شود.
Next.js 16.3 در این بخش رفتار Cache فایلهای استاتیک را بهتر کرده تا استفاده از منابع شبکه منطقیتر شود.
این تغییر شاید در پروژههای کوچک دیده نشود، اما در سایتهایی که حجم زیادی Asset دارند، میتواند روی سرعت واقعی کاربران تأثیر بگذارد.
Custom Error Boundaries
مدیریت خطا در اپلیکیشنهای بزرگ همیشه یک بخش مهم بوده است.
وقتی یک صفحه یا یک بخش از UI خراب میشود، اینکه کل برنامه از کار بیفتد تجربهی خوبی نیست.
React و Next.js مدتها امکان Error Boundary داشتند، اما Next.js 16.3 کنترلهای بیشتری برای ساخت تجربهی خطای بهتر ارائه میدهد.
هدف این است که بتوانی به جای نمایش یک صفحهی خطای عمومی، رفتار دقیقتری برای بخشهای مختلف برنامه داشته باشی.
مثلاً:
یک بخش از داشبورد خراب شود.
اما منوی اصلی همچنان کار کند.
کاربر بتواند دوباره تلاش کند.
این مدل در اپلیکیشنهای بزرگ اهمیت زیادی دارد.
Built-in Glob Imports؛ وارد کردن فایلها سادهتر میشود
یکی دیگر از تغییرات کوچک اما کاربردی، اضافه شدن قابلیت Glob Import داخلی است.
گاهی در پروژهها لازم است تعداد زیادی فایل را بر اساس یک الگو وارد کنی.
مثلاً:
همهی فایلهای Markdown یک پوشه
همهی کامپوننتهای یک مسیر
همهی فایلهای ترجمه
قبلاً معمولاً برای این کار سراغ ابزارهای جانبی میرفتیم.
حالا Next.js پشتیبانی بهتری برای این سناریوها فراهم کرده است.
این قابلیت شاید به تنهایی دلیل آپدیت نباشد، اما در پروژههای Content-heavy یا سیستمهای بزرگ مدیریت فایل، کار را راحتتر میکند.
Instant Navigation؛ نزدیکتر شدن Next.js به حس SPA
تا اینجا بیشتر دربارهی تغییرات زیرساختی صحبت کردیم.
اما بخشی که احتمالاً کاربران نهایی بیشتر حس میکنند، Navigation جدید است.
یکی از چالشهای همیشگی Next.js این بوده:
چطور سرعت SPA را داشته باشیم، بدون اینکه مزیتهای Server Components و Server Rendering را از دست بدهیم؟
Next.js 16.3 تلاش میکند این فاصله را کمتر کند.
Partial Prefetching
در نسخههای قبلی، Prefetch همیشه یک تعادل سخت داشت.
اگر زیاد Prefetch کنی:
درخواست زیاد میشود.
دادهی اضافی مصرف میشود.
اگر کم Prefetch کنی:
Navigation کندتر حس میشود.
Partial Prefetching راه وسط است.
به جای اینکه کل Route را از قبل آماده کند، فقط بخشهایی که برای شروع Navigation لازم هستند را دریافت میکند.
مثلاً Shell صفحه سریع آماده میشود و بخشهای سنگینتر بعداً میرسند.
نتیجه چیزی شبیه اپلیکیشنهای SPA است، اما با معماری Server-Driven.
Instant Insights؛ فهمیدن اینکه Navigation واقعاً چه اتفاقی میافتد
یکی از مشکلات توسعهدهندهها با اپلیکیشنهای مدرن این است که وقتی یک صفحه کند باز میشود، همیشه مشخص نیست مشکل دقیقاً کجاست.
آیا مشکل از:
دریافت داده از API است؟
Server Component زمان زیادی میبرد؟
Bundle سمت کلاینت بزرگ است؟
Prefetch درست انجام نشده؟
Cache کار نکرده؟
در Next.js 16.3 ابزارهای بهتری برای مشاهدهی رفتار Navigation اضافه شده تا توسعهدهنده بتواند دقیقتر بفهمد هنگام جابهجایی بین صفحات چه اتفاقی میافتد.
این همان چیزی است که در پروژههای بزرگ اهمیت پیدا میکند.
در پروژهی کوچک شاید بگویی:
«این صفحه فقط یک ثانیه دیرتر باز میشود.»
اما در یک محصول واقعی، همین یک ثانیه میتواند نتیجهی چندین مشکل کوچک باشد که پیدا کردنشان بدون ابزار مناسب سخت است.
وقتی یک کاربر روی یک لینک کلیک میکند، اتفاقات زیادی پشت صحنه رخ میدهد.
Next.js باید:
Route را پیدا کند.
دادههای لازم را آماده کند.
Cache را بررسی کند.
Server Componentها را پردازش کند.
نتیجه را به کلاینت برساند.
Navigation Inspector کمک میکند این مسیر واضحتر دیده شود.
این ابزار مخصوصاً برای زمانی کاربردی است که احساس میکنی یک Route باید سریع باشد، اما در عمل نیست.
به جای حدس زدن، میتوانی ببینی زمان دقیق کجا مصرف شده.
این تغییر شاید برای همهی توسعهدهندهها روزانه استفاده نشود، اما برای Debug کردن پروژههای بزرگ ارزش زیادی دارد.
بهبود Incremental Static Regeneration (ISR)
ISR یکی از قابلیتهایی است که باعث شد Next.js در سالهای اخیر بین سایتهای محتوایی و اپلیکیشنهای ترکیبی محبوب شود.
ایده ساده است:
صفحه را Static تولید کن، اما اجازه بده بعداً بدون Build کامل بهروزرسانی شود.
مشکل همیشه این بوده که Cache و Revalidation در پروژههای بزرگ میتواند پیچیده شود.
Next.js 16.3 روی رفتار ISR هم بهبودهایی آورده تا مدیریت این سناریوها قابل پیشبینیتر شود.
این موضوع مخصوصاً برای سایتهایی که:
محتوای زیاد دارند.
تغییرات مداوم دارند.
ولی نمیخواهند هر تغییر باعث Build کامل شود.
مهم است.
تست راحتتر با Playwright Test Helper
تست کردن Navigation و رفتارهای سمت سرور همیشه کمی سختتر از تست کردن کامپوننتهای ساده بوده است.
چون باید رفتار واقعی مرورگر، شبکه، Route و Rendering را هم در نظر بگیری.
Next.js 16.3 یک helper جدید برای Playwright ارائه کرده تا نوشتن تستهای مرتبط با اپلیکیشنهای Next.js راحتتر شود.
این یعنی تست کردن مواردی مثل:
Navigation
Loading State
Error State
رفتارهای App Router
کمتر نیاز به کد تکراری دارد.
برای تیمهایی که تست E2E جدی دارند، این تغییر کوچک نیست.
بهبودهای AI؛ Next.js برای دورهی Agentها آمادهتر میشود
اگر بخشهای مختلف Next.js 16.3 را کنار هم بگذاری، یکی از پیامهای واضح این نسخه این است:
فریمورکها دیگر فقط برای انسانها نوشته نمیشوند.
بخش زیادی از کدنویسی آینده احتمالاً با کمک Agentها انجام میشود.
اما یک Agent خوب فقط با داشتن یک مدل زبانی ساخته نمیشود.
باید:
ساختار پروژه را بفهمد.
قوانین تیم را بداند.
بداند از چه الگوهایی استفاده کند.
بداند کدام API مربوط به کدام نسخه است.
برای همین Next.js روی چند بخش کار کرده است.
AGENTS.md؛ قراردادن قوانین پروژه برای Agentها
اگر با ابزارهای AI کار کرده باشی، احتمالاً این مشکل را دیدهای.
هر بار باید توضیح بدهی:
«در این پروژه از Server Component استفاده کن.»
«این پوشه را تغییر نده.»
«برای API از این الگو استفاده کن.»
«قبل از تغییر، تستها را اجرا کن.»
فایل AGENTS.md قرار است همین اطلاعات را به شکل استاندارد در اختیار Agent قرار دهد.
در واقع یک فایل راهنما برای هوش مصنوعی پروژه است.
چیزی شبیه README، اما با مخاطب متفاوت.
README برای انسانهاست.
AGENTS.md برای Agentها.
Skills؛ اضافه کردن تواناییهای مشخص به Agent
یک Agent عمومی همه چیز را نمیداند.
گاهی میخواهی یک Agent دقیقاً برای یک کار خاص آماده باشد.
مثلاً:
ساخت Componentهای UI
کار با Database
نوشتن تست
مدیریت API
Skills این امکان را میدهد که تواناییهای مشخصتری تعریف شود.
این مدل باعث میشود Agent به جای اینکه هر بار از صفر تصمیم بگیرد، یک مسیر مشخص داشته باشد.
Versioned Docs برای جلوگیری از اشتباه Agentها
یکی از مشکلات رایج ابزارهای AI این است که ممکن است اطلاعات قدیمی استفاده کنند.
مثلاً یک Agent ممکن است کدی پیشنهاد دهد که برای Next.js 14 درست بوده، اما در Next.js 16 روش بهتری وجود داشته باشد.
Versioned Docs کمک میکند Agent اطلاعات هماهنگ با نسخهی واقعی پروژه دریافت کند.
این موضوع در فریمورکهایی مثل Next.js که مرتب تغییر میکنند، اهمیت زیادی دارد.
قابلیتهای آزمایشی Next.js 16.3
همهی تغییرات این نسخه برای استفادهی عمومی آماده نیستند.
چند قابلیت هنوز Experimental هستند.
React Compiler مبتنی بر Rust
React Compiler یکی از پروژههایی است که هدفش بهینهسازی خودکار React است.
ایده این است که کامپایلر بتواند بخشی از بهینهسازیهایی را انجام دهد که قبلاً توسعهدهنده باید دستی انجام میداد.
چیزهایی مثل:
جلوگیری از Render اضافی
مدیریت بهتر Memoization
بهینهسازی محاسبات
نسخهی Rust-based React Compiler تلاش میکند این فرآیند را سریعتر و مقیاسپذیرتر کند.
البته چون هنوز Experimental است، احتمالاً نباید همین فردا آن را روی Production فعال کرد.
اما مسیر آینده مشخص است.
React دارد بیشتر به سمت یک مدل Compiler-driven حرکت میکند.
Network Resilience؛ مقاومتر شدن در برابر مشکلات شبکه
اپلیکیشنهای واقعی همیشه در شرایط ایدهآل اجرا نمیشوند.
کاربر ممکن است:
اینترنت ضعیف داشته باشد.
اتصال لحظهای قطع شود.
درخواستها timeout شوند.
Network Resilience تلاش میکند رفتار اپلیکیشن در این شرایط بهتر شود.
هدف این نیست که مشکل شبکه جادویی حل شود.
هدف این است که برنامه در برابر این اتفاقها رفتار قابل پیشبینیتری داشته باشد.
آیا باید همین حالا به Next.js 16.3 آپدیت کنیم؟
مثل همیشه جواب به پروژه بستگی دارد.
اگر یک پروژهی حساس Production داری که چند هفته است بدون مشکل کار میکند، بهتر است طبق روال معمول:
نسخه را در محیط تست بررسی کنی.
Build را چک کنی.
تستها را اجرا کنی.
بعد منتشر کنی.
اما اگر:
پروژهی بزرگی داری.
RAM زیادی در dev مصرف میشود.
CI Build طولانی است.
از App Router استفاده میکنی.
با ابزارهای AI کار میکنی.
Next.js 16.3 احتمالاً یکی از آن آپدیتهایی است که ارزش امتحان کردن دارد.
چیزی که این نسخه را جالب میکند این نیست که یک API عجیب اضافه کرده.
اتفاق مهمتر این است که تقریباً همهجا کمی بهتر شده.
Turbopack سبکتر شده.
Buildها سریعتر شدهاند.
SSR بهینهتر شده.
Navigation روانتر شده.
و ابزارهای AI حالا بیشتر بخشی از اکوسیستم Next.js محسوب میشوند.
به نظر من Next.js 16.3 بیشتر از اینکه یک نسخهی «با چند قابلیت جدید» باشد، یک قدم برای بالغتر شدن فریمورک است.
قدم بعدی احتمالاً فقط سریعتر کردن اپلیکیشن نیست؛ بلکه ساختن محیطی است که انسان و Agent بتوانند کنار هم راحتتر محصول بسازند.
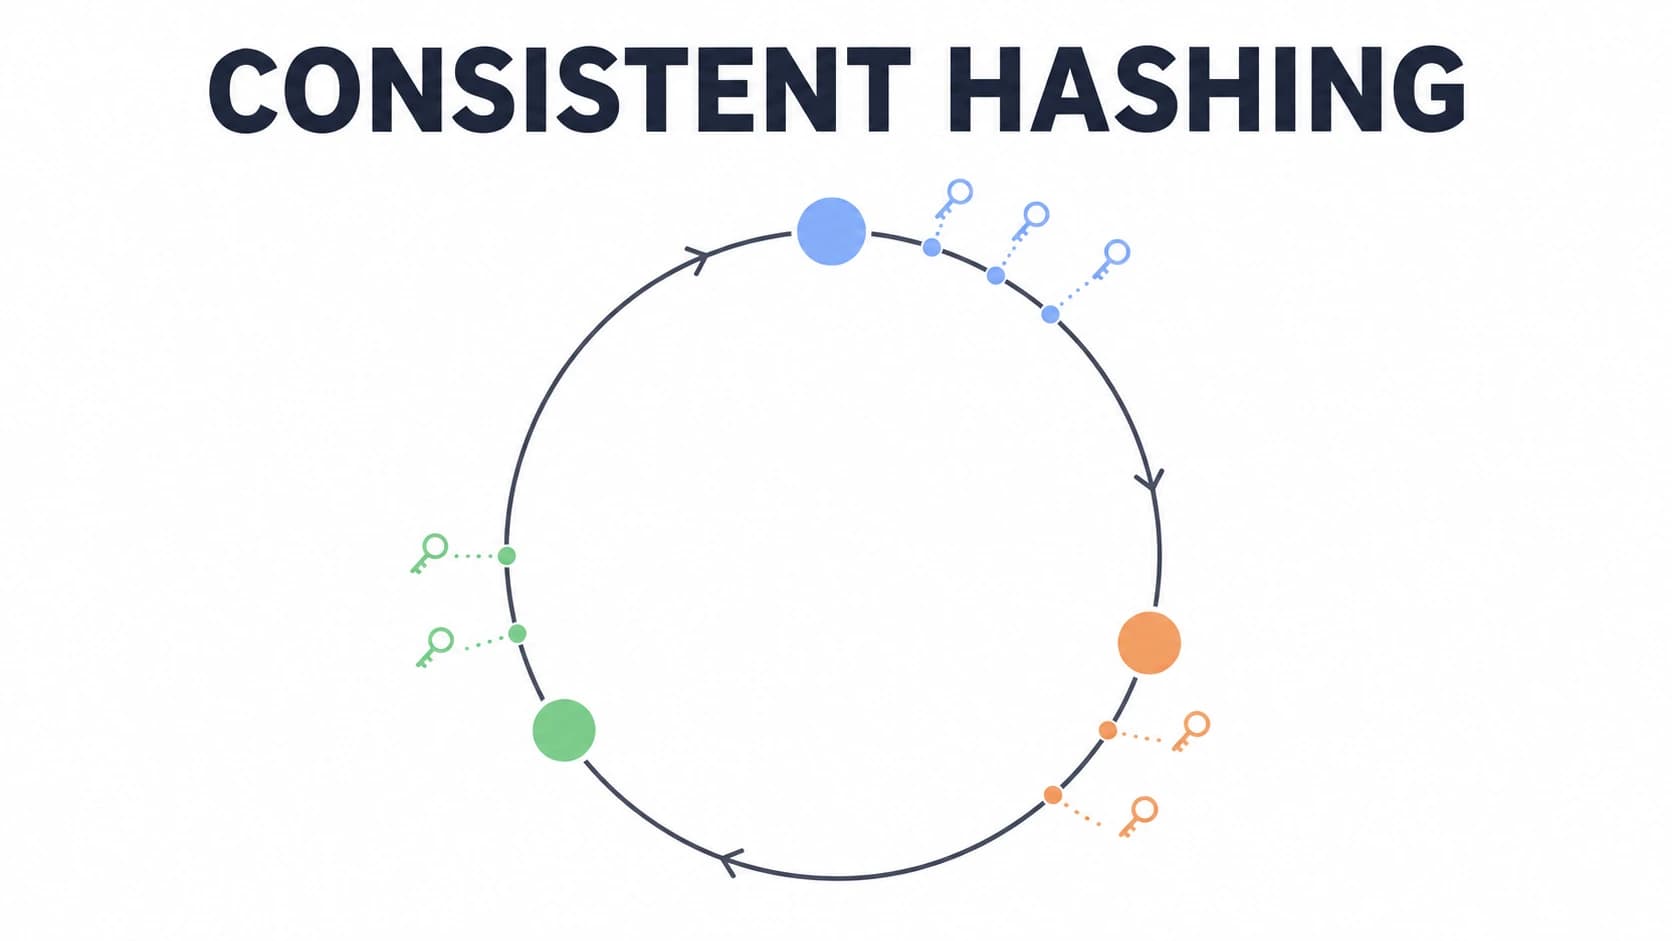
چرا فقط یه نقطه برای هر سرور کافی نیست
اگه هر سرور رو فقط با یه نقطهی واحد روی حلقه نشون بدیم، توزیع کلیدها خیلی نامتوازن میشه؛ ممکنه یه سرور فاصلهی خیلی بزرگی از حلقه رو پوشش بده و یکی دیگه فقط یه بخش کوچیک. راهحل رایج استفاده از virtual node هاست: بهجای یه نقطه، هر سرور فیزیکی رو با چند صد نقطهی مجازی (مثلاً ۱۰۰ تا ۲۰۰ تا) روی حلقه پخش میکنیم. کد بالا دقیقاً همین کار رو با پارامتر replicas انجام میده.
هرچی تعداد virtual node ها بیشتر باشه، توزیع بار بین سرورها یکنواختتر میشه، ولی به قیمت مصرف حافظهی بیشتر برای نگهداشتن این نقاط اضافه. تو عمل، عددی بین ۱۰۰ تا ۵۰۰ virtual node به ازای هر سرور فیزیکی معمولاً تعادل خوبی بین یکنواختی و overhead میده.
کجا واقعاً ازش استفاده میشه
Amazon DynamoDB و Cassandra از consistent hashing برای پارتیشنبندی داده بین node های کلاستر استفاده میکنن؛ این یکی از دلایل اصلیه که این دیتابیسها میتونن node اضافه یا کم کنن بدون اینکه کل کلاستر مجبور به rebalance کامل بشه.
Memcached و سیستمهای caching مشابه هم از همین تکنیک استفاده میکنن تا وقتی یه سرور کش از دسترس خارج میشه، فقط بخش کوچیکی از کشها miss بشن، نه همهشون.
CDN ها و load balancer های توزیعشده هم از نسخههای مشابهی از این ایده برای مسیریابی ترافیک به سمت نزدیکترین یا سالمترین سرور استفاده میکنن، بهطوری که وقتی یه edge server از کار میافته، فقط ترافیک مربوط به همون بخش از حلقه نیاز به جابهجایی داره.
محدودیتهایی که باید بدونی
Consistent hashing مشکل نامتوازنی سرورها رو حل میکنه، ولی خودش یه مشکل دیگه ایجاد میکنه: اگه سرورها ظرفیتهای متفاوتی داشته باشن (مثلاً یکی دو برابر رم بقیه داره)، نمیتونی بهسادگی همه رو با تعداد virtual node یکسان روی حلقه بذاری. راهحلش اینه که تعداد virtual node هر سرور رو متناسب با ظرفیتش تنظیم کنی؛ سروری که ظرفیت دو برابر داره، دو برابر virtual node هم میگیره.
نکتهی دیگه اینه که consistent hashing بهتنهایی replication رو مدیریت نمیکنه. اگه بخوای هر کلید روی چند سرور کپی بشه (برای fault tolerance)، باید علاوه بر پیدا کردن اولین سرور روی حلقه، N سرور بعدی رو هم بهعنوان replica در نظر بگیری؛ همون کاری که Cassandra و DynamoDB زیر پوستشون انجام میدن.