عدد ۷۶.۶٪ مال checkpoint ای هست که روی خود split آموزشی همون بنچمارک fine-tune شده؛ مدل پایهی zero-shot فقط ۳۶.۲٪ گرفته، که حتی از baseline اکثریت (۴۶.۱٪) هم پایینتره.
مقایسهی سرعت، یه inference لوکال روی GPU گرمشده رو با یه فراخوانی API میزبانیشده (که زمان شبکه رو هم شامل میشه) مقایسه میکنه — یعنی سیب و پرتقال.
روی Banking77 که باید بین ۷۷ برچسب intent انتخاب کنی، Jev عدد ۰.۸۷۰ گرفته و Laya فقط ۰.۴۲۵؛ یعنی روی دستهبندیهای با تعداد برچسب بالا، Jev فاصلهی زیادی داره و برای Laya باید سلسلهمراتب coarse-to-fine بسازی.
خود مدلکارت Laya هشدار میده که مدل تا وقتی temperature ش دوباره calibrate نشه، بیشازحد مطمئن (overconfident) خروجی میده — که برای مدلی که ارزشش توی احتمالهای واقعیه، یه نکتهی کوچیک نیست.
یه تست مستقل که هر دو مدل رو روی یه مجموعهی ۴۰۰ تصمیمی و توی یه harness یکسان اجرا کرده، نتیجهی متعادلتری داده: Laya روی دو تا از شش سؤال جلو بوده و توی بقیه Jev برتری داشته. سرعت Laya روی مک بین ۲۰ تا ۵۰ میلیثانیه بوده که واقعاً چشمگیره، ولی دقتش بهطور کلی پایینتر از Jev بوده.
مقایسهی سریع
Jev
Laya
نحوهی ارائه
API میزبانیشده، وزنهای بسته، early access
وزنهای باز (Apache-2.0)، اجرای لوکال
هزینه
حدود ۰.۰۴۲ دلار به ازای هر میلیون توکن ورودی
صفر به ازای هر توکن (فقط هزینهی سختافزار خودت)
تأخیر
چند ده تا چند صد میلیثانیه (شامل شبکه)
۲۰ تا ۵۰ میلیثانیه لوکال
دقت out-of-the-box
بالاتر، مخصوصاً با برچسبهای زیاد
پایینتر بدون fine-tune
زبان
متن انگلیسیمحور
نسخهی چندزبانه با بیش از ۱۰۰ زبان
شخصیسازی
ندارد
میتونی fine-tune و calibrate کنی
داده
باید به API بفرستی
داده هیچوقت از ماشین خودت خارج نمیشه
پس کدوم رو استفاده کنیم؟
جواب صادقانه اینه که اینها جایگزین هم نیستن، دو تا ابزار برای دو تا موقعیت متفاوتن. اگه دقت روی برچسبهای زیاد یا سؤالهای پیچیدهتر براش مهمه، نمیخوای زیرساخت اجرای مدل رو خودت نگه داری، و ارسال داده به یه API خارجی مشکلی نداره، Jev هنوز انتخاب امنتریه. ولی اگه دادههات حساسن و نباید از سرورت خارج بشن، حجم فراخوانی اونقدر بالاست که حتی هزینهی ناچیز به ازای هر توکن هم جمع میشه، تأخیر چنددهمیلیثانیهای برات حیاتیه (مثلاً یه حلقهی کنترل real-time)، یا با متن چندزبانه کار میکنی، Laya قابلتوجهتره — به شرط اینکه حاضر باشی یه مقدار وقت برای fine-tune و calibrate کردنش بذاری.
پیشنهاد عملی من اینه که به هیچکدوم از اعداد منتشرشدهی هیچطرفی تکیه نکنی: ۲۰۰ تا ۵۰۰ نمونهی واقعی از دادهی خودت جمع کن، برچسبگذاریشون کن، و هر دو مدل رو روی همونها امتحان کن. چون Laya رایگانه و توی چند دقیقه نصب میشه، این تست تقریباً بیهزینهست، و نتیجهش خیلی بیشتر از هر بنچمارک عمومی به کارت میاد. اگه Laya روی دادهی تو به دقت قابلقبولی رسید، یه مدل لوکال رایگان با تأخیر چنددهمیلیثانیهای ارزش جدی داره؛ اگه نرسید، هزینهی Jev احتمالاً همچنان از خطاهای اضافی ارزونتره.
از PHP 8.6 به بعد، میتونی به property های readonly مقدار پیشفرض بدی — چیزی که تا الان مجبور بودی حتماً توی constructor مقداردهیش کنی:
final class CreateBooksTable
{
    public readonly string $name = '2026-01-01_create_books_table';
}
این تغییر کاملاً additive هست، یعنی هیچ کد قدیمیای که constructor خودش مقداردهی میکرد رو نمیشکنه.
یه Polling API یکپارچه و native
یکی از فنیترین اضافههای این نسخه یه Polling API واحده که هم توی سطح داخلی PHP و هم توی سطح userland قابل استفادهست. این API بهصورت native از event dispatch سیستمعامل استفاده میکنه: روی لینوکس از epoll، روی مک و BSD از kqueue، و روی ویندوز از WSAPoll. هدف این قابلیت اینه که پایهای برای معماریهای async نسل بعدی PHP باشه، بهجای اینکه هر کتابخونه مجبور باشه خودش یه لایهی polling جدا پیاده کنه.
Duration، یه کلاس رسمی برای زمان
کلاس جدید Time\Duration یه راه رسمی برای نمایش یه بازهی زمانی با دقت نانوثانیهست، شبیه یه stopwatch. متدهای factory برای هر واحد زمانی (ثانیه، میلیثانیه و…)، عملیات ریاضی، و مقایسه رو پشتیبانی میکنه، و حتی میتونی از یه رشتهی ISO 8601 هم بسازیش. ایده اینه که این کلاس بهجای عدد صحیح یا اعشاری خام، بهعنوان یه نوع مشترک بین توابع core و همون Polling API جدید استفاده بشه.
چند تا اضافهی کوچیکتر ولی مفید
کنار این سه ویژگی اصلی، چند تا اضافهی کوچیکتر هم توی PHP 8.6 هست که بهمرور توی کد روزمره حس میشن:
یه تابع سراسری جدید به اسم clamp() که یه مقدار رو در صورت خارج بودن از یه بازه، به نزدیکترین کران محدود میکنه.
توابع reflection جدید isReadable و isWriteable برای بررسی دقیقتر property ها.
پشتیبانی از doc comment مستقیم روی پارامترهای تابع.
یه enum جدید به اسم SortDirection برای اینکه دیگه مجبور نباشی رشتههای دستی مثل 'asc' و 'desc' پخش کنی.
بهبود امنیت مقادیر پیشفرض session، که برای خیلی از پروژههای قدیمی یه نقطهضعف رایج بوده.
قابلیت debug بهتر برای enum ها، که تا الان توی var_dump یا دیباگ کردن همیشه کمی گنگ بودن.
پشتیبانی از #[\Override] روی class constant ها، شبیه همون attribute ای که قبلاً فقط روی متدها قابل استفاده بود.
و یه سری deprecation، طبق روال همیشگی
مثل هر نسخهی PHP دیگهای، این نسخه هم یه سری قابلیت قدیمی رو deprecated میکنه. لیست کامل این deprecation ها هنوز داره کامل میشه، برای همین اگه پروژهی بزرگی داری، بهتره نزدیک انتشار نهایی یهبار changelog رو کامل مرور کنی، نه همین الان.
جمعبندی: ارزش صبر کردن رو داره؟
اگه بخوای یهخط جمعبندی کنی: PFA بزرگترین تغییر syntax این نسخهست و واقعاً نحوهی نوشتن callback و کد functional رو تمیزتر میکنه؛ Duration و Polling API بیشتر زیرساخت آیندهی PHP رو میسازن تا اینکه همین امروز مستقیم روی کدت اثر بذارن؛ و بقیهی موارد بیشتر quality-of-life هستن. با توجه به اینکه هنوز توی مرحلهی RC هستیم، منطقیترین کار اینه که همین حالا نسخهی بتا رو (مثلاً از طریق ایمیج داکر php:8.6-rc-cli یا کامپایل از سورس) روی یه پروژهی تست امتحان کنی، ولی برای production صبر کنی تا نوامبر که نسخهی نهایی و پایدار بیاد.
خروجی این فراخوانی، بهجای یه پاراگراف توضیحی، یه شیء ساختاریافته با احتمال کنار هر جوابه، چیزی شبیه این:
نکتهی مهم اینجا اینه که هر سه تا سؤال همزمان و موازی ارزیابی شدن، نه بهصورت سه فراخوانی جدا، و کد تو مستقیم میتونه روی is_urgent.value یا queue.value شرط بذاره — بدون parse کردن یه متن آزاد یا امیدوار بودن به اینکه مدل فرمت JSON رو درست رعایت کرده باشه. همین چیزیه که TypeSafe بهش میگه حذف مرحلهی «تولید متن غیرضروری».
چرا اینقدر سریع و ارزونه؟
TypeSafe میگه معماری Jev، همراه با یه sampler موازی جدید و یه روش آموزشی به اسم Reinforcement Learning for Calibrated Decisions، باعث شده این مدل بتونه چند تا سؤال تعریفشده رو همزمان ارزیابی کنه. ادعاهای این شرکت دربارهی سرعت و هزینه واقعاً چشمگیرن: طبق گزارشهای خودشون، Jev تا ۱۹۳.۶ برابر سریعتر و تا ۴۴۴.۶ برابر ارزونتر از LLM های معمول روی ارزیابیهای workflow عمل کرده. قیمتگذاریش هم غیرمعموله: ورودی به ازای هر میلیارد توکن (نه میلیون) حدود ۴۲ دلاره، در حالی که خروجی عملاً رایگانه — چون متن طولانیای تولید نمیشه که بابتش هزینه بگیرن. یه نکتهی مهم دیگه اینه که چون خروجیها از قبل محدود به یه فرمت مشخص هستن، طبق ادعای TypeSafe این مدل عملاً نمیتونه دچار hallucination بشه.
کجا استفاده میشه و اکوسیستمش چقدر جدیه؟
Jev قرار نیست جای ChatGPT رو بگیره؛ نمیتونه ایمیل بنویسه یا مکالمه کنه. جایی که معنا پیدا میکنه، داخل نقاط تصمیمگیری یه اپلیکیشنه: انتخاب ابزار یا subagent بعدی توی یه حلقهی agent، تصمیم بین ادامهدادن/تلاش دوباره/پرسیدن از کاربر/توقف، امتیازدهی به فوریت یا ریسک قبل از یه اقدام، و راستیآزمایی خروجی یه مدل دیگه برای guardrail. طبق مستندات، محدودیتش اینه که فقط ورودی متنی میپذیره و سقف context اون ۳۲ هزار توکنه — یعنی برای دیتای خیلی حجیم مناسب نیست.
اکوسیستم دورش هم سریع شکل گرفته: Jev همین الان از طریق AI Gateway ورسل و AI SDK (با متد آزمایشی evaluate)، پلتفرمهایی مثل orq.ai و LiteLLM (بهعنوان proxy)، و ابزار observability مثل Braintrust (برای ردیابی سؤالها، جوابها و توزیع احتمالات) در دسترسه. کتابخونههای رسمی پایتون و جاوااسکریپت وجود دارن، و حتی یه SDK غیررسمی راست هم توسط کامیونیتی نوشته شده. یه ریپازیتوری کامیونیتی هم به اسم awesome-jev-by-typesafe الگوها و نمونهکدهای مختلف استفاده از این مدل رو جمع کرده — نشونهی اینکه توسعهدهندهها خیلی سریع دارن دنبال جای مناسبش توی stack خودشون میگردن.
بررسی کامل: نقاط قوت و محدودیتها
نقطهقوت اصلی Jev اینه که یه دسته از مسائل رو که همیشه با یه LLM معمولی حل میکردیم — دستهبندی، routing، امتیازدهی — رو ارزونتر، سریعتر و قابلاعتمادتر (از نظر فرمت خروجی) میکنه؛ دیگه لازم نیست نگران parse کردن یه JSON ناقص یا یه توضیح اضافهی غیرمنتظره باشی. برگردوندن احتمال کنار هر جواب هم یه مزیت عملیه: میتونی موارد مطمئن رو خودکار پردازش کنی و فقط موارد مبهم رو برای بررسی انسانی نگه داری، الگویی که توی خیلی از نمونهکدهای منتشرشده هم دیده میشه.
از طرف دیگه، چند تا محدودیت هم داره که باید در نظرشون بگیری. اول، ورودی فقط متنیه، یعنی برای تصمیمگیری بر پایهی تصویر یا صدا اصلاً گزینه نیست. دوم، سقف context ۳۲ هزار توکنی یعنی برای state های خیلی بزرگ (مثلاً یه سند طولانی) باید اول خلاصهسازی یا فیلتر انجام بدی. سوم، و شاید مهمتر از همه، ارقام چشمگیر سرعت و هزینهای که TypeSafe منتشر کرده، بر پایهی benchmark و روش ارزیابی خودشونه؛ یه مقایسهی مستقل که یکی از کاربرها بین Jev و Gemini برای دستهبندی ایمیل انجام داده بود نشون داد Gemini کمی دقیقتر عمل کرده، هرچند ده تا بیست برابر گرونتر بوده. یعنی Jev دقیقاً یه trade-off بین دقت مطلق و سرعت/هزینهست، نه لزوماً برتری مطلق توی همهی سناریوها.
جمعبندی
استقبال از Jev اونقدر زیاد بوده که TypeSafe بهطور موقت نتونسته جوابگوی حجم درخواستهای API باشه، و پشتیبانی سریعش توسط پلتفرمهایی مثل ورسل و LiteLLM هم نشون میده صنعت این دسته از مدل («تصمیمگیرندهی سریع» بهجای «مولد متن») رو جدی گرفته. برای الان، Jev تقریباً تنها بازیگر شناختهشده توی این دستهست، ولی با توجه به استقبالی که گرفته، بعیده رقبا خیلی طول بکشه تا وارد همین میدون بشن. اگه یه بخشی از سیستمت داره برای تصمیمهای ساده و پرتکرار، پول یه LLM کامل رو میده، الان وقت خوبیه که Jev رو امتحان کنی.
عملکرد، از نگرانی به مزیت
بعد از انتقاداتی که دربارهی performance نسخهی هفت مطرح شد، تیم Prisma روی این مسئله متمرکز کار کرد و نتیجهش توی Prisma 8 دیده میشه: طبق بنچمارکهای خود تیم، Prisma 8 به حدود ۸۷ درصد throughput خام درایور pg رسیده و ۵۲ درصد request در ثانیه بیشتر از Prisma 7 داره. اگه از Prisma 7 به این دلیل ناامید شده بودی که کندتر از انتظارت بود، این عدد دلیل خوبیه که دوباره بهش نگاه کنی.
migration و ابزارها
فرآیند migration هم توی Prisma 8 بازطراحی شده: مفاهیمی مثل migration graph، ویرایش مستقیم یه migration، و rollback و recovery رسمیتر و شفافتر شدن. یه سیستم middleware داخلی هم اضافه شده که budget (محدودیت اجرای query)، lint، و cache رو بهصورت built-in پشتیبانی میکنه، بهجای اینکه هرکسی اینها رو با کتابخونههای جداگانه پیاده کنه. ایندکسهای expression، partial و unique هم حالا هم توی Prisma Schema Language و هم توی تایپاسکریپت قابل تعریف هستن، و Prisma 8 میتونه ایندکسها و سیاستهای row-level security یه دیتابیس موجود رو مستقیم بخونه.
خبر MongoDB هم بالاخره روشن شده: تیم Prisma رسماً اعلام کرده پشتیبانی از MongoDB از این به بعد فقط از طریق Prisma 8 میاد، نه Prisma 7 — یعنی اگه منتظر MongoDB روی نسخهی هفت بودی، دیگه نباید منتظرش بمونی.
میتونی نسخهی هفت و هشت رو کنار هم اجرا کنی
یکی از تصمیمهای هوشمندانهی تیم Prisma این بوده که مسیر مهاجرت رو تدریجی طراحی کنن: میتونی Prisma 7 و Prisma 8 رو توی یه پروژهی واحد، کنار هم و ماژولبهماژول اجرا کنی. مثلاً بخشی از route هات از کلاینت Prisma 7 استفاده کنن و بخش دیگه از Prisma 8، در حالی که هر دو روی یه schema دیتابیس مشترک کار میکنن؛ فقط باید مشخص کنی کدوم نسخه مالک migration هاست. این یعنی مجبور نیستی یهشبه کل پروژه رو آپدیت کنی.
نکتهی مهم برای کسی که همین الان میخواد شروع کنه
با اینکه prisma@latest الان به Prisma 8 اشاره میکنه و Prisma Compute هم به مرحلهی production با قیمتگذاری رسمی رسیده، بخشی از تغییرات هنوز داره توی همون بازهی release candidate جا میفته و ممکنه بین نسخهها breaking change ببینی — مثلاً تغییر اسم فایل کانفیگ، یکپارچه شدن دستورهای CLI، یا تغییر نام متدهای pagination. اگه پروژهات production حساسه، منطقیتر اینه که فعلاً روی Prisma 7 بمونی؛ تیم Prisma هم رسماً قول داده که Prisma 7 حداقل تا یک سال دیگه support کامل داشته باشه. اگه پروژهی جدید شروع میکنی یا حاضری با یه سری تغییرات جزئی بین نسخهها کنار بیای، Prisma 8 الان یه انتخاب معقول و رو به جلوئه، مخصوصاً اگه معماری contract-based و بهبود performance براتون مهمه.
جمعبندی کوتاه: Prisma 7 یه تغییر معماری بزرگ بود (حذف Rust)، Prisma 8 یه بازنویسی کاملتره که مدل داده رو از «کلاینت تولیدشده» به «contract قابل بازرسی» تبدیل میکنه، performance رو بهطور محسوس بهتر کرده، و راه رو برای MongoDB و قابلیتهای جدیدتر باز کرده. انتخاب بین این دو، بیشتر به این برمیگرده که چقدر برای تغییرات هنوز در حال تثبیت شدن، آمادهای.
اینجا UsersController مسئول گرفتن request هست، و منطق واقعی رفته توی UsersService. نکتهی مهم اینه که کنترلر اصلاً نمیدونه UsersService چطور ساخته میشه — فقط توی constructor خواستتش، و خود NestJS با سیستم DI اون رو براش میسازه و تزریق میکنه. این جدایی وقتی پروژه بزرگ میشه، فرق بین یه کدبیس قابل نگهداری و یه فایل ۲۰۰۰ خطی که همه ازش میترسن رو میسازه.
چرا بهجای API route های Next.js؟
API route های Next.js برای یه سری کار خیلی خوب هستن: یه webhook ساده، یه پراکسی کوچیک به یه سرویس دیگه، یا چند تا endpoint که مستقیم به دیتای همون صفحه مربوط میشن. مشکل از جایی شروع میشه که بخوای این API route ها رو به یه backend واقعی تبدیل کنی.
اول از همه، API route ها ساختار معماری ندارن. هیچ الگوی رسمیای برای جدا کردن business logic از لایهی HTTP وجود نداره؛ هر تیمی به روش خودش فایلها رو میچینه، و این یعنی هر پروژهی Next.js با بکاند بزرگ، یه معماری دستساز و غیر استاندارد داره که فقط خود همون تیم باهاش راحته.
دوم، هیچ dependency injection ای وجود نداره. اگه بخوای یه سرویس دیتابیس رو mock کنی برای تست، یا بخوای پیکربندی مختلف برای محیطهای مختلف (dev/staging/production) داشته باشی، باید خودت از صفر این infrastructure رو بسازی — چیزی که توی NestJS از روز اول رایگان همراهته.
سوم، قابلیتهای آمادهای مثل guard (برای authorization)، pipe (برای validation و transform کردن ورودی)، interceptor (برای لاگگیری یا caching)، و پشتیبانی built-in از microservices، WebSocket، GraphQL و message queue هایی مثل RabbitMQ و Kafka، همه بخشی از خود فریمورک هستن. توی Next.js API route ها، همهی اینها رو باید دستی یا با کتابخونههای جداگانه پیاده کنی و خودت به هم وصلشون کنی.
و در آخر، مسئلهی جدایی نگرانیهاست (separation of concerns). وقتی frontend و backend توی یه codebase و یه پروسهی deploy قاطی میشن، اسکیل کردنشون هم مستقل از هم غیرممکن میشه. اگه backendت نیاز به منابع محاسباتی بیشتری داره ولی frontendت نه، توی Next.js نمیتونی این دو تا رو جدا اسکیل کنی؛ ولی وقتی backend یه سرویس مجزای NestJS باشه، این کار پیشفرضه.
این به این معنی نیست که Next.js API route ها همیشه اشتباهن. برای پروژههای کوچیک، یا وقتی backend واقعاً فقط چند تا وظیفهی ساده داره، اضافه کردن یه فریمورک جدا مثل NestJS ممکنه بیش از حد باشه. سؤال واقعی اینه: آیا backendت قراره رشد کنه و پیچیده بشه، یا همیشه همینقدر کوچیک میمونه؟
مقایسه با بقیهی فریمورکها
Express پایه و اساس خیلی از فریمورکهای Node.js از جمله خود NestJS هست. مزیتش انعطافپذیری مطلقشه — هیچ ساختاری بهت تحمیل نمیکنه. اما همین انعطاف، مشکل هم هست: توی یه تیم بزرگ، هر توسعهدهنده ممکنه یه روش متفاوت برای سازماندهی کد انتخاب کنه، و بعد از یه مدت کدبیس به یه مجموعهی ناهماهنگ از الگوهای مختلف تبدیل میشه. NestJS اساساً یه لایهی معماری روی همین Express (یا Fastify) میذاره تا این مشکل حل بشه.
Fastify به تنهایی روی سرعت و performance تمرکز داره و از Express سریعتره، ولی از نظر فلسفه شبیه Expressه: یه فریمورک minimal، نه یه معماری کامل. جالبه که NestJS میتونه از Fastify هم بهعنوان HTTP adapter استفاده کنه، یعنی میتونی هم ساختار NestJS رو داشته باشی هم سرعت Fastify رو.
Next.js API routes، همونطور که گفتیم، برای کارهای سبک عالیه ولی برای یه backend کامل و مستقل طراحی نشده؛ اساساً بخشی از یه فریمورک فرانتاند هست، نه یه فریمورک backend.
اگه بخوای NestJS رو با دنیای بیرون از Node.js مقایسه کنی، شباهت مفهومیش به Spring Boot توی جاوا یا Laravel توی PHP بیشتره تا به Express — همهی اینها فریمورکهای opinionated و کامل هستن که یه معماری استاندارد و ابزارهای آماده برای dependency injection، validation، و routing ارائه میدن. اگه از پیشینهی جاوا یا PHP وارد دنیای Node شده باشی، NestJS احتمالاً برات خیلی آشنا به نظر میاد.
چه زمانی سراغ NestJS نریم؟
اگه پروژهت واقعاً کوچیکه، یا داری یه prototype سریع میسازی، یا تیمت با معماریهای سنگین راحت نیست، NestJS ممکنه سربار غیرضروری اضافه کنه. یادگیریش هم نسبت به یه Express ساده زمان بیشتری میبره، چون باید با مفاهیمی مثل ماژول، decorator، و DI آشنا بشی. برای یه API با پنج تا endpoint که قرار نیست رشد کنه، یه Express ساده یا همون API route های Next.js احتمالاً کافیه.
جمعبندی
انتخاب بین NestJS و API route های Next.js در نهایت به اندازه و آیندهی پروژهت برمیگرده. اگه داری یه backend میسازی که قراره چند تا سرویس، چند تا تیم، و منطق پیچیدهی business رو در خودش جا بده، NestJS یه پایهی معماری محکم بهت میده که از اول جلوی خیلی از مشکلات ساختاری رو میگیره. اگه فقط چند تا endpoint کنار یه اپلیکیشن فرانتاند نیاز داری، همون API route های Next.js بدون هیچ overhead ای کارتو راه میندازه. مشکل از جایی شروع میشه که یه پروژهی «فقط چند تا endpoint» رو با فرض «همیشه همینقدر کوچیک میمونه» شروع کنی و بعد از یه سال متوجه بشی داری یه backend کامل رو توی یه پوشهی api مدیریت میکنی.
top
UTF-8 بهصورت پیشفرض همهجا
از این نسخه به بعد، وقتی encoding رو صریح مشخص نکنی (مثلاً توی open())، پایتون بهجای وابسته بودن به تنظیمات سیستمعامل، از UTF-8 استفاده میکنه. این یعنی رفتار یکسان روی ویندوز، مک و لینوکس، ولی اگه پروژهای داری که به رفتار قدیمی وابسته بوده، بهتره از PYTHONUTF8=0 برای برگردوندن رفتار قبلی استفاده کنی یا صریحاً encoding رو همیشه مشخص کنی.
لیست کامل تغییرات
این یه فهرست کامل و تفکیکشده از هر چیزیه که توی «What's New in Python 3.15» رسمی پایتون اومده؛ دقیقاً به همون دستهبندی خود مستندات.
ویژگیهای جدید زبان
PEP 810 – واردات تنبل (lazy imports): کلیدواژهی نرم lazy برای import و from ... import؛ لود شدن ماژول تا اولین استفاده به تعویق میفته. فلگ -X lazy_imports، متغیر محیطی PYTHON_LAZY_IMPORTS، توابع sys.set_lazy_imports()/get_lazy_imports()/set_lazy_imports_filter() و متغیر ماژولی __lazy_modules__ هم اضافه شدن. فقط توی scope ماژول مجازه، نه داخل تابع یا کلاس.
PEP 814 – نوع built-in جدید frozendict: دیکشنری immutable که زیرکلاس dict نیست، اگه کلید/مقدارهاش hashable باشن خودش هم hashable میشه. ماژولهای copy، decimal، json، marshal، plistlib، pickle، pprint و xml.etree.ElementTree ازش پشتیبانی میکنن؛ eval()/exec() هم برای globals قبولش میکنن.
PEP 661 – نوع built-in جدید sentinel: برای ساختن مقادیر یکتا با representation خوانا؛ identity رو موقع کپی حفظ میکنه، با عملگر | توی type expression کار میکنه و قابل pickle شدنه.
PEP 799 – ماژول جدید profiling: شامل profiling.tracing (جایگزین cProfile، که بهعنوان alias میمونه) و profiling.sampling. ماژول قدیمی profile هم منسوخ شده و توی 3.17 حذف میشه.
پروفایلر Tachyon (profiling.sampling): یه sampling profiler آماری با overhead تقریباً صفر، سرعت نمونهبرداری تا یک میلیون هرتز، حالتهای attach/run/dump، چهار مود اندازهگیری (wall/cpu/gil/exception)، خروجیهای pstats/collapsed/flamegraph/gecko/heatmap، حالت زندهی تعاملی (--live) و پروفایل async-aware و سطح opcode.
PEP 831 – فعال بودن پیشفرض frame pointer: کامپایل CPython با فلگهای -fno-omit-frame-pointer و -mno-omit-leaf-frame-pointer، برای stack unwinding سریعتر و قابلاعتمادتر توسط پروفایلرها، دیباگرها و ابزارهای eBPF. از طریق sysconfig هم به extensionها منتقل میشه.
PEP 798 – Unpacking در comprehensionها:* و ** حالا توی list/set/dict comprehension و generator expression هم کار میکنن ([*L for L in lists] و مشابه).
PEP 829 – فایلهای پیکربندی استارتاپ پکیج (.start files): جایگزین امنتر برای خطوط import توی فایلهای .pth که کد دلخواه اجرا میکردن؛ فرمت جدید pkg.mod:callable. کلاس site.StartupState هم برای batch کردن پردازش استارتاپ اضافه شده.
PEP 803/820/793 – Stable ABI برای buildهای free-threaded (abi3t): امکان کامپایل extensionهای Stable ABI برای سازگاری با buildهای free-threaded، با API جدید PyModExport_* و ساختار PySlot.
PEP 788 – محافظت C API در برابر finalization: APIهای جدید «interpreter guard» و «interpreter view» و مکانیزمهای attach/detach خودکار thread state؛ خانوادهی PyGILState هم soft-deprecated شده (بدون برنامهی حذف).
پیامهای خطای بهتر: پیشنهاد مسیر جایگزین توی AttributeError وقتی attribute از طریق یه attribute داخلی در دسترسه؛ تشخیص متدهای زبانهای دیگه (مثل .push() جاوااسکریپتی) و پیشنهاد معادل پایتونی؛ پیشنهاد در delattr() هم اضافه شده.
تغییرات دیگر زبان
PEP 686 – UTF-8 بهعنوان انکودینگ پیشفرض: عملیات I/O بدون encoding صریح، مستقل از سیستمعامل، از UTF-8 استفاده میکنن. با PYTHONUTF8=0 یا -X utf8=0 میشه رفتار قبلی رو برگردوند.
سیستم import حالا قفلهای per-module رو به ترتیب سلسلهمراتبی میگیره؛ یه deadlock قدیمی رفع شده.
نام فایل extensionهای Stable ABI میتونه شامل multiarch tuple باشه (مثل foo.abi3-x86-64-linux-gnu.so).
attribute منسوخشدهی __cached__ روی ماژولها دیگه در نظر گرفته نمیشه؛ بهجاش از __spec__.cached استفاده کن.
پوستهی تعاملی پیشفرض (REPL)
تکمیل خودکار تب (tab completion) حالا بر اساس نوع شیء رنگی میشه (بر پایهی fancycompleter)؛ با PYTHON_BASIC_COMPLETER میشه به rlcompleter قدیمی برگشت.
ماژولهای جدید
math.integer: توابع ریاضی مخصوص آرگومانهای صحیح (PEP 791).
بهبود ماژولها
argparse:BooleanOptionalAction از گزینههای تکخطتیره و پیشوندهای جایگزین پشتیبانی میکنه؛ suggest_on_error پیشفرضش True شده؛ پشتیبانی از backtick برای هایلایت کد توی description/epilog و متن help.
array: پشتیبانی از float complex/double complex (کدهای Zf/Zd) و half-float (کد e)؛ نوع array.typecodes از str به tuple تغییر کرده.
ast: پارامتر color به dump() اضافه شده؛ خروجی CLI بهصورت پیشفرض syntax-highlighted شده.
asyncio: متد TaskGroup.cancel برای پایان زودهنگام یه گروه تسک اضافه شده.
base64: پارامتر pad در z85encode()؛ پارامتر padded در توابع b32/b64؛ پارامتر wrapcol؛ پارامتر ignorechars؛ پارامتر canonical برای رد کردن انکودینگهای غیراستاندارد.
binascii: توابع جدید Base32 (b2a_base32/a2b_base32) و Ascii85/Base85/Z85؛ پارامترهای padded، wrapcol، alphabet، ignorechars، canonical.
calendar: رنگ بیشتر توی CLI؛ خروجی HTML گزینهی year-month قبول میکنه؛ صفحات HTMLCalendar به HTML5 مهاجرت کردن و از دارکمود پشتیبانی میکنن.
collections: متدهای Counter.__xor__()/__ixor__() برای تفاضل متقارن.
concurrent.futures: گزارش خطای بهتر وقتی یه پروسهی فرزند توی ProcessPoolExecutor ناگهانی میمیره (PID و exit code رو نشون میده).
contextlib: پشتیبانی از descriptor دلخواه برای __enter__/__exit__/__aenter__/__aexit__ در ExitStack/AsyncExitStack؛ ContextDecorator/AsyncContextDecorator حالا generator/coroutine/async-generator رو تشخیص میدن و context manager رو باز نگه میدارن.
ctypes: تغییر _type_ برای انواع complex از F/D/G به Zf/Zd/Zg (سازگاری با NumPy).
mimalloc allocator پیشفرض برای تخصیص حافظهی خام شده (بهبود پرفورمنس روی buildهای free-threaded).
پیادهسازی base64 حالا ۲ برابر سریعتر انکود و ۳ برابر سریعتر دیکود میکنه.
پیادهسازی Ascii85/Base85/Z85 با C بازنویسی شده: دو مرتبه بزرگی سریعتر و کمحافظهتر.
پیادهسازی Base32 هم با C بازنویسی شده و دو مرتبه بزرگی سریعتره.
تشخیص delimiter در csv.Sniffer.sniff() تا ۱.۶ برابر سریعتر شده.
JIT کامپایلر آپدیت مهمی خورده؛ طبق pyperformance حدود ۸ تا ۹ درصد بهبود کلی سرعت.
حذفشده، منسوخشده و تغییرات C API/Build
مستندات رسمی بخشهای جداگانهای هم برای «Removed»، «Deprecated»، «C API changes» و «Build changes» داره که جزئیاتش بیشتر برای نگهدارندههای افزونهها و پکیجهای C اهمیت داره تا کاربر معمولی پایتون؛ اگه پکیجی با extension بومی نگه میداری، حتماً قبل از آپگرید این بخشها رو توی مستندات رسمی خودشون چک کن.
جمعبندی
3.15.0rc1 دقیقاً همونیه که اسمش میگه؛ یه پیشنمایش تقریباً نهایی، نه یه نسخهی آزمایشی نصفهنیمه. اگه پکیجی نگه میداری که خیلیا ازش استفاده میکنن، الان بهترین زمانه که wheel های سازگار با 3.15 رو منتشر کنی و تست کنی. برای پروژهی production خودت هم بهتره صبر کنی تا نسخهی نهایی اکتبر بیاد؛ ولی چیزهایی مثل lazy imports و frozendict به اندازهی کافی جذاب هستن که ارزش یه تست زودهنگام رو داشته باشن.
این نسخه هنوز LTS نیست
نود ۲۶ فعلاً روی خط Current قرار داره و طبق برنامهی رسمی، قراره اکتبر وارد LTS بشه. یعنی ۲۶.۸.۰ بیشتر برای کسانی مناسبه که میخوان زودتر فیچرهای جدید رو امتحان کنن؛ اگه پروژهی production داری و ثبات برات مهمتر از تازگیه، همون ۲۴.۲۰.۰ Krypton که همزمان روی LTS منتشر شده گزینهی مطمئنتریه.
در کل، ۲۶.۸.۰ از اون آپدیتهای ساکت ولی مفیده؛ هیچکدوم از تغییرات به تنهایی breaking نیستن، ولی مجموعشون زندگی رو برای کارهایی مثل ساخت zip، رمزنگاری امنتر و مدیریت statementهای sqlite کمی راحتتر میکنه.
هویت مدل: بازی حدسزدن که بالاخره تموم شد
بازی حدس زدن راجع به اینکه پشت Ox Alpha کیه، بالاخره تموم شد. گوگل، شیائومی، دیپسیک و MAI مایکروسافت همه یهجایی توی این حدسزدنها مطرح شدن، ولی امروز خود Z.ai (همون Zhipu) رسماً تأیید کرد که Ox Alpha چیزی نیست جز GLM-5.3-Flash؛ اولین مدل native چندوجهی از خانوادهی GLM-5. تا قبل از تأیید رسمی، توسعهدهندهها با مقایسهی توکنایزر و انکودر ویدیو به همین نتیجه رسیده بودن، ولی حالا دیگه حدس نیست. طبق گفتهی خود Z.ai، این مدل ۳۲۰ میلیارد پارامتر کل داره ولی فقط ۱۸ میلیارد پارامترش روی هر توکن فعال میشه (یعنی معماری MoE)، تحت لایسنس MIT منتشر شده، و قراره حدود ۰.۱۵ دلار برای هر میلیون توکن ورودی قیمت بخوره؛ یعنی چیزی حدود یکدهم قیمت مدلهای همردهاش. همون شبی که خبر تأیید منتشر شد، وزنهای مدل هم عمومی شدن.
بنچمارکهای رسمی چی میگن؟
راجع به عملکرد هم عددها یکدست نیستن. یه تست دهتایی از بنچمارک DeepSWE نشون داد Ox Alpha با ۸۰ درصد، از Claude Fable 5 با ۶۵ درصد و از GPT-5.6 Sol با ۵۲ درصد جلوتره؛ ولی وقتی همین بنچمارک رو با ۱۱۳ تسک کامل اجرا کردن، عدد Ox Alpha به حدود ۶۳ درصد رسید که تقریباً همسطح GPT-5.6 Sol شد، نه اون فاصلهی چشمگیر اول. توی Kingbench هم با ۸۷.۵ درصد، پشت سر GLM-5.3 با ۹۱.۲۵ درصد قرار گرفت ولی جلوتر از Opus 4.8 که ۸۰ درصد گرفته. یه بنچمارک خصوصی دیگه هم هست که نتیجهی کاملاً متفاوتی داده و این مدل رو در حد مدلهای دو نسل قبل، مثل Kimi 2.6، ردهبندی کرده. یعنی بستگی داره چه نوع تسکی بهش بدی؛ ظاهراً روی کارهای فرانتاند و طراحی UI بهطور خاص قویتر عمل میکنه تا روی منطق خالص کد.
به هیچ عنوان نمیتونم به این بنچمارکها اعتماد کنم، چون واقعاً چیزی که من دیدم با هایپی که توی اینترنت هست روی این مدل متفاوته. شاید من اشتباه استفاده میکنم ازش.
تجربهی کاربرها
همین ناهماهنگی رو توی تجربهی کاربرها هم میبینی. بعضیها گفتن روی opencode مدام تایماوت میگیره و عملاً غیرقابل استفاده میشه، ولی همون مدل روی Hermes Agent بدون مشکل کار کرده. بعضی هم از اجراهای چند ساعته برای یه مقایسهی ساده گلایه کردن؛ که با همون کندیای که خودم حس کردم همخونی داره. از چندین نفر پرسیدم و مثل اینکه اونها هم عملاً نمیتونستن استفاده کنن ازش. من استفاده کردم، ولی چیز Wowای برای من بهشخصه نبود.
ضعفهای مدل (تجربهی خودم)
یه نکتهی دیگه که موقع کار باهاش برام مهم بود: توی نوشتن محتوای فارسی اصلاً خوب عمل نمیکنه. اگه دنبال یه مدل برای تولید متن فارسی روون میگردی، فعلاً این گزینهی خوبی نیست.
این مدل به شدت کند عمل میکنه، در حدی که قبل از این، کندترین مدلی که دیده بودم Nemotron از Nvidia بود که با اومدن این مدل جاشو گرفت برای من (نموترون رو از چند پروایدر تست کردم و همهشون همونقدر کند بودن).
من نمیدونم این جریانِ اینکه این مدل روی تسکهای UI بهشدت خوب عمل میکنه از کجا میاد؛ حقیقتاً فکر نمیکنم چیز خاصی باشه، چون شخصاً بررسیش کردم.
یه چیز جالب دیگه هم توی تستهام دیدم: وقتی به چتجیپیتی و کلاد یه دستور میدی که یک کاری رو انجام بده و بعد در حالی که روی یه پروژهی دیگهای دوباره بهش میگی همون کار قبلی رو روی این پروژه انجام بده، هر دو متوجه میشن که کانتکست فرق داره و مال یک پروژهی دیگهست و میپرسن منظورت همین پروژهی فعلیه یا اون یکی قبلی که تأیید کنی؛ ولی Ox Alpha بدون هیچ سؤالی مستقیم میره سراغ پروژهی قبلی، تا وقتی که خودم absolute path رو بهش بدم. اینجور جاهاست که فرق بین «قوی بودن توی بنچمارک» و «فهمیدن context واقعی کار تو» خودش رو نشون میده.
به نظرم بنچمارکها زیادم حقیقت رو، حداقل در استفادهی واقعی از مدلها، نمیگن.
دیگه استدلال به تنهایی ملاک نیست
یه چیزی هم که این روزها بیشتر و بیشتر حس میکنم اینه که دیگه صرفاً «قدرت استدلال» ملاک اصلی انتخاب نیست. فاصلهی بین مدلهای بالای بازار داره کم میشه و کمکم همهشون توی این بخش خوب یا خیلی خوب هستن؛ چیزی که واقعاً فرق ایجاد میکنه بیشتر سرعت، قیمت، و همون درک درست از context کاره تا صرفاً یه عدد بالاتر توی بنچمارک استدلال.
نظر خودم راجع به استفاده از GLM-5.3-Flash
رک بگم: نه. در صورتی که مدل رایگان نباشه (با این سرعت) یا اینکه مثلاً پولی بشه ولی بسیار ارزون باشه (در حد همون Spark 1.2 یا حالا یکم بالاتر) یا شاید در سطح DeepSeek Flash، من بهشخصه از این مدل، با اینکه واقعاً قدرت بالایی داره، استفاده نمیکنم؛ به چند دلیل:
استدلال رو میسپارم به مدلی که بهش اعتماد دارم، مثل Claude یا GPT، دلیلش هم اینه که برای من ثابت شدهن.
اون حجم از استدلالی که مدلهای سریعتر یا حتی رایگان نمیتونن انجام بدن رو معمولاً خودم راجبش فکر میکنم و با چندین AI مشورت میکنم، نه اینکه فقط به یک مدل بسپارمش.
جمعبندی
حالا که هویتش مشخص شده و وزنهاش هم منتشر شدن، دیگه اون بهانهی «نمیدونیم دیتامون کجا میره» با همون شدت قبل معنا نداره، ولی همچنان بهتره قبل از استفادهی جدی، مستندات رسمی Z.ai راجع به نگهداری دیتا رو خودت بخونی. تجربهی خودت با این مدل چی بوده؟ همون چیزی که بنچمارکهای رسمی میگن رو حس کردی یا مثل من فکر میکنی هنوز رقابت خاصی بین این و مدلهای OpenAI و Anthropic، حداقل در ردههای بالا، نیست؟
یکی از جذابترین بخشهای Wasp، مدل ارتباطی client-server شه. بهجای اینکه خودت endpoint بسازی و بعد جدا یه fetch call بنویسی، فقط یه تابع سرور رو تعریف میکنی و Wasp خودش یه hook تایپشده تو کلاینت تولید میکنه:
// سمت کلاینت: استفاده مستقیم، بدون نوشتن fetch یا API route
import { useQuery, getTasks } from 'wasp/client/operations';

function TaskList() {
  const { data: tasks, isLoading } = useQuery(getTasks);
  if (isLoading) return <div>در حال بارگذاری...</div>;
  return <ul>{tasks.map(t => <li key={t.id}>{t.description}</li>)}</ul>;
}
نکتهی مهم اینجاست که تایپهای TypeScript بین سرور و کلاینت بهصورت خودکار sync میشن؛ اگه ساختار دادهای که از سرور برمیگرده عوض بشه، همون لحظه تو کلاینت هم خطای type-check میگیری، بدون اینکه خودت مجبور باشی این هماهنگی رو دستی نگه داری.
قابلیتهای آماده که معمولاً باید خودت بسازی
Wasp خودش رو «batteries-included» معرفی میکنه، و این ادعا با فهرست قابلیتهاش پشتیبانی میشه:
Auth کامل: ایمیل/پسورد، گوگل، گیتهاب، اسلک، مایکروسافت، همه با پیکربندی چند خطی.
Background jobs: برای کارهایی که نباید request رو بلاک کنن.
ارسال ایمیل: بدون نیاز به تنظیم دستی SMTP یا SDK جدا.
Type-safety کامل full-stack: از دیتابیس تا کامپوننت React.
Deploy با یه دستور:wasp deploy میتونه اپ رو مستقیم رو زیرساختهای پشتیبانیشده بالا بیاره.
نکتهی مهم: بدون lock-in
برخلاف پلتفرمهایی مثل Firebase یا Supabase که کدت به سرویس اونا وابسته میشه، Wasp ادعا میکنه هیچ lock-in ای نداره. خروجی کامپایل، کد خام React و Node.js و Prisma است که میتونی مستقیم تو پوشهی .wasp/ ببینیش. یعنی اگه یه روز تصمیم گرفتی از Wasp CLI فاصله بگیری، کد تولیدشده رو برمیداری و مستقل ازش ادامه میدی؛ بدون runtime اختصاصی یا لایهی مخفی سمت سرور.
چرا این روزها خودش رو «فریمورک عصر AI» معرفی میکنه
نکتهی جالب اینه که Wasp این روزها تمرکز بازاریابیش رو گذاشته رو اینکه برای کدنویسی با agent های هوش مصنوعی بهینهست. استدلالشون اینه: چون Wasp یه توصیف سطحبالا و declarative از کل اپلیکیشن داره (نه هزاران فایل پراکندهی boilerplate)، یه agent کدنویس میتونه ساختار کامل اپ رو خیلی سریعتر «بفهمه» و تغییرات درستی اعمال کنه. خود پروژه یه سری plugin و skill هم برای ابزارهایی مثل Claude Code منتشر کرده که مستقیم دانش Wasp رو به agent اضافه میکنه.
جالبه که این رویکرد هیچ ارتباطی به یه provider خاص هوش مصنوعی نداره؛ Wasp خودش هیچ AI داخلی نداره و اگه بخوای یه ویژگی AI به اپت اضافه کنی (مثلاً چتبات)، باید مدل دلخواهت (OpenAI، آنتروپیک، یا یه مدل local) رو مثل یه dependency معمولی Node.js وصل کنی؛ چیزی که خودشون توش دخالتی ندارن.
کجا این فریمورک جای خودش رو پیدا میکنه
Wasp دقیقاً یه خلأ خاص رو پر میکنه: جایی بین انعطاف کامل ولی کاردستی Next.js یا Remix (که همهچیز رو خودت وایر میکنی)، و انتزاع بالا ولی وابستهبه-سرویس Firebase یا Supabase (که برای هر چیزی به یه پلتفرم شخص ثالث وابستهای). اگه دنبال یه تجربهی شبیه Rails یا Laravel هستی، ولی میخوای تو دنیای TypeScript و React بمونی، Wasp دقیقاً همین رو ارائه میده.
معایب و محدودیتها
طبیعتاً این سطح از انتزاع هزینه هم داره. اکوسیستم Wasp نسبت به Next.js یا حتی Nuxt خیلی کوچیکتره؛ تعداد پروژههای واقعی، منابع آموزشی، و توسعهدهندههای آشنا محدودتره. یادگیری DSL اختصاصیش هم یه گام اضافهست، هرچند سینتکسش نسبتاً سادهست. و چون فریمورک هنوز رسماً تو مرحلهی beta است (با اینکه برای ساخت بیش از ۵۰ هزار پروژه استفاده شده)، برای پروژههای خیلی بزرگمقیاس یا سازمانی، ممکنه بلوغ لازم رو نداشته باشه. علاوه بر این، طبیعت «opinionated» فریمورک یعنی برای اپلیکیشنهایی که ساختارشون خیلی از الگوی معمول CRUD/auth/jobs فاصله داره، ممکنه بیشتر از اینکه کمک کنه، محدودت کنه.
جمعبندی
اگه داری یه SaaS یا اپلیکیشن full-stack نسبتاً استاندارد میسازی (auth، دیتابیس، چند تا صفحه، شاید یه سری background job) و میخوای سریعتر از صفر شروع کنی، بدون اینکه هفتهها وقت صرف wiring کردن قطعات مختلف کنی، Wasp ارزش امتحان کردن داره؛ مخصوصاً که رایگان، متنباز، و بدون lock-in است. اگه پروژهت نیاز به کنترل خیلی دقیق روی هر جزئیات معماری داره، یا از قبل تیمی داری که با Next.js یا Nuxt راحته، احتمالاً همون مسیر آشناتر منطقیتره.
وقتی یه کاربر دیگه یه task جدید اضافه کنه، Collection سمت کلاینت بهصورت خودکار آپدیت میشه و کامپوننت React (به لطف useTracker) دوباره رندر میشه؛ همهی اینها بدون اینکه خودت مستقیم WebSocket handler بنویسی یا polling بزنی. این دقیقاً چیزیه که Meteor رو برای اپلیکیشنهای real-time (چت، داشبورد زنده، ابزارهای همکاری تیمی) جذاب میکنه.
MongoDB بهعنوان دیتابیس پیشفرض
Meteor از اول با MongoDB طراحی شده و این وابستگی عمیقه؛ نه یه انتخاب سطحی. سیستم reactivity، سینک شدن Collection ها بین سرور و کلاینت، و حتی امکان اجرای query های MongoDB مستقیم تو کلاینت (با یه minimongo که تو حافظهی مرورگر اجرا میشه)، همه بر پایهی مدل دادهی MongoDB ساخته شدن. اگه پروژهت نیاز به یه دیتابیس رابطهای مثل PostgreSQL داره، میشه با یهکم کار اضافه بهش وصلش کرد، ولی دیگه از خیلی از مزیتهای خودکار Meteor بیبهره میمونی.
مزیتها
سرعت توسعهی اولیه: برای پروتوتایپ کردن سریع یه اپ real-time، کمتر فریمورکی میتونه به سرعت Meteor برسه؛ چون خیلی از کارهایی که معمولاً باید دستی پیادهسازی کنی (WebSocket، sync داده، hot code push) از قبل آمادهست.
Hot code push: Meteor میتونه آپدیتهای جدید رو به کلاینتهای متصل، بدون نیاز به رفرش کامل صفحه، پوش کنه.
بستهبندی کامل: بیلد، bundling، و حتی deploy (با Galaxy، سرویس هاستینگ خود Meteor، یا Docker) همه از قبل تو اکوسیستم فریمورک هماهنگ شدن.
معایب و محدودیتها
وابستگی سنگین به MongoDB: اگه تیمت یا پروژهت به یه دیتابیس رابطهای نیاز داره، Meteor دیگه اون تجربهی یکپارچه رو نمیده.
اکوسیستم کوچیکتر و کمرونقتر: Meteor دیگه اون momentum اوایل دههی ۲۰۱۰ رو نداره. تعداد کتابخونهها، تعداد سؤالهای Stack Overflow، و تعداد پروژههای جدیدی که باهاش شروع میشن بهطور محسوسی از React یا Vue خام (چه برسه به Next.js یا Nuxt) کمتره.
سایز باندل کلاینت: بهخاطر minimongo و DDP client که باید رو مرورگر لود بشن، سایز باندل اولیهی Meteor معمولاً بزرگتر از یه اپ سادهی React یا Vue است.
منحنی یادگیری غیرمستقیم: مفاهیمی مثل Collection، publication/subscription، و method call (روش استاندارد Meteor برای mutation) یه مدل ذهنی جدا از چیزیه که تو REST یا GraphQL معمول یاد میگیری؛ یعنی دانشش کمتر قابلانتقاله به پروژههای دیگه.
کجا هنوز منطقیه
اگه داری یه اپ کاملاً real-time میسازی (مثل یه ابزار همکاری زنده، یه چت، یا یه داشبورد که باید فوری آپدیت بشه)، و مشکلی با MongoDB بهعنوان دیتابیس اصلی نداری، Meteor هنوز میتونه سرعت توسعهی بالایی بهت بده؛ خصوصاً برای تیمهای کوچیک یا MVP هایی که سرعت رسیدن به بازار مهمتر از انعطاف بلندمدت معماریه.
برای پروژههای عمومیتر که نیاز به real-time فوری ندارن، یا تیمت ترجیح میده از یه استک رابطهای و ابزارهای مدرنتر مثل Next.js یا Nuxt استفاده کنه، احتمالاً امروز گزینههای بهتری نسبت به Meteor پیدا میکنی؛ نه به این خاطر که Meteor بد شده، بلکه چون بقیهی اکوسیستم جاوااسکریپت از اون موقع بهطور قابلتوجهی رشد کرده و خیلی از ایدههای خوب Meteor (مثل full-stack بودن) رو به روشهای مدرنتری پیاده کردن.
ذکر نشده
لایسنس
MIT
MIT
زبان پیادهسازی
TypeScript / Next.js
JavaScript
نکتهی مهم دربارهی این جدول: بخش زیادیش (مخصوصاً اعداد OmniRoute) از صفحهی مقایسهی رسمی خود سایت OmniRoute اومده، که طبیعتاً به نفع خودشه. برای همین اعداد 9Router رو از منابع مستقل (Medium، AIMojo، EveryDev.ai، NGJOO) کراسچک کردم تا تصویر متوازنتری داشته باشیم، ولی بازم توصیه میشه قبل از تصمیم نهایی، خودت این دو تا رو مستقیم امتحان کنی.
کجا هرکدوم برندهست
9Router برای سادگی و تمرکز: اگه فقط میخوای مشکل rate limit حل بشه و یه ابزار سبک، ساده، و بدون قابلیتهای اضافهی پیچیده میخوای، 9Router دقیقاً همین رو ارائه میده. سطح پیچیدگیش کمتره و برای شروع سریع مناسبتره.
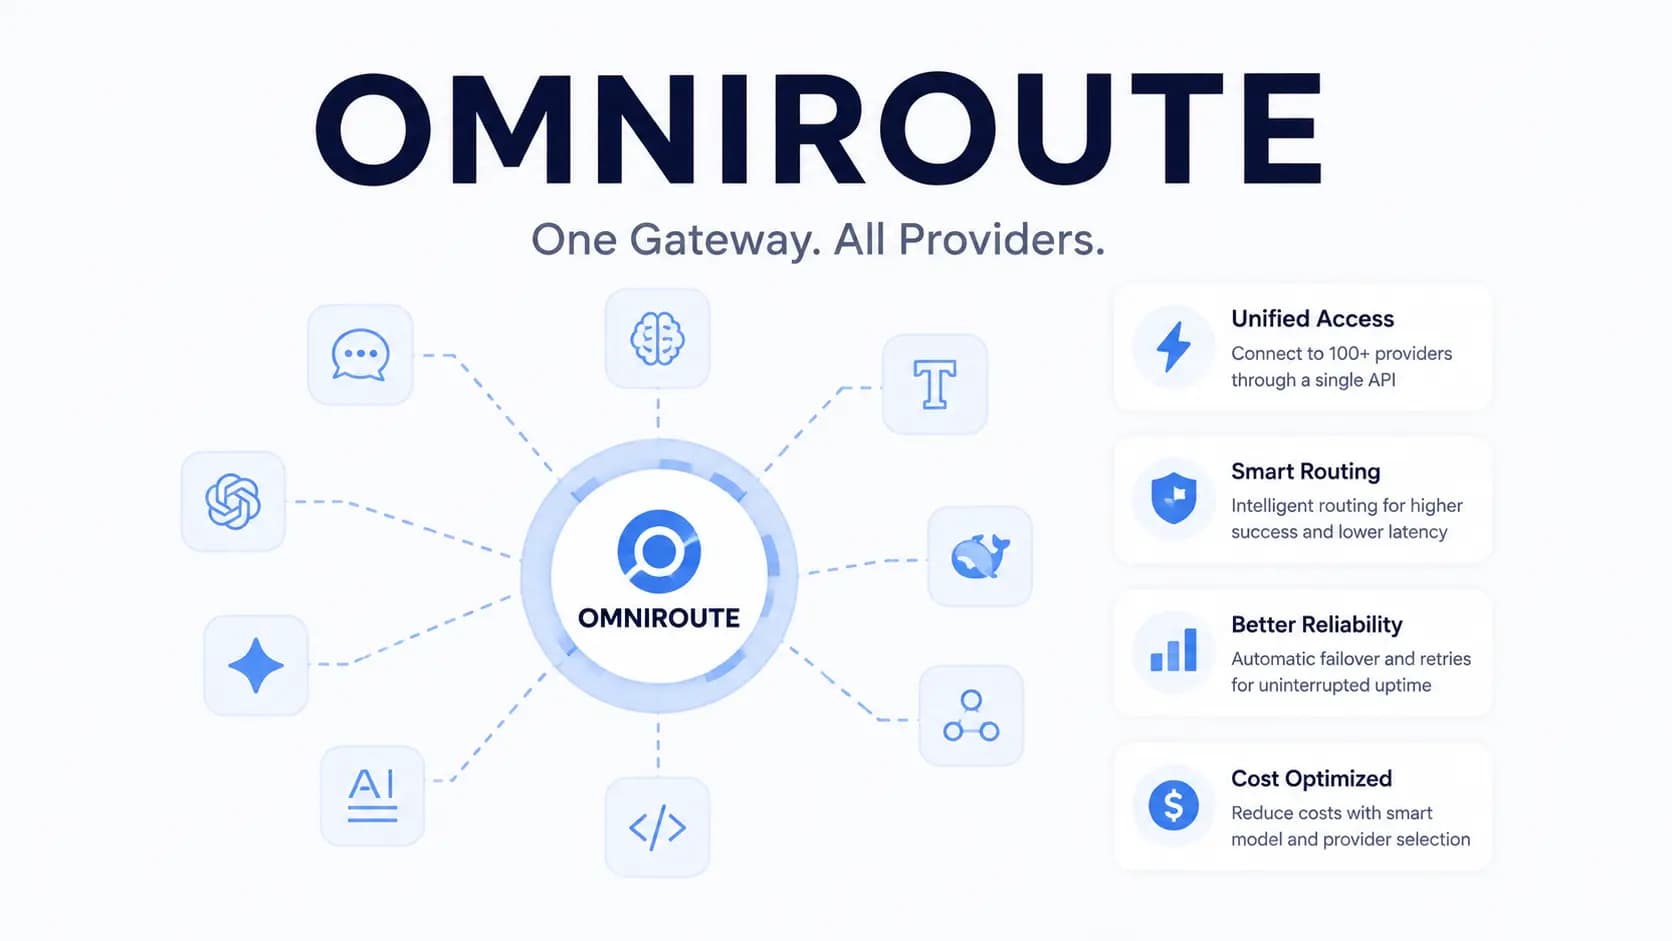
OmniRoute برای دامنهی وسیعتر: اگه علاوه بر routing، به قابلیتهایی مثل MCP server (که خود gateway رو به یه ابزار قابلکنترل توسط agent تبدیل میکنه)، A2A، یا حافظهی مکالمه هم نیاز داری، OmniRoute دامنهی گستردهتری داره. تعداد provider هاش هم بهطور محسوسی بیشتره (۳۳۹ در مقابل حدود ۴۰ تا ۶۰).
نکتهی مشترک قبل از استفادهی جدی
هر دو ابزار، صرفنظر از اینکه کدومش رو انتخاب کنی، یه ویژگی مشترک مهم دارن که باید بهش توجه کنی: مسیر کردن ترافیک از طریق این gateway ها، پردازش یا شرایط استفادهی provider اصلی (مثل اوپنایآی یا آنتروپیک) رو حذف نمیکنه؛ فقط یه لایهی اضافه بین تو و اون provider اضافه میکنن. همچنین، هر دو تبدیل به یه نقطهی حیاتی تو مسیر درخواستهات میشن؛ اگه gateway از کار بیفته یا تنظیماتش خراب بشه، همهی ابزارهایی که ازش عبور میکنن تحت تأثیر قرار میگیرن. برای استفادهی جدی یا تیمی، حتماً به فکر بکآپ تنظیمات و یه plan B (برگشت مستقیم به provider اصلی در صورت قطعی gateway) باش.
جمعبندی
اگه اولویتت سادگی و یه راهحل تمرکزیافته برای مشکل rate limit است، 9Router انتخاب سبکترییه. اگه دنبال یه پلتفرم کاملتر با تعداد provider بیشتر و قابلیتهای اضافه مثل MCP و A2A هستی، و راحتی با پیچیدگی بیشتر مشکلی نداری، OmniRoute گزینهی جامعتریه. چون هر دو رایگان و متنبازن، عملاً هیچ هزینهای برای امتحان کردن هر دوشون و دیدن اینکه کدوم با workflow خودت بهتر جفت میشه نداری.
فشردهسازی توکن: با ترکیب چند تا موتور فشردهسازی (که خودشون بهش میگن RTK و Caveman)، خروجی ابزارها و context تکراری رو قبل از رسیدن به مدل فشرده میکنه؛ طبق ادعای پروژه، بین ۱۵ تا ۹۵ درصد صرفهجویی تو مصرف توکن، بسته به نوع کار.
استفاده از quota رایگان: پروژه ادعا میکنه بیش از ۹۰ provider با پلن رایگان رو ردیابی میکنه و مصرف رایگان رو بهصورت pool-deduped (بدون شمارش تکراری) جمع میزنه؛ رقمی که خودشون حدود ۱.۵ میلیارد توکن رایگان در ماه اعلام میکنن.
پشتیبانی از MCP و A2A: خود gateway بهعنوان یه سرور MCP هم عمل میکنه (بیش از ۱۰۰ ابزار در قالب چند ده scope)، و از پروتکل A2A هم پشتیبانی میکنه؛ یعنی یه agent میتونه مستقیم خود OmniRoute رو بهعنوان یه ابزار کنترل کنه، نه فقط ازش عبور کنه.
نکتهی مهم قبل از استفادهی جدی
قبل از اینکه این ابزار رو رو یه workflow حساس یا production تکیه بدی، چند تا نکته رو باید در نظر بگیری. اول، مسیر کردن ترافیک از طریق gateway خودت، پردازش، شرایط استفاده، یا نگهداری دادهی provider اصلی رو حذف نمیکنه؛ دادهت هنوز به همون provider (مثلاً OpenAI یا آنتروپیک) میرسه، فقط از یه لایهی اضافه عبور کرده. دوم، این ابزار خودش یه نقطهی حیاتی تو مسیر درخواستهات میشه؛ اگه down بشه، تنظیماتش خراب بشه، یا دیتابیس local ش (SQLite) کرش کنه، همهی ابزارهایی که ازش عبور میکنن تحت تأثیر قرار میگیرن. برای همین، برای استفادهی جدی، حتماً باید persistence، بکآپ، و کنترل دسترسی مناسب رو خودت تنظیم کنی.
یه نکتهی دیگه هم اینه که چون این پروژه خیلی تازه و بهشدت پرتغییره (۲۷۱ نسخه تو کمتر از چهار ماه)، بهتره قبل از هر آپدیت، یه نسخهی مشخص رو pin کنی و رفتار ابزارهای کدنویسیت رو (streaming، tool call، context طولانی) بعد از هر آپدیت جدا تست کنی، نه اینکه فقط بر اساس لیست مدلها قضاوت کنی که همهچیز درست کار میکنه.
جمعبندی
اگه خسته شدی از مدیریت دستی چند تا کلید API و برخورد مکرر با rate limit وسط کار، OmniRoute یه راهحل عملی و رایگانه که با یه دستور نصب میشه و تقریباً با هر ابزار agentic معروفی (Claude Code، Cursor، Codex، Cline، Copilot) سازگاره. ولی برای پروژههای production یا تیمی، بهتره اول یه دورهی ارزیابی جدی (تست کیفیت پاسخ، latency، failover واقعی) قبل از تکیهی کامل روش انجام بدی؛ چون production-ready بودن این ابزار، بیشتر به تنظیمات و تستهای خودت بستگی داره تا صرفاً نصب و راهاندازیش.
معایب: اکوسیستم کوچیکتر از Next.js، یعنی احتمال اینکه به یه مشکل خیلی خاص برخوردی که کسی قبلاً حلش نکرده، بیشتره. بعضی ویژگیهای پیشرفته (مثل معادل دقیق React Server Components) هنوز به بلوغ Next.js نرسیدن. تقاضای بازار کار هم بهطور کلی از React و Next.js کمتره.
کجا مناسبه: تیمهایی که از قبل Vue استفاده میکنن یا اون رو ترجیح میدن، پروژههایی که میخوان انعطاف deploy رو (بدون قفل شدن رو یه پلتفرم خاص) حفظ کنن، و کسایی که یه تجربهی توسعهی هماهنگتر و کمدردسرتر میخوان.
SvelteKit (روی Svelte)
SvelteKit فرق بنیادیتری با بقیه داره، چون خود Svelte هم یه فلسفهی متفاوت داره: بهجای virtual DOM، Svelte موقع build کد رو به جاوااسکریپت خالص و بهینه compile میکنه.
مزیتها: چون Svelte خیلی از کار رو موقع build انجام میده (نه runtime)، باندل خروجی معمولاً خیلی کوچیکتر و اجرا سریعتره؛ برای اپهایی که performance رو سخت اندازه میگیرن این مزیت محسوسه. سینتکس Svelte هم بهطور کلی مختصرتر و به HTML/CSS/JS استاندارد نزدیکتره، پس برای خیلیها یادگیریش سریعتره. SvelteKit خودش هم adapter های رسمی برای deploy رو پلتفرمهای مختلف داره.
معایب: اکوسیستم بهطور قابلتوجهی کوچیکتر از React و Vue است؛ تعداد کتابخونههای آماده، مثالها، و متخصصینی که بشه استخدام کرد کمتره. بازار کار هم برای Svelte محدودتره، پس اگه هدفت جذب نیرو یا پیدا کردن شغله، این یه ریسکه. بعضی ابزارهای شخص ثالث (مخصوصاً کتابخونههای UI بزرگ) دیرتر یا هیچوقت پشتیبانی از Svelte اضافه نمیکنن.
کجا مناسبه: پروژههایی که performance و سایز باندل واقعاً حیاتیه (مثل اپهای موبایل-محور یا با شبکهی ضعیف)، تیمهای کوچیک که میخوان سریع یاد بگیرن و بسازن، و کسایی که از پیچیدگی اضافهی اکوسیستمهای بزرگتر خسته شدن.
Remix (روی React)
Remix هم رو React ساخته شده، ولی فلسفهش با Next.js فرق داره؛ Remix تمرکز خیلی زیادی روی استانداردهای وب (مثل Web Fetch API) و مدل قدیمیتر ولی قویترِ «فرمهای HTML بهعنوان روش اصلی mutation» داره. از سال ۲۰۲۴ به بعد، Remix و React Router به هم نزدیکتر شدن و تیمشون هم زیر چتر Shopify فعالیت میکنه.
مزیتها: مدل data loading و mutation ش (با loader و action) خیلی ساده و قابلپیشبینیه، و بهشدت رو progressive enhancement تمرکز داره؛ یعنی اپلیکیشن حتی بدون جاوااسکریپت هم (تا حد زیادی) کار میکنه، چون از فرمهای HTML استاندارد استفاده میکنه. برای اپلیکیشنهایی با فرمهای زیاد و تعامل سرور-محور، این مدل خیلی طبیعیتر از حالتهای پیچیدهی client-side state حس میشه. نزدیکی به استانداردهای وب هم یعنی دانشی که یاد میگیری قابلانتقالتره.
معایب: اکوسیستمش نسبت به Next.js کوچیکتره، و بعد از ادغام با React Router، مسیر و آیندهی پروژه یهکم برای بعضی توسعهدهندهها مبهم به نظر رسیده. پشتیبانی از React Server Components هم هنوز به بلوغ Next.js نرسیده.
کجا مناسبه: اپلیکیشنهای فرممحور و data-heavy (مثل داشبورد ادمین یا پنلهای مدیریتی)، تیمهایی که به progressive enhancement و استانداردهای وب اهمیت میدن، و پروژههایی که میخوان از پیچیدگی مدل Server/Client Component فاصله بگیرن.
TanStack Start (روی React)
TanStack Start جدیدترین بازیگر این میدونه، از همون تیمی که TanStack Query و TanStack Router رو ساختن (Tanner Linsley). برخلاف بقیه که از یه framework بزرگ شروع کردن، TanStack Start از یه router کاملاً type-safe شروع شده و بهش قابلیتهای full-stack اضافه کرده.
مزیتها: type-safety فوقالعادهای داره؛ چون بر پایهی TanStack Router ساخته شده، پارامترهای URL، search params، و حتی loader ها بهطور کامل با TypeScript type-check میشن، چیزی که تو بقیهی framework ها معمولاً باید دستی یا با ابزار جدا مدیریت بشه. ادغام native و روون با TanStack Query هم برای مدیریت state سرور یه مزیت بزرگه، مخصوصاً برای کسایی که از قبل با TanStack Query کار کردن.
معایب: جدیدترین گزینهی این لیسته، یعنی هنوز اکوسیستم، مستندات کامل، و تعداد پروژههای production که باهاش ساخته شدن بهاندازهی بقیه نیست. برای تیمهایی که ریسکگریزن یا نیاز به یه framework کاملاً جاافتاده دارن، فعلاً انتخاب پرریسکتریه.
کجا مناسبه: پروژههایی که TypeScript و type-safety براشون اولویت بالاییه، تیمهایی که از قبل با TanStack Query راحتن و میخوان همون فلسفه رو تو routing و SSR هم ادامه بدن، و کسایی که راحتن با یه ابزار نسبتاً جدیدتر کار کنن.
جدول مقایسهی سریع
Framework
پایه
نقطهی قوت اصلی
بلوغ اکوسیستم
Next.js
React
اکوسیستم و کامیونیتی بزرگ
خیلی بالا
Nuxt
Vue
تجربهی هماهنگ و انعطاف deploy
بالا
SvelteKit
Svelte
سایز باندل کوچیک و سرعت
متوسط
Remix
React
فرممحور و استانداردهای وب
متوسط تا بالا
TanStack Start
React
type-safety فوقالعاده
در حال رشد
مقایسهی سرعت: واقعیت پشت ادعاهای بازاریابی
یه سؤال رایج اینه: «مگه Vue همیشه از React سریعتر تبلیغ نمیشد؟» جواب کوتاه اینه که این ادعا برای زمان خودش درست بود، ولی چشمانداز از اون موقع عوض شده. ارزش داره این موضوع رو جدا و دقیقتر بررسی کنیم.
چرا Vue اول خودش رو «سبکتر و سریعتر» معرفی کرد
Vue (مخصوصاً نسخههای ۱ و ۲) از همون ابتدا مستقیم رو سایز باندل کوچیکتر و overhead کمتر نسبت به Angular و React اون دوره تمرکز کرد؛ و این ادعا واقعی بود. بخش زیادیش هم به همون مدل fine-grained reactivity برمیگشت که قبلاً توضیح دادیم: چون Vue دقیقاً میدونه کدوم بخش از UI به کدوم داده وابستهست، لازم نیست مثل React یه virtual DOM کامل رو diff کنه؛ همین یعنی overhead کمتر بدون نیاز به بهینهسازی دستی.
چیزی که از اون موقع تغییر کرده
React فاصله رو کم کرده: React مدرن، با tree-shaking بهتر، و مخصوصاً با React Server Components (که بخشی از کامپوننتها اصلاً جاوااسکریپتی به مرورگر نمیفرستن)، دیگه همون داستان باندل سنگین ۲۰۱۵ نیست.
Svelte وارد بازی شد و جلوتر افتاد: رو بنچمارکهای معروف framework (مثل js-framework-benchmark)، این روزها معمولاً Svelte/SvelteKit جلوتر از هر دوی React و Vue قرار میگیره؛ نه Vue. دلیلش اینه که Svelte حتی از فلسفهی Vue هم یه قدم جلوتر رفته: بهجای اینکه یه reactivity engine رو runtime داشته باشه (حتی fine-grained)، خود Svelte موقع build کد رو مستقیم به جاوااسکریپت خام کامپایل میکنه و کل runtime رو حذف میکنه.
تفاوت React و Vue امروز خیلی کوچیکه: رو بیشتر بنچمارکهای امروزی، React و Vue تو یه سطح قرار میگیرن؛ اختلافشون معمولاً چند درصده و بین نسخههای مختلف بنچمارک هم جابهجا میشه. چیزی که واقعاً فرق میکنه، رفتار پیشفرضه نه سقف عملکرد: React میتونه به همون سرعت Vue برسه، ولی نیاز به بهینهسازی دستی داره (useMemo، useCallback، React.memo)، در حالی که Vue این کار رو بهصورت خودکار انجام میده. یعنی داستان دقیقتر اینه که «Vue بهسختی میشه بهطور تصادفی کندش کرد»، نه اینکه «Vue همیشه سریعتره».
چرا تو دنیای واقعی این تفاوتها کمتر اهمیت دارن
نکتهی مهم اینه که تو اکثر پروژههای واقعی، خود runtime engine (چه React، چه Vue، چه Svelte) بهندرت گلوگاه اصلی performance است. چیزهایی مثل سایز باندل کلی، استراتژی server-side rendering، بهینهسازی تصویر و فونت، و مقدار جاوااسکریپتی که واقعاً به کلاینت فرستاده میشه (دقیقاً همون چیزی که Next.js با Server Components و SvelteKit با کامپایلکردن موقع build سعی میکنن حلش کنن) معمولاً تأثیر خیلی بیشتری رو تجربهی واقعی کاربر میذارن تا میکروبنچمارکهای خود reactivity engine.
جمعبندی سریع
رتبهبندی صادقانه برای سرعت خام runtime، امروز چیزی شبیه این است: SvelteKit معمولاً جلوتره (چون overhead رو موقع build حذف میکنه، نه runtime)، و React و Vue تقریباً همسطح هستن، جایی که تجربهی تیم و تصمیمات معماری بیشتر از خود engine رو نتیجهی نهایی تأثیر میذارن.
اگه دنبال امنترین انتخاب با بیشترین منابع و کامیونیتی هستی، Next.js همچنان انتخاب پیشفرضه، مخصوصاً برای پروژههای تجاری بزرگ. اگه تیمت Vue رو ترجیح میده یا میخواد انعطاف بیشتری تو deploy داشته باشه، Nuxt گزینهی طبیعیه. اگه performance و سایز باندل برات حیاتیه و حاضری اکوسیستم کوچیکتر رو تحمل کنی، SvelteKit ارزش امتحان کردن داره. اگه پروژهت پر از فرمه و به progressive enhancement اهمیت میدی، Remix فلسفهی مناسبتری داره. و اگه TypeScript و type-safety اولویت اصلیته و راحتی با یه ابزار نسبتاً جدید مشکلی نداری، TanStack Start رو جدی بگیر.
نکتهی آخر اینه که هیچکدوم از اینها انتخاب «اشتباه» نیستن؛ هر پنجتاشون production-ready هستن و شرکتهای واقعی باهاشون محصولات واقعی میسازن. تفاوت واقعی بیشتر به این برمیگرده که تیمت با کدوم فلسفه راحتتره و پروژهت به کدوم مزیت بیشتر نیاز داره، نه اینکه کدوم «بهتره».
Vue از یه مدل fine-grained reactivity استفاده میکنه؛ سیستم دقیقاً میدونه کدوم بخش از template به کدوم متغیر وابستهست، پس وقتی یه مقدار عوض میشه، فقط همون بخش خاص آپدیت میشه، بدون نیاز به اجرای دوبارهی کل تابع یا محاسبهی diff:
این تفاوت معماری یعنی Vue معمولاً بدون نیاز به optimization دستی (مثل useMemo یا useCallback تو React) عملکرد خوبی میده، در حالی که تو اپهای React بزرگ، مدیریت re-render های غیرضروری خودش به یه مهارت جدا تبدیل میشه.
سینتکس و ساختار فایل
React از JSX استفاده میکنه؛ یعنی HTML مستقیم داخل جاوااسکریپت نوشته میشه. این یعنی منطق و ساختار تو یه فایل و یه زبون هستن، که برای بعضیها طبیعیتره و برای بعضی دیگه ادغام دو دنیای متفاوت به نظر میرسه.
Vue از Single-File Component ها (فایلهای .vue) استفاده میکنه که سه بخش جدا داره: <template> برای HTML، <script> برای منطق، و <style> برای CSS، همه تو یه فایل ولی از هم مجزا. این ساختار برای کسایی که از پسزمینهی HTML/CSS سنتی میان، معمولاً آشناتر و راحتتر برای شروعه.
منحنی یادگیری
Vue معمولاً بهعنوان فریمورک سادهتر برای شروع شناخته میشه؛ مستندات رسمیش هم به همین دلیل معروفه که خیلی واضح و گامبهگامه. مفاهیم پایه (directive هایی مثل v-if، v-for، v-model) خیلی شبیه HTML گسترشیافته هستن و برای کسی که تازه شروع کرده، ورودی نرمتری فراهم میکنن.
React برای شروع هم سخت نیست، ولی چون خودش فقط کتابخونهی UI است، رسیدن به یه استک کامل (routing، state management، فرمها، styling) یعنی باید چند تا کتابخونهی جدا رو هم یاد بگیری، و هر کدوم فلسفهی خودشون رو دارن. همینطور مفاهیمی مثل closure، dependency array تو useEffect، و re-render logic، برای تازهکارها معمولاً چالشبرانگیزترن.
اکوسیستم و بازار کار
اینجا React بهوضوح جلوتره. اکوسیستمش بزرگتره، تعداد کتابخونههای شخص ثالث بیشتره، و تو بازار کار (بهخصوص تو شرکتهای بزرگ آمریکایی و اروپایی) تقاضای بیشتری داره؛ خیلی از این تقاضا هم به خاطر React Native برای توسعهی موبایله که مستقیم از همون دانش React استفاده میکنه.
Vue تو کشورهایی مثل چین و بعضی جاهای اروپا و آسیا محبوبیت بالایی داره، و اکوسیستمش هم بهطور پیوسته در حال رشده (مخصوصاً بعد از معرفی Vue 3 و Composition API)، ولی از نظر حجم موقعیت شغلی جهانی، هنوز از React عقبتره.
Next.js و Nuxt: وقتی فریمورکهای بالادستی وارد میشن
امروز خیلی از پروژههای واقعی مستقیم از React یا Vue خام استفاده نمیکنن، بلکه از یه meta-framework روی همون پایه استفاده میکنن. برای React، Next.js استاندارد de facto شده؛ server-side rendering، routing فایل-محور، و بهینهسازیهای image/font رو بهصورت آماده میده. برای Vue، معادلش Nuxt است که همون فلسفه رو دنبال میکنه. اگه داری یه پروژهی جدید شروع میکنی، احتمالاً سؤال واقعیت نه «React یا Vue»، بلکه «Next.js یا Nuxt» است، چون اینها تصمیمات معماری بیشتری رو از قبل برات گرفتن.
کدوم رو انتخاب کنیم
اگه تیمت از قبل با جاوااسکریپت راحته و میخواد از یه اکوسیستم بزرگ، فرصت شغلی بیشتر، و قابلیت اشتراک کد با موبایل (از طریق React Native) بهره ببره، React انتخاب امنتریه؛ مخصوصاً برای پروژههای بزرگ و تیمهای بزرگ که به انعطاف معماری نیاز دارن.
اگه دنبال یه منحنی یادگیری ملایمتر، مستندات واضح، و یه استک هماهنگ و رسمی (بدون نیاز به تصمیمگیریهای زیاد دربارهی کتابخونهها) هستی، یا تیمت کوچیکتره و میخوای سریعتر به نتیجه برسی، Vue گزینهی راحتتریه.
نکتهی آخر اینه که از نظر عملکرد خام، هر دو فریمورک برای اکثریت قریببهاتفاق پروژهها بهاندازهی کافی سریع هستن؛ تفاوت عملکردشون تو دنیای واقعی بهندرت فاکتور تعیینکنندهست. انتخاب واقعی معمولاً بیشتر به تجربهی تیم، اکوسیستم مورد نیاز، و فلسفهی توسعهای که باهاش راحتتری برمیگرده، نه یه برتری فنی قطعی یکی نسبت به اون یکی.
همین عدم قطعیت باعث شده خیلی از توزیعهای لینوکس بزرگ (مثل Debian و Fedora) و کلود پرووایدرهای بزرگ (AWS با Amazon ElastiCache و Google Cloud با Memorystor) به سمت پشتیبانی از Valkey حرکت کنن یا حداقل گزینهی Valkey رو کنار Redis ارائه بدن.
کدوم رو باید انتخاب کنی
اگه یه پروژهی جدید رو از صفر شروع میکنی و لایسنس متنباز کاملاً آزاد (BSD) برات اهمیت داره، یا میخوای مطمئن باشی که هیچ تغییر لایسنسی تو آینده گریبانت رو نمیگیره، Valkey انتخاب منطقیتریه؛ مخصوصاً که پشتوانهی چند تا از بزرگترین شرکتهای زیرساخت دنیا رو داره و توسعهش هم فعاله.
اگه از قبل با Redis کار میکنی و به ابزارها، افزونهها یا سرویسهای خاصی که مستقیم از Redis Ltd. میان وابستهای (مثل Redis Enterprise یا بعضی ماژولهای اختصاصی)، یا اصلاً لایسنس براتون مسئلهی حادی نیست، ادامه دادن با Redis همچنان گزینهی معتبریه؛ خصوصاً که با AGPL نسخهی ۸، دوباره به یه مسیر متنباز برگشته.
نکتهی عملی آخر: چون این دو پروژه از یه نقطهی مشترک شروع شدن، مهاجرت بینشون (تو هر جهتی) هنوز نسبتاً کمدردسره، پس تصمیم امروز لزوماً برای همیشه قفل نمیشه. اگه مطمئن نیستی، شروع با Valkey ریسک کمتری داره؛ چون برگشتن به Redis همیشه یه گزینهی باز باقی میمونه.
dbm: متد جدید reorganize() در dbm.dumb و dbm.sqlite3 برای بازیابی فضای خالی.
difflib: پارامتر color در unified_diff()؛ استایل بهتر و مهاجرت به HTML5 در HtmlDiff.
email: خطای صریح وقتی یه EmailMessage بهخاطر آدرس غیر-ASCII قابل flatten کردن نیست.
faulthandler: پارامتر max_threads در چند تابع.
functools:singledispatchmethod() حالا از callableهای غیر-descriptor پشتیبانی میکنه و میتونه روی آرگومان دوم dispatch کنه.
gc: garbage collector افزایشی که توی 3.14.0-3.14.4 اومده بود، بهخاطر فشار حافظهی زیاد توی production به همون GC نسلی 3.13 برگردونده شده (از 3.14.5 به بعد هم همینه).
hashlib: attributeهای hash function همیشهدردسترس، حتی اگه backend (مثل OpenSSL) نصب نباشه، دیگه AttributeError نمیدن.
http.client: پارامتر keyword-only جدید max_response_headers.
http.server: لاگ رنگی پیشفرض؛ پارامتر default_content_type و گزینهی --content-type؛ extra_response_headers و گزینهی -H/--header.
inspect: پارامترهای inherit_class_doc و fallback_to_class_doc در getdoc().
json: پارامتر array_hook در load()/loads() برای سفارشیسازی آرایهها؛ ترکیب با frozendict برای ساختار immutable تودرتو.
locale: پشتیبانی از @-modifier توی setlocale()/getlocale()؛ getdefaultlocale() از حالت deprecated خارج شده.
math: توابع جدید isnormal()، issubnormal()، fmax()، fmin()، signbit().
mimetypes: MIME typeهای بیشتر؛ تغییر نام application/x-texinfo به application/texinfo؛ نوع MIME فایلهای .ai به application/pdf تغییر کرده.
mmap: پارامتر trackfd روی ویندوز؛ متد set_name() برای نامگذاری mapping ناشناس روی لینوکس ۵.۱۷ به بالا.
os: تابع جدید os.statx() روی لینوکس؛ پارامتر parent_mode در makedirs().
os.path: پشتیبانی از حالت all-but-last در realpath()؛ مقدار جدید os.path.ALLOW_MISSING برای پارامتر strict.
pathlib: پارامتر parent_mode در Path.mkdir().
pdb: استفاده از شل تعاملی جدید بهعنوان ورودی پیشفرض.
pickle: پشتیبانی از pickle کردن متدهای private و کلاسهای تودرتو.
pickletools: خروجی CLI رنگی پیشفرض.
pprint: آرگومان expand برای فرمت شبیه json.dumps؛ پشتیبانی از t-string.
re: توابع جدید re.prefixmatch()/Pattern.prefixmatch() بهعنوان اسم صریحتر برای match() (که الان soft-deprecated شده).
resource: ثابتهای جدید RLIMIT_NTHR، RLIMIT_UMTXP، RLIMIT_THREADS، RLIM_SAVED_CUR، RLIM_SAVED_MAX.
shelve: متد reorganize()؛ پشتیبانی از توابع سریالسازی سفارشی.
socket: ثابتهای پروتکل ISO-TP CAN.
sqlite3: تکمیل کلیدواژهی SQL با تب، پرامپتها و خطاهای رنگی، تکمیل نام جدول/ایندکس/تریگر/ویو/ستون/تابع/schema با تب توی CLI.
ssl: ثابت HAS_PSK_TLS13؛ متدهای جدید مدیریت گروههای key agreement (set_groups/get_groups/group())؛ متد set_ciphersuites() برای TLS 1.3؛ متدهای مدیریت الگوریتم امضا (get_sigalgs, set_client_sigalgs, set_server_sigalgs و...).
subprocess:Popen.wait() با timeout حالا از مکانیزم event-driven کارآمدتر استفاده میکنه (pidfd+poll روی لینوکس، kqueue روی مک/BSD).
symtable: متدهای Function.get_cells() و Symbol.is_cell().
sys: namespace جدید sys.abi_info.
sys.monitoring: رویدادهایی مثل PY_THROW/PY_UNWIND/RAISE حالا بهصورت per-code-object قابل غیرفعالسازیان.
tarfile: چند اصلاحیهی امنیتی برای path traversal و symlink (چند CVE رفع شده)؛ رفتار بهتر با symlinkهای ویندوزی.
threading: توابع serialize_iterator، synchronized_iterator()، concurrent_tee() برای دسترسی همزمان به iterator/generator.
timeit: خروجی و traceback رنگی پیشفرض؛ تنظیم قابلکانفیگ زمان هدف autorange() و گزینهی --target-time.
tkinter: آرگومانهای جدید nolinestop/strictlimits برای Text.search()؛ متد search_all()؛ متدهای pack_content()/place_content()/grid_content().
tokenize: خروجی CLI رنگی پیشفرض.
tomllib: پشتیبانی از TOML 1.1.0 (newline و trailing comma در inline table، نوتیشن \xHH، ثانیهی اختیاری در datetime/time).
types: نوع types.FrameLocalsProxyType برای proxy مربوط به frame.f_locals.
typing: PEP 747 (TypeForm)، PEP 728 (آرگومانهای closed/extra_items در TypedDict)، PEP 800 (دکوریتور @typing.disjoint_base)؛ چند رفتار اشتباه قدیمی در ترتیب type parameter پروتکلها اصلاح شده؛ TypeVarTuple حالا bound/covariant/contravariant/infer_variance قبول میکنه.
unicodedata: آپدیت به Unicode 17.0.0؛ توابع isxidstart()/isxidcontinue()، iter_graphemes()، grapheme_cluster_break()، indic_conjunct_break()، extended_pictographic()، block().
unittest:assertLogs() فرمتر قبول میکنه؛ assertWarns()/assertWarnsRegex() دیگه هشدارهای غیرمرتبط رو قورت نمیدن و nested context manager هم پشتیبانی میشه.
urllib.parse: پارامتر missing_as_none در urlsplit/urlparse/urldefrag؛ پارامتر keep_empty در urlunsplit/urlunparse.
venv: روی POSIX دایرکتوریهای platlib بهجای symlink lib64 -> lib ساخته میشن.
warnings: فیلتر بهتر بر اساس ماژول در warn_explicit() وقتی آرگومان module داده نشده.
wave: پشتیبانی از فرمت WAVE ممیز شناور (IEEE)؛ متدهای getformat()/setformat()؛ setparams() هم تاپل ۷تایی هم ۶تایی قبول میکنه.
webbrowser: روی مک، کلاس جدید webbrowser.MacOS بهجای AppleScript از /usr/bin/open استفاده میکنه؛ تشخیص مرورگر پیشفرض از فایل تنظیمات LaunchServices.
xml: توابع جدید is_valid_name() و is_valid_text().
xml.parsers.expat: توابع تنظیم آستانه برای محافظت در برابر مصرف حافظهی نامتناسب و حملات billion-laughs.
zlib: توابع adler32_combine() و crc32_combine() برای ترکیب چکسامهای Adler-32 و CRC-32.