Consistent Hashing: چطور یه سیستم توزیعشده رو در برابر اضافه و کم شدن سرور مقاوم میکنه
حدود ۴ دقیقه مطالعه
فرض کن یه سیستم کش داری با ۴ تا سرور، و برای اینکه بدونی هر کلید (key) رو روی کدوم سرور بذاری، از یه hash ساده استفاده میکنی: server = hash(key) % 4. این روش تا وقتی تعداد سرورها ثابت بمونه خوب کار میکنه. ولی همین که یه سرور اضافه یا حذف کنی و عدد ماژول از ۴ به ۵ تغییر کنه، تقریباً تمام کلیدها به یه سرور جدید map میشن. یعنی کل کش تو یه لحظه بیاعتبار میشه و همهی درخواستها یهو به سراغ دیتابیس اصلی میرن؛ اتفاقی که بهعنوان cache stampede شناخته میشه و میتونه دیتابیس رو زیر فشار له کنه.
ایدهی consistent hashing
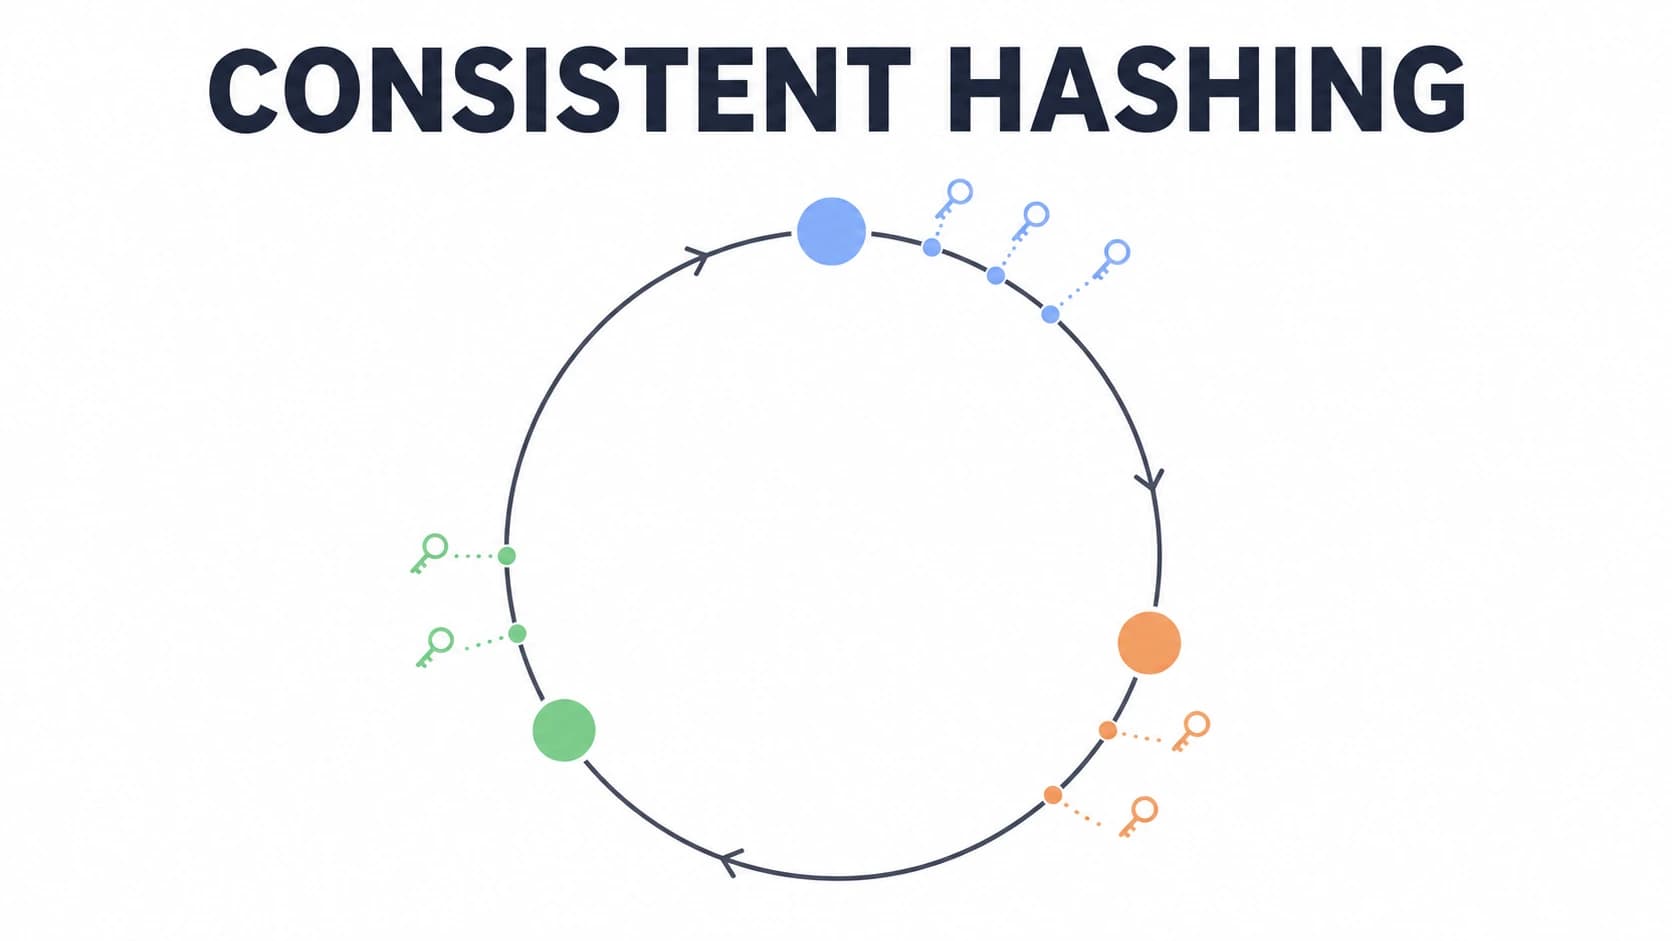
Consistent hashing این مشکل رو با یه ترفند مفهومی حل میکنه: بهجای ماژول گرفتن از تعداد سرورها، هم کلیدها و هم سرورها رو روی یه حلقهی دایرهای (معمولاً با بازهی ۰ تا ۲۳۲-۱) hash میکنیم. برای پیدا کردن اینکه یه کلید باید روی کدوم سرور بشینه، از نقطهی مربوط به اون کلید روی حلقه شروع میکنیم و در جهت عقربههای ساعت حرکت میکنیم تا به اولین سرور برسیم.
نکتهی کلیدی اینجاست: وقتی یه سرور جدید اضافه یا حذف بشه، فقط کلیدهایی که بین اون سرور و همسایهی قبلیش روی حلقه قرار دارن جابهجا میشن، نه همهی کلیدها. به زبون ریاضی، اضافه یا حذف یه node، بهطور میانگین فقط K/N از کلیدها رو جابهجا میکنه (که K تعداد کل کلیدها و N تعداد سرورهاست)، بهجای تقریباً همهی کلیدها.
import hashlib
import bisect

class ConsistentHash:
    def __init__(self, nodes=None, replicas=100):
        self.replicas = replicas
        self.ring = {}
        self.sorted_keys = []
        for node in nodes or []:
            self.add_node(node)

    def _hash(self, key):
        return int(hashlib.md5(key.encode()).hexdigest(), 16)

    def add_node(self, node):
        for i in range(self.replicas):
            h = self._hash(f"{node}-{i}")
            self.ring[h] = node
            bisect.insort(self.sorted_keys, h)

    def remove_node(self, node):
        for i in range(self.replicas):
            h = self._hash(f"{node}-{i}")
            del self.ring[h]
            self.sorted_keys.remove(h)

    def get_node(self, key):
        h = self._hash(key)
        idx = bisect.bisect(self.sorted_keys, h) % len(self.sorted_keys)
        return self.ring[self.sorted_keys[idx]]
چرا فقط یه نقطه برای هر سرور کافی نیست
اگه هر سرور رو فقط با یه نقطهی واحد روی حلقه نشون بدیم، توزیع کلیدها خیلی نامتوازن میشه؛ ممکنه یه سرور فاصلهی خیلی بزرگی از حلقه رو پوشش بده و یکی دیگه فقط یه بخش کوچیک. راهحل رایج استفاده از virtual node هاست: بهجای یه نقطه، هر سرور فیزیکی رو با چند صد نقطهی مجازی (مثلاً ۱۰۰ تا ۲۰۰ تا) روی حلقه پخش میکنیم. کد بالا دقیقاً همین کار رو با پارامتر replicas انجام میده.
هرچی تعداد virtual node ها بیشتر باشه، توزیع بار بین سرورها یکنواختتر میشه، ولی به قیمت مصرف حافظهی بیشتر برای نگهداشتن این نقاط اضافه. تو عمل، عددی بین ۱۰۰ تا ۵۰۰ virtual node به ازای هر سرور فیزیکی معمولاً تعادل خوبی بین یکنواختی و overhead میده.
کجا واقعاً ازش استفاده میشه
Amazon DynamoDB و Cassandra از consistent hashing برای پارتیشنبندی داده بین node های کلاستر استفاده میکنن؛ این یکی از دلایل اصلیه که این دیتابیسها میتونن node اضافه یا کم کنن بدون اینکه کل کلاستر مجبور به rebalance کامل بشه.
Memcached و سیستمهای caching مشابه هم از همین تکنیک استفاده میکنن تا وقتی یه سرور کش از دسترس خارج میشه، فقط بخش کوچیکی از کشها miss بشن، نه همهشون.
CDN ها و load balancer های توزیعشده هم از نسخههای مشابهی از این ایده برای مسیریابی ترافیک به سمت نزدیکترین یا سالمترین سرور استفاده میکنن، بهطوری که وقتی یه edge server از کار میافته، فقط ترافیک مربوط به همون بخش از حلقه نیاز به جابهجایی داره.
محدودیتهایی که باید بدونی
Consistent hashing مشکل نامتوازنی سرورها رو حل میکنه، ولی خودش یه مشکل دیگه ایجاد میکنه: اگه سرورها ظرفیتهای متفاوتی داشته باشن (مثلاً یکی دو برابر رم بقیه داره)، نمیتونی بهسادگی همه رو با تعداد virtual node یکسان روی حلقه بذاری. راهحلش اینه که تعداد virtual node هر سرور رو متناسب با ظرفیتش تنظیم کنی؛ سروری که ظرفیت دو برابر داره، دو برابر virtual node هم میگیره.
نکتهی دیگه اینه که consistent hashing بهتنهایی replication رو مدیریت نمیکنه. اگه بخوای هر کلید روی چند سرور کپی بشه (برای fault tolerance)، باید علاوه بر پیدا کردن اولین سرور روی حلقه، N سرور بعدی رو هم بهعنوان replica در نظر بگیری؛ همون کاری که Cassandra و DynamoDB زیر پوستشون انجام میدن.