با اینکه گوگل بهطور رسمی این مدل رو معرفی کرده، هنوز خیلی از جزئیات فنی مثل معماری دقیق یا اندازهی مدل منتشر نشده — چیزی که این روزها برای مدلهای فلش عادی شده. یه نکتهی دیگه هم اینه که طبق شایعات، جمینای ۴ (نسخهی flagship بعدی گوگل) الان توی مرحلهی posttraining هست و نتایج pretrainingش هم امیدوارکننده گزارش شده. یعنی این ۳.۸ فلش احتمالاً فقط یه ایستگاه میونیه، نه مقصد نهایی. اگه با ابزارهای کدنویسی کار میکنی و از خانوادهی فلش استفاده میکنی، به نظرم ارزش تست کردن همین حالا رو داره — قیمتش که فرقی نکرده، ولی اینکه توی کار روزمره چقدر واقعاً بهتر از ۳.۷ حس بشه، چیزیه که فقط با امتحان کردن دستگیرت میشه.
نکتهی requestCert: true و rejectUnauthorized: true اینجاست که اگه کلاینت certificate معتبر نداشته باشه، اصلاً اجازهی وصل شدن پیدا نمیکنه — قبل از اینکه حتی یه خط از کد اپلیکیشنت اجرا بشه. برای API های داخلی حساس، mTLS یکی از قویترین گزینههاست. مشکلش اینه که مدیریت certificate ها (تمدید، revoke کردن، rotate کردن) خودش یه پروژهی جداست؛ اگه چند تا سرویس داری و مدیریتش برات سخته، ابزارهایی مثل service mesh (Istio، Linkerd) این کار رو خودکار میکنن.
از JWT کاربر برای ارتباط سرویس به سرویس استفاده نکن
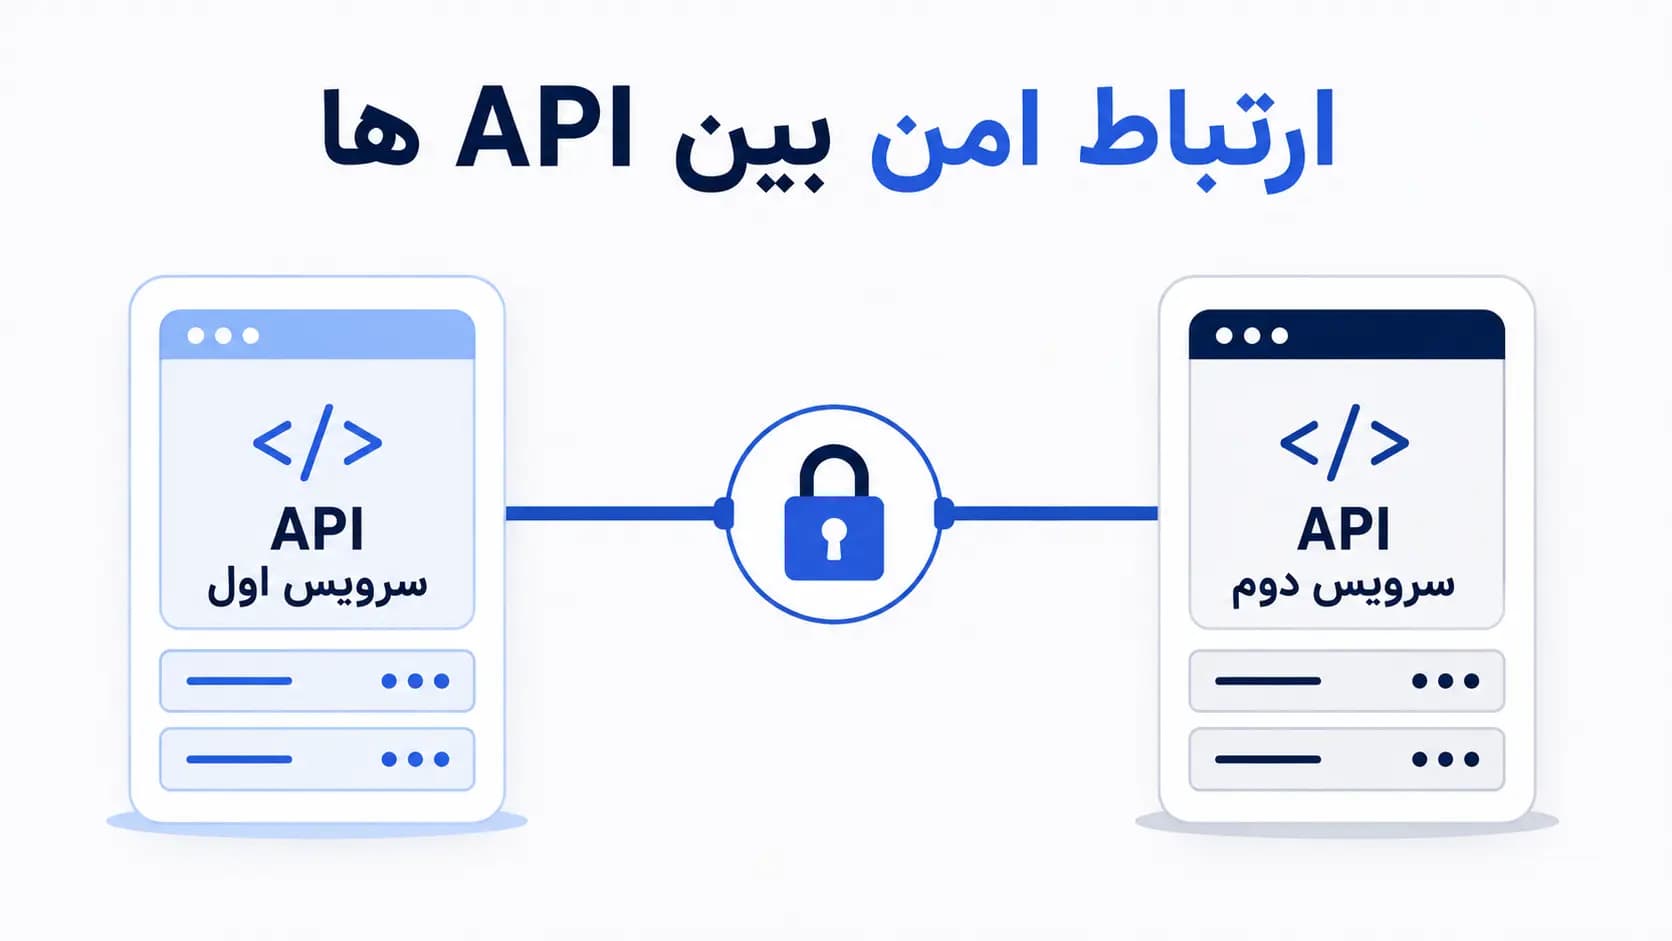
یه اشتباه رایج اینه که همون JWT ای که برای احراز هویت کاربر نهایی صادر شده رو برای ارتباط بین دو تا سرویس backend هم دوبارهکاری میکنن — یعنی چیزی شبیه Authorization: Bearer <user-jwt> رو بین سرویسها پاس میدن. این کار مرز بین «هویت کاربر» و «هویت سرویس» رو از بین میبره و باعث میشه permission های کاربر و سرویس قاطی بشن. به جاش باید یه credential مخصوص machine-to-machine داشته باشی. گزینههای خوب اینجا شامل OAuth 2.0 Client Credentials، mTLS، درخواستهای امضاشده (signed requests)، ترکیب API key و HMAC، و توکنهای کوتاهمدت سرویسمحور هستن.
برای بیشتر زیرساختهای متوسط، ترکیب OAuth 2.0 Client Credentials بههمراه HTTPS انتخاب معقولیه؛ برای ارتباطات داخلی که واقعاً حساس هستن، mTLS بههمراه توکنهای کوتاهمدت گزینهی قویتریه.
هر سرویس هویت خودش رو داشته باشه
یه اشتباه دیگه که خیلی رایجه: یه کلید API واحد و master برای همهچیز. چیزی شبیه یه متغیر محیطی به اسم MASTER_API_KEY که همهی سرویسها ازش استفاده میکنن. مشکل این روش اینه که وقتی یکی از سرویسها compromise بشه، عملاً کل سیستم compromise شده — چون همه از یه کلید استفاده میکردن.
راه درستتر اینه که هر سرویس یه service account مخصوص خودش داشته باشه، و به هر کدوم فقط همون permission هایی که واقعاً بهش نیاز داره داده بشه. مثلاً اگه سرویس A فقط باید کاربر بسازه و بخونه، نباید اصلاً امکان حذف کاربر یا دسترسی به بخش پرداخت رو داشته باشه:
سرویس A → مجاز به: create_user, read_user, update_access
سرویس A → غیرمجاز به: delete_user, access_payments, access_admin, access_database
به این اصل، least privilege میگن: هر جزء از سیستم فقط دسترسیای رو داشته باشه که برای انجام کارش لازمه، نه بیشتر. این سادهترین و در عین حال مؤثرترین اصلی هست که خیلی از تیمها فراموشش میکنن.
احراز هویت با تعیین دسترسی فرق داره
احراز هویت (authentication) به این سؤال جواب میده: «تو کی هستی؟» و تعیین دسترسی (authorization) به این سؤال: «تو اجازهی چه کاری رو داری؟» یه فرض اشتباه رایج اینه که فکر کنیم چون یه request احراز هویت شده، پس قابل اعتماده. این درست نیست. باید هر endpoint جداگانه چک بشه که آیا سرویسی که این درخواست رو فرستاده، مجوز انجام همین عملیات خاص رو داره یا نه. مثلاً POST /users ممکنه نیاز به مجوز user:create داشته باشه، در حالی که DELETE /users/:id ممکنه به یه مجوز کاملاً متفاوت نیاز داشته باشه که خیلی محدودتر بهش داده میشه.
امضای درخواستها با HMAC
برای APIهایی که سطح امنیتی بالاتری میخوان، امضای درخواست (request signing) با HMAC یه لایهی اضافهی خیلی خوبیه. ایده اینه که هر دو سرویس یه secret مشترک دارن، و هر request قبل از ارسال با اون secret امضا میشه:
سمت سرور، همین امضا دوباره از روی method، path، timestamp و body محاسبه میشه و با چیزی که تو header اومده مقایسه میشه. اگه یکی وسط راه request رو بگیره و مثلاً ایمیل داخل body رو عوض کنه، امضا دیگه match نمیکنه و request رد میشه — بدون اینکه اصلاً لازم باشه محتوای request رمزنگاری بشه؛ همین که تغییرناپذیریش تضمین بشه کافیه.
محافظت در برابر replay attack
فقط امضا کردن request کافی نیست. اگه کسی یه request معتبر و امضاشده رو ضبط کنه و بعداً دوباره همونو بفرسته، امضا هنوز معتبره چون چیزی توش عوض نشده. این همون replay attack هست. راهحلش ترکیب سه چیزه: timestamp، یه شناسهی یکتا برای هر request (نانس یا request-id)، و امضا:
منطق سمت سرور این شکلیه: اول چک میشه timestamp توی یه بازهی معقول هست (مثلاً کمتر از پنج دقیقه اختلاف با زمان فعلی سرور)، بعد چک میشه که این request-id قبلاً پردازش نشده (این بخش معمولاً با یه cache سریع مثل Redis پیاده میشه، با یه TTL برابر با همون بازهی زمانی)، و اگه هر دو شرط برقرار بود، امضا verify میشه و در نهایت request-id ذخیره میشه تا دفعهی بعد تکراری تشخیص داده بشه. بدون این مکانیزم، حتی امضای HMAC هم در برابر یه حملهی سادهی «ضبط و پخش دوباره» بیدفاعه.
شبکه رو محدود کن، این شاید مهمترین قدمه
اگه سرویس B فقط قراره از طرف سرویس A صدا زده بشه، هیچ دلیلی نداره که اصلاً از اینترنت عمومی در دسترس باشه. این یکی از نکاتی هست که تأثیرش روی امنیت کلی سیستم از خیلی چیزهای دیگه بیشتره، چون هر لایهی امنیتی دیگهای که بذاری (authentication، rate limit، signature) باز هم در معرض حمله قرار میگیره اگه شبکه بهطور عمومی باز باشه.
ابزارهایی که برای این کار به کار میان شامل قوانین فایروال، security group های ابری، شبکهی خصوصی (VPC)، VPN یا WireGuard، IP allowlist، و DNS داخلی هستن. ایدهآل اینه که ترافیک بین دو سرویس فقط از یه شبکهی خصوصی رد بشه، نه از مسیر عمومی اینترنت که بعد پشت فایروال فیلتر بشه. این دو تا از نظر امنیتی خیلی با هم فرق دارن، حتی اگه نتیجهی نهایی مشابه به نظر برسه.
هیچوقت دسترسی مستقیم دیتابیس نده
یه اشتباه خطرناک که گاهی توی معماریهای عجلهای دیده میشه اینه که یه سرویس بیرونی، مستقیماً credential دیتابیس سرویس دیگه رو داشته باشه. حتی اگه این credential محدود به یه کاربر readonly باشه، این کار لایهی authorization اپلیکیشن رو کاملاً دور میزنه. مسیر درست همیشه از طریق API میگذره: سرویس A فقط باید از طریق HTTPS و API عمومی سرویس B باهاش حرف بزنه، و سرویس B خودش تصمیم میگیره که این عملیات با توجه به authorization چطور روی دیتابیس اجرا بشه. سرویس A هیچوقت نباید بتونه کاری بیشتر از اونی که API صراحتاً exposed کرده انجام بده.
اعتماد کورکورانه به ورودی، حتی از سرویس داخلی
حتی اگه یه request از یه سرویس authenticated بیاد، بازم باید ورودیهاش validate بشن — schema، طول رشتهها، فرمت شناسهها، URL ها، اسم فایلها، enum ها، بازهی عددی، و حجم payload. یه نکتهی خاص اینجا مربوط به SSRF هست: اگه سرور تو بر اساس یه URL که از سمت کاربر یا سرویس دیگه اومده (مثلاً یه فیلد callback_url) یه request جدید میسازه، بدون validate کردن اون آدرس ممکنه یه آسیبپذیری SSRF ایجاد بشه که مهاجم بتونه از طریق سرورت به منابع داخلی شبکه دسترسی پیدا کنه که اصلاً نباید بهشون دسترسی داشته باشه.
rate limit فقط برای ترافیک بیرونی نیست
یه سرویس authenticated لزوماً امن نیست. اگه سرویس A به هر دلیلی — یه باگ، یه حلقهی بینهایت، یه retry logic خراب — شروع کنه به بمباران کردن سرویس B، معتبر بودن token یا امضا هیچ کمکی نمیکنه. گذاشتن rate limit حتی روی ترافیک کاملاً داخلی، چیزیه که خیلی وقتها دیر بهش فکر میکنیم؛ معمولاً بعد از اینکه یه بار یه سرویس داخلی کل کلاستر رو از پا درآورده. منطقیترین کار اینه که برای هر endpoint بر اساس هزینهی محاسباتیش یه سقف جدا تعریف کنی؛ یه request خواندنی ساده و یه عملیات export سنگین طبیعتاً نباید سقف یکسانی داشته باشن.
لاگ کردن، اما نه هر چیزی
وقتی یه چیزی خراب میشه، اولین جایی که سراغش میری لاگهاست. صرفاً لاگ کردن مسیر و متد request (POST /users) کافی نیست؛ چیزهایی که واقعاً کمککننده هستن شامل timestamp، اسم سرویس فرستنده، endpoint، شناسهی یکتای request، نتیجهی عملیات، تصمیم authorization، آدرس IP مبدأ، و latency میشن. نکتهی خیلی مهم اینه که هیچوقت secret ها یا credential های حساس رو توی لاگ ننویسی — این خودش یه منبع رایج نشت اطلاعاته که کمتر بهش توجه میشه.
مقایسهی روشهای ارتباطی
انتخاب پروتکل بین دو سرویس بیشتر به الگوی استفاده بستگی داره تا امنیت، هرچند بعضی گزینهها ذاتاً برای یه سناریوی خاص مناسبترن:
روش
مناسب برای
REST روی HTTPS
APIهای عمومی پلتفرم، انعطافپذیر و پرکاربرد
GraphQL روی HTTPS
کوئریهای منعطف سمت کلاینت
gRPC با mTLS
ارتباط سرویسبهسرویس داخلی، latency پایین
WebSocket
ارتباط real-time دوطرفه
صف پیام (Message Queue)
عملیات async و پسزمینهای
اتصال مستقیم به دیتابیس
باید کاملاً پرهیز بشه
HTTP بدون TLS
هیچوقت
برای ارتباط بین دو پلتفرم مستقل، REST بههمراه HTTPS و OAuth2 (یا mTLS برای موارد حساستر) یه انتخاب کاملاً محکمه. برای میکروسرویسهای داخلی که تعداد زیادی درخواست کوچیک و پرتکرار با هم رد و بدل میکنن، gRPC یا یه message broker معمولاً منطقیتره.
نکتهای که در آخر ارزش تکرار کردن داره: هدف طراحی یه API که «هک کردنش غیرممکنه» نیست — چنین چیزی وجود خارجی نداره. هدف اینه که سیستم رو طوری بچینی که compromise شدن یه جزء، خودکار به compromise شدن همهچیز منجر نشه. ایزوله کردن شبکه، least privilege، credential های جداگانه برای هر سرویس، محدود کردن دسترسی دیتابیس، و دفاع در عمق، در عمل خیلی بیشتر از انتخاب REST یا GraphQL یا هر پروتکل دیگهای روی امنیت واقعی سیستم تأثیر میذارن.
safeguardهای دقیقتر برای سایبری و زیستشناسی
آنتروپیک safeguardهای امنیتیش رو هم بازبینی کرده تا false positive کمتری تولید کنن. توی حوزهی سایبری، safeguardهای جدید حدود ۶۰ درصد کمتر مداخله میکنن؛ بخشی از این به این خاطره که Fable 5.1 حالا اجازه داره برای پیدا کردن آسیبپذیری نرمافزاری (کار دفاعی) استفاده بشه، هرچند هنوز برای ساختن exploit واقعی اجازه نداره؛ کارهای dual-use مثل تست نفوذ، تولید exploit و اسکن آسیبپذیری باینری همچنان به مدلهای Opus هدایت میشن. توی حوزهی زیستشناسی هم safeguardهای جدید حدود ۸۵ درصد کمتر روی سؤالات بیخطر پزشکی و زیستشناسی پایه فعال میشن؛ ولی سؤالات مرتبط با تحقیق و توسعهی جدی در علوم زیستی همچنان به مدلهای Opus هدایت میشن، مگه از طریق برنامهی دسترسی Mythos.
Enterprise Frontier Safeguards؛ حفظ حریم خصوصی بدون از دست دادن کنترل
یکی از تغییرات مهم این نسخه، معرفی سیستم Enterprise Frontier Safeguards (EFS) ـه؛ سیستمی که به مشتریهای سازمانی اجازه میده دیتاشون رو روی زیرساخت ابری خودشون (نه سرورهای آنتروپیک) نگه دارن، در حالی که همچنان از محافظت در برابر سوءاستفاده برخوردارن. این یعنی حریم خصوصی معادل zero data retention، بدون اینکه آنتروپیک به دیتای خام دسترسی داشته باشه. EFS طی این پاییز و بهتدریج روی Claude Code، Claude Enterprise، Claude Platform، Amazon Bedrock، Google Agent Platform و Microsoft Foundry فعال میشه؛ تا اونموقع، مشتریهای واجد شرایط میتونن از Fable 5.1 با همون zero data retention استفاده کنن. برای بقیه، پیشفرض همچنان ۳۰ روز نگهداری دیتا برای مانیتورینگ ایمنیه، چون Fable 5.1 توسط آنتروپیک بهعنوان یه Covered Model دستهبندی شده.
مکانیزمهای ضد تقطیر (anti-distillation)
Fable 5.1 مکانیزمهای محکمتری برای جلوگیری از حملات distillation (تقطیر مدل، یعنی استخراج صنعتی تواناییهای یه مدل بزرگ برای بازتولید توی یه مدل دیگه بدون safeguard) داره. از این به بعد، اکانتهای API جدید (از تاریخ عرضه به بعد) دیگه نمیتونن context قبلی مکالمه رو دستی ویرایش کنن و در عین حال transcript تفکر قبلی کلاد رو حفظ کنن؛ این دقیقاً همون تکنیک شناختهشدهای بود که برای استخراج غیرمجاز فرآیند فکری کلاد استفاده میشد. اکانتهای موجود فعلاً تحت تأثیر این تغییر نیستن.
واترمارک بهخاطر قانون هوش مصنوعی اتحادیهی اروپا
آنتروپیک ژوئیهی ۲۰۲۶ به همراه ۱۹۰ امضاکنندهی دیگه، کد رفتاری شفافیت محتوای تولیدشده با AI اتحادیهی اروپا رو امضا کرده؛ به همین خاطر از دوم آگوست ۲۰۲۶ به بعد، خروجی متنی مدلهای تازهمنتشرشده (از جمله همین Fable 5.1) یه واترمارک عددی نامرئی داره که احتمال نوشتهشدن توسط کلاد رو نشون میده. این واترمارک هیچ اطلاعاتی از کاربر یا مکالمهش نداره و روی کیفیت خروجی هم اثری نمیذاره. یه API تشخیص واترمارک هم بهصورت private preview در حال عرضهست، فعلاً برای نهادهایی مثل قانونگذارها، رسانهها، فکتچکرها و پژوهشگرهای مستقل.
Mythos 5.1 و دسترسی محدود
Mythos 5.1 از طریق دو برنامه در دسترسه: Cyber Verification Program (CVP) که فعلاً به بعضی مدلهای ردهی Opus و Sonnet با safeguard سایبری کمتر دسترسی میده و قراره بهزودی Mythos هم بهش اضافه بشه، و Life Sciences Verification Program (LSVP) که با همکاری دولت آمریکا طراحی شده و اولین گروه از متخصصهای علوم زیستی رو پذیرفته؛ ثبتنام گستردهتر هم بهزودی باز میشه. فعلاً این دسترسی محدود به سازمانهای آمریکاییه. محصول Claude Security (که کدبیسها رو برای آسیبپذیری اسکن میکنه) هم حالا با Mythos 5.1 کار میکنه.
پژوهش علمی: یه پیشنمایش از سهم AI توی علم
آنتروپیک چندتا نمونهی واقعی از قابلیتهای پژوهشی این مدلها منتشر کرده. توی طراحی مولکولی، Mythos 5.1 با دسترسی به ابزارهای متنباز طراحی و تاخوردگی پروتئین، بایندرهایی با میل ترکیبی بالا طراحی کرده که روی سه هدف مشخص، ده برابر بهتر از بهترین طرحهای ارسالی به مسابقات طراحی پروتئین Adaptyv Bio عمل کردن؛ نرخ موفقیتش هم به نزدیک ۵۰ درصد روی ۱۲ هدف رسیده، در حالی که نرخ معمول توی این حوزه ۱۰ تا ۱۵ درصده. توی یه پروژهی دیگه، Fable 5.1 یه شبکهی عصبی آموزش داده که از روی دادههای رادار ماموریت Magellan ناسا (بیش از ۳۰ سال قدمت)، یه نقشهی ارتفاعی جدید و دقیقتر از یکسوم سطح سیارهی زهره ساخته؛ وضوح از ۱۰ تا ۲۰ کیلومتر به ۲ تا ۳ کیلومتر رسیده و این نقشه با لایسنس Creative Commons منتشر شده تا به ماموریتهای آیندهی VERITAS ناسا و EnVision آژانس فضایی اروپا کمک کنه. توی زیستشناسی محاسباتی هم Mythos 5.1 با نوشتن kernelهای اختصاصی GPU، سرعت هفت مدل یادگیری عمیق متنباز رو تا ۲.۵ برابر روی یه GPU از نوع H100 بالا برده و هزینهی تحلیلهای ژنومی رو ۳۰ تا ۶۰ درصد کاهش داده؛ کاری که معمولاً چند هفته وقت یه تیم مهندس پرفورمنس رو میگیره.
در دسترس بودن
Fable 5.1 همین الان روی همهی پلتفرمها در دسترسه: Amazon Web Services، Google Cloud، Microsoft Azure، و مستقیم از طریق Claude Platform API با شناسهی مدل claude-fable-5-1. Mythos 5.1 هم همونطور که گفته شد، فقط از طریق برنامههای CVP و LSVP و فعلاً عمدتاً برای سازمانهای آمریکایی در دسترسه.
جمعبندی
Fable 5.1 بیشتر از یه آپدیت عادی، تلاشیه برای حل همزمان سه مسئلهی سازمانی: کافیقدرت بودن برای تموم کردن کارهای سخت، مقرونبهصرفه بودن برای اجرای ساعتها بدون وقفه، و قابلکنترل بودن برای دسترسی به سیستمهای حساس. عدد بنچمارکها بهوضوح بهترن، ولی همونطور که نقد Artificial Analysis نشون میده، صرفهجویی هزینه به effort انتخابی و نوع کار خیلی وابستهست؛ پس قبل از جابهجا کردن یه workload سنگین از Fable 5 یا Opus 5 به این مدل، بهتره خودت روی دادهی واقعی پروژهات تست کنی.
--builder rspack
observability بومی با @nestjs/observe
یه SDK رسمی جدید به اسم @nestjs/observe هم معرفی شده که برخلاف ابزارهای APM عمومی که HTTP server رو patch میکنن، مستقیم از طریق آپشن instrument توی چرخهی عمر خود Nest جا میگیره؛ یعنی observability یه شهروند درجهیک فریمورک شده، نه یه افزونهی بیرونی.
پکیجهای اقماری هم همراستا شدن
پکیجهای رسمی جانبی هم با همین ریتم آپدیت شدن؛ مثلاً @nestjs/config مستقیم به نسخهی ۱۲.۰.۰ پرید (نسخهی ۵ اصلاً وجود نداره)، کاملاً ESM شده، و validation محیطیش هم بهجای کد اختصاصی Joi، حالا روی Standard Schema سوار شده.
و یه پچ سریع بلافاصله بعدش
طبق معمول انتشارهای بزرگ، همون روز یا خیلی زود بعد از ۱۲.۰.۰، یه نسخهی ۱۲.۰.۱ هم منتشر شد که چندتا اصلاحیهی کوچیک روی همین انتشار تازه اعمال کرده. تا لحظهی نوشتن این خبر، ۱۲.۰.۱ آخرین نسخهی موجود روی npm برای پکیجهای اصلی NestJSه؛ پس اگه همین الان پروژهی جدیدی با Nest 12 شروع میکنی، مطمئن شو که همین نسخه رو نصب کردی.
جمعبندی
NestJS 12 دقیقاً همون آپدیتیه که کاربرهای این فریمورک سالها منتظرش بودن: ESM بدون اجبار، آزادی انتخاب کتابخونهی validation، و ابزارهای مدرنتر برای تست و بیلد. اگه پروژهات هنوز روی نسخهی ۱۱ ـه، عجلهای برای آپگرید نیست؛ ولی وقتی آماده بودی، nest upgrade --dry-run بهترین نقطهی شروعه تا قبل از هر تغییری، دقیقاً بدونی قراره چه چیزهایی عوض بشه.
اما هنوز یه مشکل وجود داره.
مشکل اینجاست که زبان و تصویر یکی نیستن
برای متن هم یه چیزی شبیه همین اتفاق میافته.
متنی که شما مینویسید اول توسط Tokenizer به توکنها تقسیم میشه و بعد این توکنها به embedding تبدیل میشن.
پس الان دو طرف داریم:
متن → Tokenizer → Embedding متنی
و
عکس → Image Encoder → Embedding تصویری
ولی این دو embedding الزاماً توی یه فضای مشترک نیستن.
اینجاست که Projection وارد داستان میشه.
Projection؛ پلی بین تصویر و متن
Projection رو میشه خیلی ساده مثل یه پل در نظر گرفت.
ویژگیهایی که از تصویر استخراج شدن، از طریق این بخش به شکلی تبدیل میشن که برای مدل زبانی قابل استفاده باشن.
در نتیجه اطلاعات تصویر میتونه در کنار اطلاعات متنی وارد فرایند پردازش مدل بشه.
یعنی بهصورت خیلی ساده:
عکس → Vision Encoder → Projection → مدل زبانی
و همزمان:
متن → Tokenizer → مدل زبانی
حالا مدل میتونه این دو نوع اطلاعات رو کنار هم داشته باشه.
مثلاً فرض کنید یه عکس از یه خیابون به ChatGPT میدید و میپرسید:
«چه ماشینی سمت راست تصویر پارک شده؟»
مدل لازم نیست اول عکس رو به یه جملهی ساده مثل «یک خیابون با یک ماشین در آن وجود دارد» تبدیل کنه.
اطلاعات تصویری به شکل embedding وارد سیستم شده و مدل میتونه اون رو در کنار سؤال شما پردازش کنه.
به همین دلیله که میتونید سؤالهای خیلی دقیقتری هم بپرسید:
«رنگ ماشین سمت راست چیه؟»
«چند نفر توی تصویر هستن؟»
«این نمودار چی رو نشون میده؟»
یا حتی:
«کد داخل این اسکرینشات چه مشکلی داره؟»
پس ChatGPT واقعاً عکس رو میبینه؟
خب، اینجا باید یه کم مراقب کلمهی «دیدن» باشیم.
ChatGPT به معنای انسانی کلمه عکس رو نمیبینه. چیزی که اتفاق میافته اینه که تصویر از طریق بخش بینایی مدل به یه نمایش عددی تبدیل میشه و این اطلاعات به شکلی در اختیار مدل زبانی قرار میگیره که بتونه روی اونها کار کنه.
از طرف دیگه، متن سؤال شما هم به توکنها و embedding تبدیل میشه.
مدل در نهایت با ترکیبی از این اطلاعات سروکار داره و بر اساس اونها پاسخ تولید میکنه.
پس چیزی که از بیرون شبیه اینه که:
«عکس رو دادم → مدل عکس رو دید → جواب داد»
در پشت صحنه خیلی بیشتر شبیه اینه:
«عکس رو دادم → بخش بینایی اون رو به نمایش عددی تبدیل کرد → این اطلاعات با ورودی متنی ترکیب شد → مدل زبانی بر اساس هر دو پاسخ تولید کرد.»
پس Multimodal دقیقاً یعنی چی؟
اسم Multimodal از همینجا میاد.
مودالیتی یا Modality یعنی نوع یا شکل اطلاعات.
متن یه modality محسوب میشه، تصویر یه modality دیگه، صدا هم یکی دیگه.
مدلهای چندوجهی بهجای اینکه فقط با یک نوع اطلاعات کار کنن، طوری طراحی شدن که بتونن چند نوع اطلاعات مختلف رو دریافت و با هم استفاده کنن.
و این دقیقاً همون چیزیه که باعث میشه بتونید یه عکس، یه سؤال متنی و حتی در بعضی مدلها فایل صوتی یا ویدئو رو به سیستم بدید و انتظار داشته باشید همهی اینها رو در کنار هم درک کنه.
یه نکته مهم
البته نباید تصور کنیم که همهی مدلهای Multimodal دقیقاً همین معماری رو دارن.
GPT، Gemini و مدلهای دیگه ممکنه از روشهای متفاوتی برای پردازش تصویر و وصل کردن اطلاعات تصویری به مدل زبانی استفاده کنن.
اما ایدهی کلی همینه:
تصویر مستقیماً به یک جملهی متنی تبدیل نمیشه؛ اول به یک نمایش عددی تبدیل میشه که مدل بتونه باهاش کار کنه.
بنابراین دفعهی بعد که یه عکس رو به ChatGPT میدید و ازش دربارهی جزئیات اون سؤال میکنید، پشت این قابلیت یه «عکس به متن» ساده وجود نداره.
یه مدل بینایی، embedding، projection و در نهایت یه مدل زبانی بزرگ دارن با هم کار میکنن تا چیزی که برای ما شبیه «فهمیدن عکس» به نظر میرسه، اتفاق بیفته.
جمعبندی
اگه از Claude Code بهصورت سنگین استفاده میکنی، بهتره از الان مصرف هفتگیت رو زیر نظر بگیری؛ چون از ۱۴ سپتامبر همون سقفی که این چند ماه بهش عادت کرده بودی، حدود یکششم کوچیکتر میشه. آنتروپیک وعده داده تغییرات دیگهای هم برای شفافتر کردن و کنترل بیشتر روی مصرف در راهه، ولی جزئیاتش هنوز اعلام نشده.
پسزمینهی امنیتی هم بیربط نیست
این معامله درست بعد از یه حادثهی هک روی Hugging Face مطرح شده که نگرانیهایی دربارهی امنیت سایبری در کنار پیشرفت سریع هوش مصنوعی ایجاد کرده بود. کلمان دولانگ، مدیرعامل Hugging Face، اون حادثه رو به اشتباهات مهندسی نسبت داده و گفته بود برای رفع مشکل از یه نسخهی انویدیاییشدهی یه مدل چینی متنباز استفاده کردن؛ و پیشبینی کرده بود امنیت سایبری مبتنی بر AI به یه بازار غولپیکر تبدیل میشه که مدلهای متنباز توش حرف اول رو میزنن.
جمعبندی
اگه این معامله نهایی بشه، یکی از بزرگترین خریدهای تاریخ انویدیا خواهد بود و بحثهای تازهای دربارهی خنثی بودن Hugging Face بهعنوان یه پلتفرم مستقل به راه میندازه؛ مخصوصاً برای شرکتهایی که از تراشههای اختصاصی رقبای انویدیا (مثل گوگل، آمازون یا آنتروپیک) استفاده میکنن. تا وقتی قرارداد رسماً امضا و اعلام نشه، بهتره این خبر رو با همون برچسب «گزارششده، نه تأییدشده» دنبال کنی.
بعدش چی؟
نسخهی نقطهای بعدی، یعنی ۲۶.۰۴.۲ LTS، فوریهی ۲۰۲۷ میاد و قراره جذابتر باشه؛ چون قراره کرنل لینوکس ۷.۲ و استک گرافیکی Mesa 26.2 رو از نسخهی بینابینی ۲۶.۱۰ (Stonking Stingray) که اکتبر امسال منتشر میشه، به ارث ببره.
جمعبندی
فارغ از اینکه چهقدر از ترافیک Cursor واقعاً به مدلهای OpenAI وابستهست، این ماجرا یه نمونهی خوب از اینه که رقابت بین شرکتهای بزرگ AI داره از سطح مدلها به سطح قراردادهای پلتفرمی هم کشیده میشه؛ جایی که تصمیمهای تجاری بزرگ (مثل خرید یه استارتاپ توسط SpaceX) میتونه مستقیماً روی اینکه یه ابزار کدنویسی به کدوم مدلها دسترسی داره اثر بذاره. برای توسعهدهندههایی که روی Cursor کار میکنن، خبر خوب اینه که سه ماه فرصت دارن قبل از اینکه این تغییر عملی بشه، و با توجه به اینکه سهم OpenAI از ترافیک محدوده، به احتمال زیاد تجربهی روزمرهشون خیلی تغییر نمیکنه.
top
UTF-8 بهصورت پیشفرض همهجا
از این نسخه به بعد، وقتی encoding رو صریح مشخص نکنی (مثلاً توی open())، پایتون بهجای وابسته بودن به تنظیمات سیستمعامل، از UTF-8 استفاده میکنه. این یعنی رفتار یکسان روی ویندوز، مک و لینوکس، ولی اگه پروژهای داری که به رفتار قدیمی وابسته بوده، بهتره از PYTHONUTF8=0 برای برگردوندن رفتار قبلی استفاده کنی یا صریحاً encoding رو همیشه مشخص کنی.
لیست کامل تغییرات
این یه فهرست کامل و تفکیکشده از هر چیزیه که توی «What's New in Python 3.15» رسمی پایتون اومده؛ دقیقاً به همون دستهبندی خود مستندات.
ویژگیهای جدید زبان
PEP 810 – واردات تنبل (lazy imports): کلیدواژهی نرم lazy برای import و from ... import؛ لود شدن ماژول تا اولین استفاده به تعویق میفته. فلگ -X lazy_imports، متغیر محیطی PYTHON_LAZY_IMPORTS، توابع sys.set_lazy_imports()/get_lazy_imports()/set_lazy_imports_filter() و متغیر ماژولی __lazy_modules__ هم اضافه شدن. فقط توی scope ماژول مجازه، نه داخل تابع یا کلاس.
PEP 814 – نوع built-in جدید frozendict: دیکشنری immutable که زیرکلاس dict نیست، اگه کلید/مقدارهاش hashable باشن خودش هم hashable میشه. ماژولهای copy، decimal، json، marshal، plistlib، pickle، pprint و xml.etree.ElementTree ازش پشتیبانی میکنن؛ eval()/exec() هم برای globals قبولش میکنن.
PEP 661 – نوع built-in جدید sentinel: برای ساختن مقادیر یکتا با representation خوانا؛ identity رو موقع کپی حفظ میکنه، با عملگر | توی type expression کار میکنه و قابل pickle شدنه.
PEP 799 – ماژول جدید profiling: شامل profiling.tracing (جایگزین cProfile، که بهعنوان alias میمونه) و profiling.sampling. ماژول قدیمی profile هم منسوخ شده و توی 3.17 حذف میشه.
پروفایلر Tachyon (profiling.sampling): یه sampling profiler آماری با overhead تقریباً صفر، سرعت نمونهبرداری تا یک میلیون هرتز، حالتهای attach/run/dump، چهار مود اندازهگیری (wall/cpu/gil/exception)، خروجیهای pstats/collapsed/flamegraph/gecko/heatmap، حالت زندهی تعاملی (--live) و پروفایل async-aware و سطح opcode.
PEP 831 – فعال بودن پیشفرض frame pointer: کامپایل CPython با فلگهای -fno-omit-frame-pointer و -mno-omit-leaf-frame-pointer، برای stack unwinding سریعتر و قابلاعتمادتر توسط پروفایلرها، دیباگرها و ابزارهای eBPF. از طریق sysconfig هم به extensionها منتقل میشه.
PEP 798 – Unpacking در comprehensionها:* و ** حالا توی list/set/dict comprehension و generator expression هم کار میکنن ([*L for L in lists] و مشابه).
PEP 829 – فایلهای پیکربندی استارتاپ پکیج (.start files): جایگزین امنتر برای خطوط import توی فایلهای .pth که کد دلخواه اجرا میکردن؛ فرمت جدید pkg.mod:callable. کلاس site.StartupState هم برای batch کردن پردازش استارتاپ اضافه شده.
PEP 803/820/793 – Stable ABI برای buildهای free-threaded (abi3t): امکان کامپایل extensionهای Stable ABI برای سازگاری با buildهای free-threaded، با API جدید PyModExport_* و ساختار PySlot.
PEP 788 – محافظت C API در برابر finalization: APIهای جدید «interpreter guard» و «interpreter view» و مکانیزمهای attach/detach خودکار thread state؛ خانوادهی PyGILState هم soft-deprecated شده (بدون برنامهی حذف).
پیامهای خطای بهتر: پیشنهاد مسیر جایگزین توی AttributeError وقتی attribute از طریق یه attribute داخلی در دسترسه؛ تشخیص متدهای زبانهای دیگه (مثل .push() جاوااسکریپتی) و پیشنهاد معادل پایتونی؛ پیشنهاد در delattr() هم اضافه شده.
تغییرات دیگر زبان
PEP 686 – UTF-8 بهعنوان انکودینگ پیشفرض: عملیات I/O بدون encoding صریح، مستقل از سیستمعامل، از UTF-8 استفاده میکنن. با PYTHONUTF8=0 یا -X utf8=0 میشه رفتار قبلی رو برگردوند.
سیستم import حالا قفلهای per-module رو به ترتیب سلسلهمراتبی میگیره؛ یه deadlock قدیمی رفع شده.
نام فایل extensionهای Stable ABI میتونه شامل multiarch tuple باشه (مثل foo.abi3-x86-64-linux-gnu.so).
attribute منسوخشدهی __cached__ روی ماژولها دیگه در نظر گرفته نمیشه؛ بهجاش از __spec__.cached استفاده کن.
پوستهی تعاملی پیشفرض (REPL)
تکمیل خودکار تب (tab completion) حالا بر اساس نوع شیء رنگی میشه (بر پایهی fancycompleter)؛ با PYTHON_BASIC_COMPLETER میشه به rlcompleter قدیمی برگشت.
ماژولهای جدید
math.integer: توابع ریاضی مخصوص آرگومانهای صحیح (PEP 791).
بهبود ماژولها
argparse:BooleanOptionalAction از گزینههای تکخطتیره و پیشوندهای جایگزین پشتیبانی میکنه؛ suggest_on_error پیشفرضش True شده؛ پشتیبانی از backtick برای هایلایت کد توی description/epilog و متن help.
array: پشتیبانی از float complex/double complex (کدهای Zf/Zd) و half-float (کد e)؛ نوع array.typecodes از str به tuple تغییر کرده.
ast: پارامتر color به dump() اضافه شده؛ خروجی CLI بهصورت پیشفرض syntax-highlighted شده.
asyncio: متد TaskGroup.cancel برای پایان زودهنگام یه گروه تسک اضافه شده.
base64: پارامتر pad در z85encode()؛ پارامتر padded در توابع b32/b64؛ پارامتر wrapcol؛ پارامتر ignorechars؛ پارامتر canonical برای رد کردن انکودینگهای غیراستاندارد.
binascii: توابع جدید Base32 (b2a_base32/a2b_base32) و Ascii85/Base85/Z85؛ پارامترهای padded، wrapcol، alphabet، ignorechars، canonical.
calendar: رنگ بیشتر توی CLI؛ خروجی HTML گزینهی year-month قبول میکنه؛ صفحات HTMLCalendar به HTML5 مهاجرت کردن و از دارکمود پشتیبانی میکنن.
collections: متدهای Counter.__xor__()/__ixor__() برای تفاضل متقارن.
concurrent.futures: گزارش خطای بهتر وقتی یه پروسهی فرزند توی ProcessPoolExecutor ناگهانی میمیره (PID و exit code رو نشون میده).
contextlib: پشتیبانی از descriptor دلخواه برای __enter__/__exit__/__aenter__/__aexit__ در ExitStack/AsyncExitStack؛ ContextDecorator/AsyncContextDecorator حالا generator/coroutine/async-generator رو تشخیص میدن و context manager رو باز نگه میدارن.
ctypes: تغییر _type_ برای انواع complex از F/D/G به Zf/Zd/Zg (سازگاری با NumPy).
mimalloc allocator پیشفرض برای تخصیص حافظهی خام شده (بهبود پرفورمنس روی buildهای free-threaded).
پیادهسازی base64 حالا ۲ برابر سریعتر انکود و ۳ برابر سریعتر دیکود میکنه.
پیادهسازی Ascii85/Base85/Z85 با C بازنویسی شده: دو مرتبه بزرگی سریعتر و کمحافظهتر.
پیادهسازی Base32 هم با C بازنویسی شده و دو مرتبه بزرگی سریعتره.
تشخیص delimiter در csv.Sniffer.sniff() تا ۱.۶ برابر سریعتر شده.
JIT کامپایلر آپدیت مهمی خورده؛ طبق pyperformance حدود ۸ تا ۹ درصد بهبود کلی سرعت.
حذفشده، منسوخشده و تغییرات C API/Build
مستندات رسمی بخشهای جداگانهای هم برای «Removed»، «Deprecated»، «C API changes» و «Build changes» داره که جزئیاتش بیشتر برای نگهدارندههای افزونهها و پکیجهای C اهمیت داره تا کاربر معمولی پایتون؛ اگه پکیجی با extension بومی نگه میداری، حتماً قبل از آپگرید این بخشها رو توی مستندات رسمی خودشون چک کن.
جمعبندی
3.15.0rc1 دقیقاً همونیه که اسمش میگه؛ یه پیشنمایش تقریباً نهایی، نه یه نسخهی آزمایشی نصفهنیمه. اگه پکیجی نگه میداری که خیلیا ازش استفاده میکنن، الان بهترین زمانه که wheel های سازگار با 3.15 رو منتشر کنی و تست کنی. برای پروژهی production خودت هم بهتره صبر کنی تا نسخهی نهایی اکتبر بیاد؛ ولی چیزهایی مثل lazy imports و frozendict به اندازهی کافی جذاب هستن که ارزش یه تست زودهنگام رو داشته باشن.
این نسخه هنوز LTS نیست
نود ۲۶ فعلاً روی خط Current قرار داره و طبق برنامهی رسمی، قراره اکتبر وارد LTS بشه. یعنی ۲۶.۸.۰ بیشتر برای کسانی مناسبه که میخوان زودتر فیچرهای جدید رو امتحان کنن؛ اگه پروژهی production داری و ثبات برات مهمتر از تازگیه، همون ۲۴.۲۰.۰ Krypton که همزمان روی LTS منتشر شده گزینهی مطمئنتریه.
در کل، ۲۶.۸.۰ از اون آپدیتهای ساکت ولی مفیده؛ هیچکدوم از تغییرات به تنهایی breaking نیستن، ولی مجموعشون زندگی رو برای کارهایی مثل ساخت zip، رمزنگاری امنتر و مدیریت statementهای sqlite کمی راحتتر میکنه.
dbm: متد جدید reorganize() در dbm.dumb و dbm.sqlite3 برای بازیابی فضای خالی.
difflib: پارامتر color در unified_diff()؛ استایل بهتر و مهاجرت به HTML5 در HtmlDiff.
email: خطای صریح وقتی یه EmailMessage بهخاطر آدرس غیر-ASCII قابل flatten کردن نیست.
faulthandler: پارامتر max_threads در چند تابع.
functools:singledispatchmethod() حالا از callableهای غیر-descriptor پشتیبانی میکنه و میتونه روی آرگومان دوم dispatch کنه.
gc: garbage collector افزایشی که توی 3.14.0-3.14.4 اومده بود، بهخاطر فشار حافظهی زیاد توی production به همون GC نسلی 3.13 برگردونده شده (از 3.14.5 به بعد هم همینه).
hashlib: attributeهای hash function همیشهدردسترس، حتی اگه backend (مثل OpenSSL) نصب نباشه، دیگه AttributeError نمیدن.
http.client: پارامتر keyword-only جدید max_response_headers.
http.server: لاگ رنگی پیشفرض؛ پارامتر default_content_type و گزینهی --content-type؛ extra_response_headers و گزینهی -H/--header.
inspect: پارامترهای inherit_class_doc و fallback_to_class_doc در getdoc().
json: پارامتر array_hook در load()/loads() برای سفارشیسازی آرایهها؛ ترکیب با frozendict برای ساختار immutable تودرتو.
locale: پشتیبانی از @-modifier توی setlocale()/getlocale()؛ getdefaultlocale() از حالت deprecated خارج شده.
math: توابع جدید isnormal()، issubnormal()، fmax()، fmin()، signbit().
mimetypes: MIME typeهای بیشتر؛ تغییر نام application/x-texinfo به application/texinfo؛ نوع MIME فایلهای .ai به application/pdf تغییر کرده.
mmap: پارامتر trackfd روی ویندوز؛ متد set_name() برای نامگذاری mapping ناشناس روی لینوکس ۵.۱۷ به بالا.
os: تابع جدید os.statx() روی لینوکس؛ پارامتر parent_mode در makedirs().
os.path: پشتیبانی از حالت all-but-last در realpath()؛ مقدار جدید os.path.ALLOW_MISSING برای پارامتر strict.
pathlib: پارامتر parent_mode در Path.mkdir().
pdb: استفاده از شل تعاملی جدید بهعنوان ورودی پیشفرض.
pickle: پشتیبانی از pickle کردن متدهای private و کلاسهای تودرتو.
pickletools: خروجی CLI رنگی پیشفرض.
pprint: آرگومان expand برای فرمت شبیه json.dumps؛ پشتیبانی از t-string.
re: توابع جدید re.prefixmatch()/Pattern.prefixmatch() بهعنوان اسم صریحتر برای match() (که الان soft-deprecated شده).
resource: ثابتهای جدید RLIMIT_NTHR، RLIMIT_UMTXP، RLIMIT_THREADS، RLIM_SAVED_CUR، RLIM_SAVED_MAX.
shelve: متد reorganize()؛ پشتیبانی از توابع سریالسازی سفارشی.
socket: ثابتهای پروتکل ISO-TP CAN.
sqlite3: تکمیل کلیدواژهی SQL با تب، پرامپتها و خطاهای رنگی، تکمیل نام جدول/ایندکس/تریگر/ویو/ستون/تابع/schema با تب توی CLI.
ssl: ثابت HAS_PSK_TLS13؛ متدهای جدید مدیریت گروههای key agreement (set_groups/get_groups/group())؛ متد set_ciphersuites() برای TLS 1.3؛ متدهای مدیریت الگوریتم امضا (get_sigalgs, set_client_sigalgs, set_server_sigalgs و...).
subprocess:Popen.wait() با timeout حالا از مکانیزم event-driven کارآمدتر استفاده میکنه (pidfd+poll روی لینوکس، kqueue روی مک/BSD).
symtable: متدهای Function.get_cells() و Symbol.is_cell().
sys: namespace جدید sys.abi_info.
sys.monitoring: رویدادهایی مثل PY_THROW/PY_UNWIND/RAISE حالا بهصورت per-code-object قابل غیرفعالسازیان.
tarfile: چند اصلاحیهی امنیتی برای path traversal و symlink (چند CVE رفع شده)؛ رفتار بهتر با symlinkهای ویندوزی.
threading: توابع serialize_iterator، synchronized_iterator()، concurrent_tee() برای دسترسی همزمان به iterator/generator.
timeit: خروجی و traceback رنگی پیشفرض؛ تنظیم قابلکانفیگ زمان هدف autorange() و گزینهی --target-time.
tkinter: آرگومانهای جدید nolinestop/strictlimits برای Text.search()؛ متد search_all()؛ متدهای pack_content()/place_content()/grid_content().
tokenize: خروجی CLI رنگی پیشفرض.
tomllib: پشتیبانی از TOML 1.1.0 (newline و trailing comma در inline table، نوتیشن \xHH، ثانیهی اختیاری در datetime/time).
types: نوع types.FrameLocalsProxyType برای proxy مربوط به frame.f_locals.
typing: PEP 747 (TypeForm)، PEP 728 (آرگومانهای closed/extra_items در TypedDict)، PEP 800 (دکوریتور @typing.disjoint_base)؛ چند رفتار اشتباه قدیمی در ترتیب type parameter پروتکلها اصلاح شده؛ TypeVarTuple حالا bound/covariant/contravariant/infer_variance قبول میکنه.
unicodedata: آپدیت به Unicode 17.0.0؛ توابع isxidstart()/isxidcontinue()، iter_graphemes()، grapheme_cluster_break()، indic_conjunct_break()، extended_pictographic()، block().
unittest:assertLogs() فرمتر قبول میکنه؛ assertWarns()/assertWarnsRegex() دیگه هشدارهای غیرمرتبط رو قورت نمیدن و nested context manager هم پشتیبانی میشه.
urllib.parse: پارامتر missing_as_none در urlsplit/urlparse/urldefrag؛ پارامتر keep_empty در urlunsplit/urlunparse.
venv: روی POSIX دایرکتوریهای platlib بهجای symlink lib64 -> lib ساخته میشن.
warnings: فیلتر بهتر بر اساس ماژول در warn_explicit() وقتی آرگومان module داده نشده.
wave: پشتیبانی از فرمت WAVE ممیز شناور (IEEE)؛ متدهای getformat()/setformat()؛ setparams() هم تاپل ۷تایی هم ۶تایی قبول میکنه.
webbrowser: روی مک، کلاس جدید webbrowser.MacOS بهجای AppleScript از /usr/bin/open استفاده میکنه؛ تشخیص مرورگر پیشفرض از فایل تنظیمات LaunchServices.
xml: توابع جدید is_valid_name() و is_valid_text().
xml.parsers.expat: توابع تنظیم آستانه برای محافظت در برابر مصرف حافظهی نامتناسب و حملات billion-laughs.
zlib: توابع adler32_combine() و crc32_combine() برای ترکیب چکسامهای Adler-32 و CRC-32.