با اینکه گوگل بهطور رسمی این مدل رو معرفی کرده، هنوز خیلی از جزئیات فنی مثل معماری دقیق یا اندازهی مدل منتشر نشده — چیزی که این روزها برای مدلهای فلش عادی شده. یه نکتهی دیگه هم اینه که طبق شایعات، جمینای ۴ (نسخهی flagship بعدی گوگل) الان توی مرحلهی posttraining هست و نتایج pretrainingش هم امیدوارکننده گزارش شده. یعنی این ۳.۸ فلش احتمالاً فقط یه ایستگاه میونیه، نه مقصد نهایی. اگه با ابزارهای کدنویسی کار میکنی و از خانوادهی فلش استفاده میکنی، به نظرم ارزش تست کردن همین حالا رو داره — قیمتش که فرقی نکرده، ولی اینکه توی کار روزمره چقدر واقعاً بهتر از ۳.۷ حس بشه، چیزیه که فقط با امتحان کردن دستگیرت میشه.
safeguardهای دقیقتر برای سایبری و زیستشناسی
آنتروپیک safeguardهای امنیتیش رو هم بازبینی کرده تا false positive کمتری تولید کنن. توی حوزهی سایبری، safeguardهای جدید حدود ۶۰ درصد کمتر مداخله میکنن؛ بخشی از این به این خاطره که Fable 5.1 حالا اجازه داره برای پیدا کردن آسیبپذیری نرمافزاری (کار دفاعی) استفاده بشه، هرچند هنوز برای ساختن exploit واقعی اجازه نداره؛ کارهای dual-use مثل تست نفوذ، تولید exploit و اسکن آسیبپذیری باینری همچنان به مدلهای Opus هدایت میشن. توی حوزهی زیستشناسی هم safeguardهای جدید حدود ۸۵ درصد کمتر روی سؤالات بیخطر پزشکی و زیستشناسی پایه فعال میشن؛ ولی سؤالات مرتبط با تحقیق و توسعهی جدی در علوم زیستی همچنان به مدلهای Opus هدایت میشن، مگه از طریق برنامهی دسترسی Mythos.
Enterprise Frontier Safeguards؛ حفظ حریم خصوصی بدون از دست دادن کنترل
یکی از تغییرات مهم این نسخه، معرفی سیستم Enterprise Frontier Safeguards (EFS) ـه؛ سیستمی که به مشتریهای سازمانی اجازه میده دیتاشون رو روی زیرساخت ابری خودشون (نه سرورهای آنتروپیک) نگه دارن، در حالی که همچنان از محافظت در برابر سوءاستفاده برخوردارن. این یعنی حریم خصوصی معادل zero data retention، بدون اینکه آنتروپیک به دیتای خام دسترسی داشته باشه. EFS طی این پاییز و بهتدریج روی Claude Code، Claude Enterprise، Claude Platform، Amazon Bedrock، Google Agent Platform و Microsoft Foundry فعال میشه؛ تا اونموقع، مشتریهای واجد شرایط میتونن از Fable 5.1 با همون zero data retention استفاده کنن. برای بقیه، پیشفرض همچنان ۳۰ روز نگهداری دیتا برای مانیتورینگ ایمنیه، چون Fable 5.1 توسط آنتروپیک بهعنوان یه Covered Model دستهبندی شده.
مکانیزمهای ضد تقطیر (anti-distillation)
Fable 5.1 مکانیزمهای محکمتری برای جلوگیری از حملات distillation (تقطیر مدل، یعنی استخراج صنعتی تواناییهای یه مدل بزرگ برای بازتولید توی یه مدل دیگه بدون safeguard) داره. از این به بعد، اکانتهای API جدید (از تاریخ عرضه به بعد) دیگه نمیتونن context قبلی مکالمه رو دستی ویرایش کنن و در عین حال transcript تفکر قبلی کلاد رو حفظ کنن؛ این دقیقاً همون تکنیک شناختهشدهای بود که برای استخراج غیرمجاز فرآیند فکری کلاد استفاده میشد. اکانتهای موجود فعلاً تحت تأثیر این تغییر نیستن.
واترمارک بهخاطر قانون هوش مصنوعی اتحادیهی اروپا
آنتروپیک ژوئیهی ۲۰۲۶ به همراه ۱۹۰ امضاکنندهی دیگه، کد رفتاری شفافیت محتوای تولیدشده با AI اتحادیهی اروپا رو امضا کرده؛ به همین خاطر از دوم آگوست ۲۰۲۶ به بعد، خروجی متنی مدلهای تازهمنتشرشده (از جمله همین Fable 5.1) یه واترمارک عددی نامرئی داره که احتمال نوشتهشدن توسط کلاد رو نشون میده. این واترمارک هیچ اطلاعاتی از کاربر یا مکالمهش نداره و روی کیفیت خروجی هم اثری نمیذاره. یه API تشخیص واترمارک هم بهصورت private preview در حال عرضهست، فعلاً برای نهادهایی مثل قانونگذارها، رسانهها، فکتچکرها و پژوهشگرهای مستقل.
Mythos 5.1 و دسترسی محدود
Mythos 5.1 از طریق دو برنامه در دسترسه: Cyber Verification Program (CVP) که فعلاً به بعضی مدلهای ردهی Opus و Sonnet با safeguard سایبری کمتر دسترسی میده و قراره بهزودی Mythos هم بهش اضافه بشه، و Life Sciences Verification Program (LSVP) که با همکاری دولت آمریکا طراحی شده و اولین گروه از متخصصهای علوم زیستی رو پذیرفته؛ ثبتنام گستردهتر هم بهزودی باز میشه. فعلاً این دسترسی محدود به سازمانهای آمریکاییه. محصول Claude Security (که کدبیسها رو برای آسیبپذیری اسکن میکنه) هم حالا با Mythos 5.1 کار میکنه.
پژوهش علمی: یه پیشنمایش از سهم AI توی علم
آنتروپیک چندتا نمونهی واقعی از قابلیتهای پژوهشی این مدلها منتشر کرده. توی طراحی مولکولی، Mythos 5.1 با دسترسی به ابزارهای متنباز طراحی و تاخوردگی پروتئین، بایندرهایی با میل ترکیبی بالا طراحی کرده که روی سه هدف مشخص، ده برابر بهتر از بهترین طرحهای ارسالی به مسابقات طراحی پروتئین Adaptyv Bio عمل کردن؛ نرخ موفقیتش هم به نزدیک ۵۰ درصد روی ۱۲ هدف رسیده، در حالی که نرخ معمول توی این حوزه ۱۰ تا ۱۵ درصده. توی یه پروژهی دیگه، Fable 5.1 یه شبکهی عصبی آموزش داده که از روی دادههای رادار ماموریت Magellan ناسا (بیش از ۳۰ سال قدمت)، یه نقشهی ارتفاعی جدید و دقیقتر از یکسوم سطح سیارهی زهره ساخته؛ وضوح از ۱۰ تا ۲۰ کیلومتر به ۲ تا ۳ کیلومتر رسیده و این نقشه با لایسنس Creative Commons منتشر شده تا به ماموریتهای آیندهی VERITAS ناسا و EnVision آژانس فضایی اروپا کمک کنه. توی زیستشناسی محاسباتی هم Mythos 5.1 با نوشتن kernelهای اختصاصی GPU، سرعت هفت مدل یادگیری عمیق متنباز رو تا ۲.۵ برابر روی یه GPU از نوع H100 بالا برده و هزینهی تحلیلهای ژنومی رو ۳۰ تا ۶۰ درصد کاهش داده؛ کاری که معمولاً چند هفته وقت یه تیم مهندس پرفورمنس رو میگیره.
در دسترس بودن
Fable 5.1 همین الان روی همهی پلتفرمها در دسترسه: Amazon Web Services، Google Cloud، Microsoft Azure، و مستقیم از طریق Claude Platform API با شناسهی مدل claude-fable-5-1. Mythos 5.1 هم همونطور که گفته شد، فقط از طریق برنامههای CVP و LSVP و فعلاً عمدتاً برای سازمانهای آمریکایی در دسترسه.
جمعبندی
Fable 5.1 بیشتر از یه آپدیت عادی، تلاشیه برای حل همزمان سه مسئلهی سازمانی: کافیقدرت بودن برای تموم کردن کارهای سخت، مقرونبهصرفه بودن برای اجرای ساعتها بدون وقفه، و قابلکنترل بودن برای دسترسی به سیستمهای حساس. عدد بنچمارکها بهوضوح بهترن، ولی همونطور که نقد Artificial Analysis نشون میده، صرفهجویی هزینه به effort انتخابی و نوع کار خیلی وابستهست؛ پس قبل از جابهجا کردن یه workload سنگین از Fable 5 یا Opus 5 به این مدل، بهتره خودت روی دادهی واقعی پروژهات تست کنی.
جمعبندی
اگه از Claude Code بهصورت سنگین استفاده میکنی، بهتره از الان مصرف هفتگیت رو زیر نظر بگیری؛ چون از ۱۴ سپتامبر همون سقفی که این چند ماه بهش عادت کرده بودی، حدود یکششم کوچیکتر میشه. آنتروپیک وعده داده تغییرات دیگهای هم برای شفافتر کردن و کنترل بیشتر روی مصرف در راهه، ولی جزئیاتش هنوز اعلام نشده.
پسزمینهی امنیتی هم بیربط نیست
این معامله درست بعد از یه حادثهی هک روی Hugging Face مطرح شده که نگرانیهایی دربارهی امنیت سایبری در کنار پیشرفت سریع هوش مصنوعی ایجاد کرده بود. کلمان دولانگ، مدیرعامل Hugging Face، اون حادثه رو به اشتباهات مهندسی نسبت داده و گفته بود برای رفع مشکل از یه نسخهی انویدیاییشدهی یه مدل چینی متنباز استفاده کردن؛ و پیشبینی کرده بود امنیت سایبری مبتنی بر AI به یه بازار غولپیکر تبدیل میشه که مدلهای متنباز توش حرف اول رو میزنن.
جمعبندی
اگه این معامله نهایی بشه، یکی از بزرگترین خریدهای تاریخ انویدیا خواهد بود و بحثهای تازهای دربارهی خنثی بودن Hugging Face بهعنوان یه پلتفرم مستقل به راه میندازه؛ مخصوصاً برای شرکتهایی که از تراشههای اختصاصی رقبای انویدیا (مثل گوگل، آمازون یا آنتروپیک) استفاده میکنن. تا وقتی قرارداد رسماً امضا و اعلام نشه، بهتره این خبر رو با همون برچسب «گزارششده، نه تأییدشده» دنبال کنی.
جمعبندی
فارغ از اینکه چهقدر از ترافیک Cursor واقعاً به مدلهای OpenAI وابستهست، این ماجرا یه نمونهی خوب از اینه که رقابت بین شرکتهای بزرگ AI داره از سطح مدلها به سطح قراردادهای پلتفرمی هم کشیده میشه؛ جایی که تصمیمهای تجاری بزرگ (مثل خرید یه استارتاپ توسط SpaceX) میتونه مستقیماً روی اینکه یه ابزار کدنویسی به کدوم مدلها دسترسی داره اثر بذاره. برای توسعهدهندههایی که روی Cursor کار میکنن، خبر خوب اینه که سه ماه فرصت دارن قبل از اینکه این تغییر عملی بشه، و با توجه به اینکه سهم OpenAI از ترافیک محدوده، به احتمال زیاد تجربهی روزمرهشون خیلی تغییر نمیکنه.
هویت مدل: بازی حدسزدن که بالاخره تموم شد
بازی حدس زدن راجع به اینکه پشت Ox Alpha کیه، بالاخره تموم شد. گوگل، شیائومی، دیپسیک و MAI مایکروسافت همه یهجایی توی این حدسزدنها مطرح شدن، ولی امروز خود Z.ai (همون Zhipu) رسماً تأیید کرد که Ox Alpha چیزی نیست جز GLM-5.3-Flash؛ اولین مدل native چندوجهی از خانوادهی GLM-5. تا قبل از تأیید رسمی، توسعهدهندهها با مقایسهی توکنایزر و انکودر ویدیو به همین نتیجه رسیده بودن، ولی حالا دیگه حدس نیست. طبق گفتهی خود Z.ai، این مدل ۳۲۰ میلیارد پارامتر کل داره ولی فقط ۱۸ میلیارد پارامترش روی هر توکن فعال میشه (یعنی معماری MoE)، تحت لایسنس MIT منتشر شده، و قراره حدود ۰.۱۵ دلار برای هر میلیون توکن ورودی قیمت بخوره؛ یعنی چیزی حدود یکدهم قیمت مدلهای همردهاش. همون شبی که خبر تأیید منتشر شد، وزنهای مدل هم عمومی شدن.
بنچمارکهای رسمی چی میگن؟
راجع به عملکرد هم عددها یکدست نیستن. یه تست دهتایی از بنچمارک DeepSWE نشون داد Ox Alpha با ۸۰ درصد، از Claude Fable 5 با ۶۵ درصد و از GPT-5.6 Sol با ۵۲ درصد جلوتره؛ ولی وقتی همین بنچمارک رو با ۱۱۳ تسک کامل اجرا کردن، عدد Ox Alpha به حدود ۶۳ درصد رسید که تقریباً همسطح GPT-5.6 Sol شد، نه اون فاصلهی چشمگیر اول. توی Kingbench هم با ۸۷.۵ درصد، پشت سر GLM-5.3 با ۹۱.۲۵ درصد قرار گرفت ولی جلوتر از Opus 4.8 که ۸۰ درصد گرفته. یه بنچمارک خصوصی دیگه هم هست که نتیجهی کاملاً متفاوتی داده و این مدل رو در حد مدلهای دو نسل قبل، مثل Kimi 2.6، ردهبندی کرده. یعنی بستگی داره چه نوع تسکی بهش بدی؛ ظاهراً روی کارهای فرانتاند و طراحی UI بهطور خاص قویتر عمل میکنه تا روی منطق خالص کد.
به هیچ عنوان نمیتونم به این بنچمارکها اعتماد کنم، چون واقعاً چیزی که من دیدم با هایپی که توی اینترنت هست روی این مدل متفاوته. شاید من اشتباه استفاده میکنم ازش.
تجربهی کاربرها
همین ناهماهنگی رو توی تجربهی کاربرها هم میبینی. بعضیها گفتن روی opencode مدام تایماوت میگیره و عملاً غیرقابل استفاده میشه، ولی همون مدل روی Hermes Agent بدون مشکل کار کرده. بعضی هم از اجراهای چند ساعته برای یه مقایسهی ساده گلایه کردن؛ که با همون کندیای که خودم حس کردم همخونی داره. از چندین نفر پرسیدم و مثل اینکه اونها هم عملاً نمیتونستن استفاده کنن ازش. من استفاده کردم، ولی چیز Wowای برای من بهشخصه نبود.
ضعفهای مدل (تجربهی خودم)
یه نکتهی دیگه که موقع کار باهاش برام مهم بود: توی نوشتن محتوای فارسی اصلاً خوب عمل نمیکنه. اگه دنبال یه مدل برای تولید متن فارسی روون میگردی، فعلاً این گزینهی خوبی نیست.
این مدل به شدت کند عمل میکنه، در حدی که قبل از این، کندترین مدلی که دیده بودم Nemotron از Nvidia بود که با اومدن این مدل جاشو گرفت برای من (نموترون رو از چند پروایدر تست کردم و همهشون همونقدر کند بودن).
من نمیدونم این جریانِ اینکه این مدل روی تسکهای UI بهشدت خوب عمل میکنه از کجا میاد؛ حقیقتاً فکر نمیکنم چیز خاصی باشه، چون شخصاً بررسیش کردم.
یه چیز جالب دیگه هم توی تستهام دیدم: وقتی به چتجیپیتی و کلاد یه دستور میدی که یک کاری رو انجام بده و بعد در حالی که روی یه پروژهی دیگهای دوباره بهش میگی همون کار قبلی رو روی این پروژه انجام بده، هر دو متوجه میشن که کانتکست فرق داره و مال یک پروژهی دیگهست و میپرسن منظورت همین پروژهی فعلیه یا اون یکی قبلی که تأیید کنی؛ ولی Ox Alpha بدون هیچ سؤالی مستقیم میره سراغ پروژهی قبلی، تا وقتی که خودم absolute path رو بهش بدم. اینجور جاهاست که فرق بین «قوی بودن توی بنچمارک» و «فهمیدن context واقعی کار تو» خودش رو نشون میده.
به نظرم بنچمارکها زیادم حقیقت رو، حداقل در استفادهی واقعی از مدلها، نمیگن.
دیگه استدلال به تنهایی ملاک نیست
یه چیزی هم که این روزها بیشتر و بیشتر حس میکنم اینه که دیگه صرفاً «قدرت استدلال» ملاک اصلی انتخاب نیست. فاصلهی بین مدلهای بالای بازار داره کم میشه و کمکم همهشون توی این بخش خوب یا خیلی خوب هستن؛ چیزی که واقعاً فرق ایجاد میکنه بیشتر سرعت، قیمت، و همون درک درست از context کاره تا صرفاً یه عدد بالاتر توی بنچمارک استدلال.
نظر خودم راجع به استفاده از GLM-5.3-Flash
رک بگم: نه. در صورتی که مدل رایگان نباشه (با این سرعت) یا اینکه مثلاً پولی بشه ولی بسیار ارزون باشه (در حد همون Spark 1.2 یا حالا یکم بالاتر) یا شاید در سطح DeepSeek Flash، من بهشخصه از این مدل، با اینکه واقعاً قدرت بالایی داره، استفاده نمیکنم؛ به چند دلیل:
استدلال رو میسپارم به مدلی که بهش اعتماد دارم، مثل Claude یا GPT، دلیلش هم اینه که برای من ثابت شدهن.
اون حجم از استدلالی که مدلهای سریعتر یا حتی رایگان نمیتونن انجام بدن رو معمولاً خودم راجبش فکر میکنم و با چندین AI مشورت میکنم، نه اینکه فقط به یک مدل بسپارمش.
جمعبندی
حالا که هویتش مشخص شده و وزنهاش هم منتشر شدن، دیگه اون بهانهی «نمیدونیم دیتامون کجا میره» با همون شدت قبل معنا نداره، ولی همچنان بهتره قبل از استفادهی جدی، مستندات رسمی Z.ai راجع به نگهداری دیتا رو خودت بخونی. تجربهی خودت با این مدل چی بوده؟ همون چیزی که بنچمارکهای رسمی میگن رو حس کردی یا مثل من فکر میکنی هنوز رقابت خاصی بین این و مدلهای OpenAI و Anthropic، حداقل در ردههای بالا، نیست؟
Ox Alpha
نگرانی جدی: بدون شرایط مشخص برای داده
مهمترین نکتهای که باید قبل از استفادهی جدی از Origin بهش توجه کنی، مربوط به دادهست. طبق گزارش TechTimes، Origin با enrollment بهصورت opt-out (نه opt-in) برای همهی کاربران پولی فعال شده؛ یعنی بهصورت پیشفرض روشنه، مگه اینکه ادمین سازمانت صراحتاً غیرفعالش کنه. در همون زمان انتشار، کرسر هیچ سند رسمیای دربارهی نگهداری داده (data retention)، افشای subprocessor ها، سیاست استفاده از کد برای آموزش مدل، یا ابزار migration برای کدهایی که مستقیم رو Origin هاست میشن منتشر نکرده بود.
این نگرانی برای تیمهایی که کد اختصاصی، دادهی شخصی کاربر تو فیکسچرهای تست، credential های احتمالی تو تاریخچهی commit، یا کدهای با محدودیتهای قانونی/رگولاتوری دارن، جدیتره؛ چون الان کدشون رو زیرساختی هاست میشه که متعلق به SpaceX است، بدون اینکه سیاست مشخصی دربارهی نحوهی استفاده از اون کد منتشر شده باشه.
دسترسی
Origin فقط برای پلنهای Pro، Teams، و Enterprise در دسترسه، نه پلن رایگان. برای سازمانهای Enterprise، ادمینها میتونن صراحتاً opt-out کنن. برای شروع، باید یه اسم codebase (namespace) رو claim کنی که فعلاً تو دورهی بتا قابل تغییر نیست، و بعد از اون میتونی ریپازیتوری جدید بسازی یا از طریق OAuth، ریپازیتوریهای گیتهابت رو sync کنی.
جمعبندی
Origin نشون میده کرسر (حالا زیر پرچم SpaceX) قصد داره فراتر از یه ادیتور کدنویسی بره و مستقیم وارد قلمروی زیرساخت توسعهی نرمافزار (همون چیزی که گیتهاب و گیتلب سالهاست توش تسلط دارن) بشه. برای تیمهایی که کاملاً درگیر اکوسیستم کرسر هستن و از agent های کدنویسی زیاد استفاده میکنن، یکپارچگی ریپازیتوری/PR/agent تو یه محیط واحد میتونه جذاب باشه. ولی با توجه به اینکه این محصول هنوز early beta است و مهمتر از همه، هیچ سند رسمیای دربارهی شرایط داده منتشر نشده، توصیه میشه قبل از هاست کردن کد حساس یا اختصاصی رو Origin، منتظر انتشار این سیاستها بمونی یا حداقل از تیم پشتیبانی کرسر مستقیم دربارهش سؤال کنی.
پایهی نظری: Metric First-Order Temporal Logic
از نظر فنی، Dogwood رو یه فرمالیسم از رشتهی runtime verification به اسم MFOTL (Metric First-Order Temporal Logic) ساخته شده. عملگرهایی که به Cedar اضافه میکنه شامل چیزهایی مثل formerly (چیزی قبلاً اتفاق افتاده؟)، count_within (چند بار تو یه بازهی زمانی؟)، count_distinct_within، و sum_within (مجموع یه مقدار تو یه بازه) هستن؛ دقیقاً همون عملگرهایی که برای بیان قوانین بالا لازمه.
ادغام با Amazon Bedrock AgentCore
Dogwood مستقیم پشت یه قابلیت جدید تو AgentCore Policy قرار گرفته؛ لایهای تو Amazon Bedrock AgentCore که مستقل از خود مدل عمل میکنه: مدل یه tool call رو پیشنهاد میده، policy engine قبولش میکنه یا ردش میکنه، و خود مدل هیچوقت مستقیم درگیر اجرای enforcement نمیشه. تا قبل از این، این چکها کاملاً stateless بودن؛ حالا با «temporal policies» که Dogwood قدرتش رو میده، این تصمیمات میتونن به تاریخچهی سشن agent هم نگاه کنن.
AWS همچنین یه ابزار به اسم Policy Authoring هم معرفی کرده که با هوش مصنوعی، سند policy نوشتهشده به زبون طبیعی رو مستقیم به قوانین Dogwood درست تبدیل میکنه؛ یعنی لازم نیست حتماً خودت سینتکس Dogwood رو یاد بگیری تا بتونی قوانین سازمانیت رو پیاده کنی.
چطور همین الان امتحانش کنیم
Dogwood زیر لایسنس Apache 2.0 منتشر شده و شامل یه راهنمای زبان و یه پیادهسازی مرجع (reference interpreter) روی گیتهابه. برای شروع:
git clone https://github.com/cedar-policy/dogwood
یه نمونهی خیلی ساده از یه قانون Dogwood که همون سناریوی پرداخت اول مقاله رو حل میکنه، تقریباً اینطور به نظر میرسه (بر پایهی گسترش Cedar):
یعنی پرداخت فقط زمانی مجازه که قبلش یه فاکتور برای همون resource ثبت شده باشه، و مجموع پرداختهای همون روز از یه سقف مشخص بیشتر نشه.
اگه از قبل رو Amazon Bedrock AgentCore کار میکنی، AgentCore Policy همین الان از Dogwood پشتیبانی میکنه و میتونی مستقیم ازش استفاده کنی. اگه رو یه استک دیگه کار میکنی، میتونی پیادهسازی مرجع رو مستقیم از گیتهاب بگیری و باهاش آزمایش کنی.
نکتهی مهم: هنوز برای production آماده نیست
خود AWS صراحتاً اعلام کرده که پیادهسازی مرجع Dogwood برای اکتشاف و تست طراحی شده، نه استفادهی production. اگه بخوای این رو تو یه محیط واقعی اجرا کنی، باید خودت چیزهایی مثل نگهداری قابلاعتماد تاریخچهی رویدادها، ایزولهسازی بین tenant های مختلف، و سیاست نگهداری داده رو پیادهسازی کنی؛ اینها جزو خود زبان یا reference interpreter نیستن.
چرا این موضوع مهمه
با گسترش استفاده از agent های خودمختار برای کارهای حساس (پرداخت، دسترسی به دادهی حساس، تغییرات زیرساختی)، مشکلی که Dogwood حلش میکنه دقیقاً همون چیزیه که این روزها تو خیلی از تیمهای مهندسی مطرحه: چطور میشه به یه agent اجازه داد کار واقعی انجام بده، بدون اینکه مجبور بشیم به کل هیستوری رفتارش اعتماد کورکورانه داشته باشیم؟ Dogwood با اضافه کردن حافظه به لایهی authorization (بدون از دست دادن قابلیتهای اثباتپذیر Cedar)، یه جواب مشخص و متنباز به این سؤال میده؛ و چون AWS از جامعه دعوت کرده که Dogwood رو تو محصولات و پروژههای خودشون هم بسازن، این رویکرد میتونه فراتر از خود AWS هم به یه استاندارد غیررسمی تبدیل بشه.
نتیجهی هر ارزیابی میتونه allow، deny، یا یه زنجیرهی پیچیدهتر شامل داور LLM یا تأیید انسانی (مثلاً از طریق Slack) باشه؛ یعنی برای عملیات پرریسک مثل kubectl delete pod، میشه درخواست رو متوقف کرد تا یه انسان تأییدش کنه.
مدیریت credential ها
یکی از نکات کلیدی طراحی اینه که credential های واقعی هیچوقت رو خود agent نمیشینن. Agent فقط یه placeholder میفرسته، و این gateway است که موقع عبور دادن ترافیک، توکن واقعی رو جایگزینش میکنه. یعنی حتی اگه agent کامل کنترل بشه یا لاگش لو بره، خود secret ها هیچوقت در معرض دید agent قرار نمیگیرن.
سه مدل استقرار
طبق ریپازیتوری رسمی گیتهاب، Claw Patrol سه شکل مختلف استقرار داره:
clawpatrol run: یه تونل مخصوص هر پروسه باز میکنه (رو لینوکس با netns، رو مک با NetworkExtension)؛ فقط ترافیک همون دستور wrapشده از gateway عبور میکنه.
clawpatrol join: یه تونل WireGuard کامل بالا میاره که کل ترافیک host رو مسیر میده.
clawpatrol gateway: خود proxy است؛ یه باینری تکی که HCL config رو لود میکنه و کلاینتها رو میپذیره.
میتونی هرکدوم از این سه شکل رو بسته به نیازت انتخاب کنی؛ لازم نیست همیشه کل host رو مسیر بدی.
چطور همین الان امتحانش کنیم
پروژه زیر لایسنس MIT منتشر شده و از طریق اسکریپت نصب خود پروژه یا از سورس (که نیاز به Go و Node.js داره) قابل بیلده. برای شروع:
# نصب سریع
curl -fsSL https://clawpatrol.dev/install.sh | sh

# یا از سورس (نیاز به Go و Node.js)
git clone https://github.com/denoland/clawpatrol
cd clawpatrol && make
بعد از نصب، یه فایل HCL برای قوانینت مینویسی (مثلاً بلاک کردن DROP TABLE رو یه دیتابیس خاص، یا نیاز به تأیید انسانی برای حذف پاد رو Kubernetes production)، و agent ت رو طوری تنظیم میکنی که ترافیکش از یکی از سه مسیر بالا عبور کنه. ابزار همچنین یه دستور clawpatrol test هم داره که میتونی قوانینت رو در برابر یه سری fixture (رکورد شده از دشبورد یا نوشتهشدهی دستی) تو CI تست کنی؛ اگه یه تغییر قانون، نتیجهی یه fixture رو عوض کنه، تست fail میشه و diff نشونت میده.
نکتهی مهم: هنوز alpha است
خود Deno صراحتاً اعلام کرده که Claw Patrol فعلاً alpha software است. پشتیبانی پروتکلها دقیقاً به اندازهی نیاز خود Deno گسترشه، نه بیشتر؛ اگه پروتکل خاصی میخوای که پشتیبانی نمیشه، باید یا خودت کدش رو اضافه کنی (مستندات کافی برای این کار هست)، یا از تیم Deno درخواست کنی. شرکت هم صراحتاً از جامعه خواسته که الگوهای قانوننویسی واقعی، پروتکلهای موردنیاز بعدی، و باگهای مسیر نصب رو گزارش بدن.
جمعبندی
اگه داری agent هایی میسازی که دسترسی نوشتنی به زیرساخت واقعی (دیتابیس، کلاستر، سرویسهای ابری) دارن، Claw Patrol یه لایهی امنیتی جدی و متنباز ارائه میده که فراتر از یه HTTP proxy ساده عمل میکنه؛ مخصوصاً به این خاطر که پروتکلهای غیر-HTTP رو هم میفهمه و credential های واقعی رو از دید خود agent مخفی نگه میداره. ولی چون هنوز alpha است، برای استفادهی production جدی، بهتره اول رو یه محیط تست یا staging امتحانش کنی و منتظر بلوغ بیشتر پروژه بمونی.
دسترسی و قیمت
Grok Bot فعلاً تو مرحلهی beta است و فقط برای مشترکین SuperGrok Heavy، Cursor Ultra، و Cursor Teams Premium در دسترسه؛ رو دسکتاپ (مک، ویندوز، لینوکس) و iOS، با اندروید که قراره بعداً اضافه بشه. مشتریان enterprise هم فعلاً باید تو یه لیست انتظار ثبتنام کنن. طبق گزارش Constellation Research، این سرویس از حدود ۱۲۰ دلار در ماه شروع میشه.
چرا الان و چرا اینقدر مهمه
با این انتشار، SpaceXAI رسماً وارد بازار agent های سازمانی میشه؛ بازاری که تا الان بیشتر تحت تسلط اوپنایآی و آنتروپیک بود. طبق گزارش Bloomberg، ایلان ماسک مستقیم تو ایکس اعلام کرده که بعد از رفع مشکلات اولیهی beta و انتشار Grok 4.6 (که قراره همون هفته بیاد)، مقیاس تست Grok Bot رو گسترش میده. این انتشار همزمان با تمرکز بیشتر SpaceX رو بخش enterprise تکنولوژی اتفاق افتاده؛ چیزی که تو گزارش سهماههی اخیر شرکت هم (چه دربارهی Cursor، چه دربارهی اتصال سازمانی از طریق Starlink) بهوضوح دیده میشه.
نگرانیهای امنیتی
طبق چند گزارش، از جمله Analytics Insight، این نوع دسترسی گسترده (login مستقیم به ابزارها و اطلاعات حساس شرکتی) نگرانیهای امنیتی جدیای هم به همراه داره؛ شرکتها احتمالاً قبل از اجازه دادن به اینجور bot ها برای دسترسی به اطلاعات حساس، به کنترلهای دسترسی سختگیرانهتری نیاز دارن. این دقیقاً همون چالشیه که هر ابزار agentic دیگهای هم که دسترسی وسیع به سیستمهای داخلی داره باهاش مواجهه.
جمعبندی
Grok Bot، مثل خیلی از محصولات agentic دیگهای که این روزها میبینیم، نشون میده صنعت هوش مصنوعی داره از مدل «سؤال و جواب ساده» به سمت «انجام کار واقعی و مستقل» حرکت میکنه. نکتهی مهمی که باید بهش توجه کرد اینه که این محصول هنوز تو مرحلهی early beta است، دسترسیش محدود به مشترکین پولی خاصیه، و مثل هر ابزار جدیدی که به سیستمهای حساس دسترسی میگیره، ارزش داره قبل از استفادهی جدی، سیاستهای امنیتی و کنترل دسترسیش رو دقیق بررسی کنی.
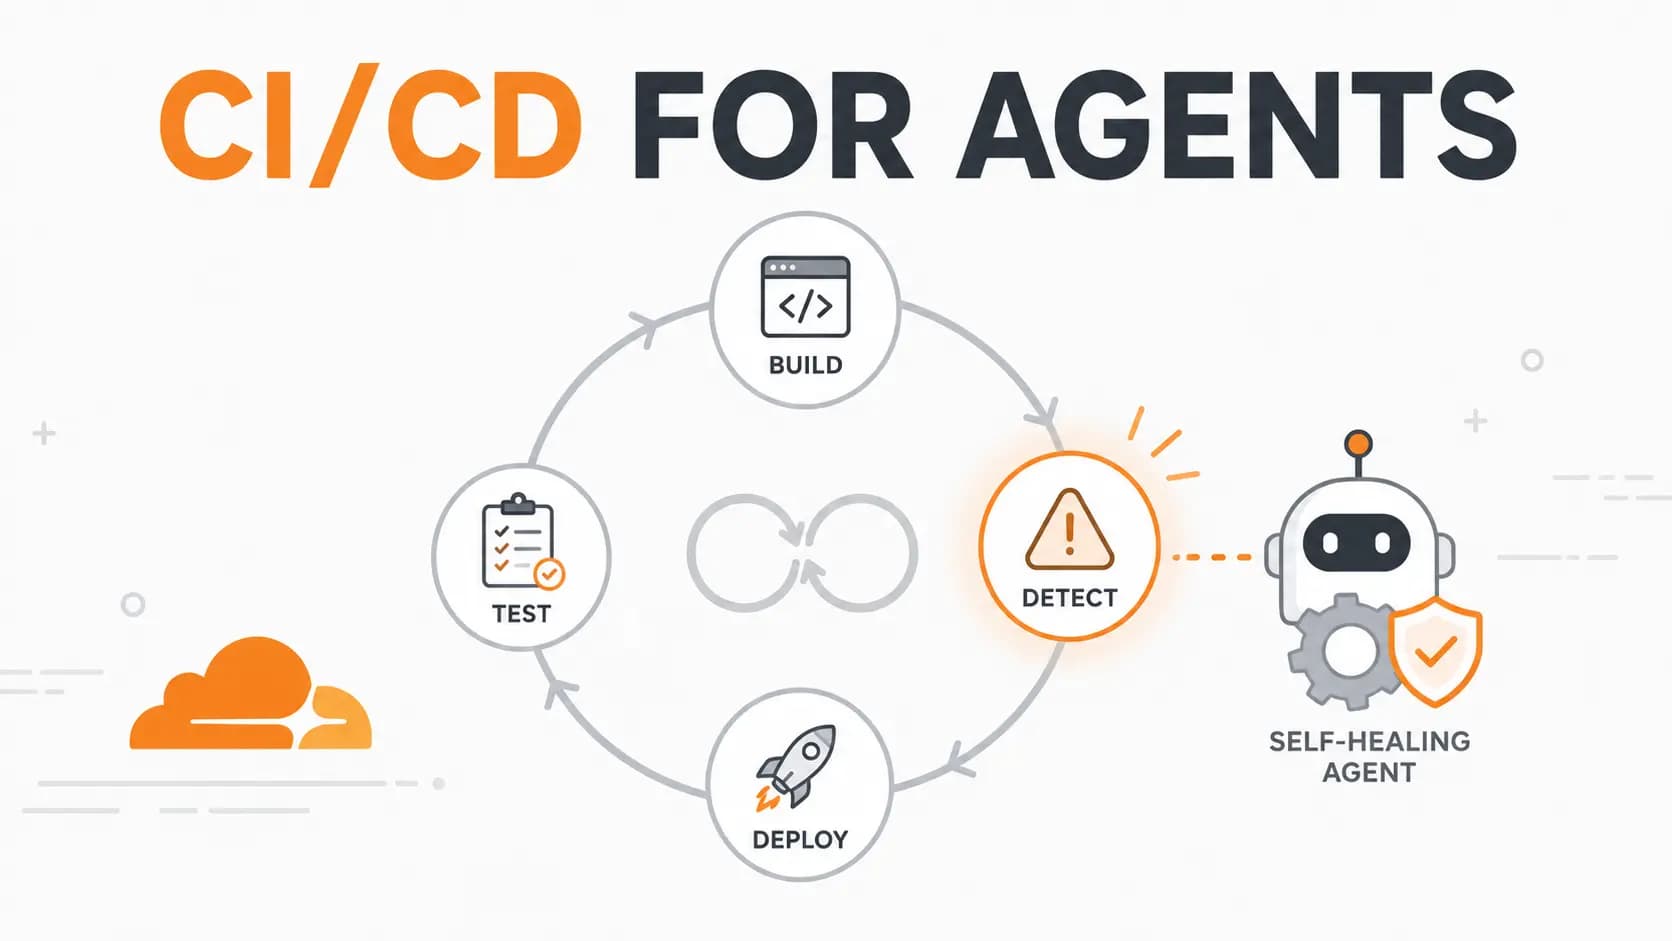
چون این پکیج مستقیم رو Cloudflare Workers اجرا میشه، نکتهی فنی مهمی داره: @cloudflare/ci یه پکیج معمولی Node.js نیست و مستقیم قابل اجرا نیست؛ باید با یه bundler آگاه به Workers (مثل Wrangler) استفاده بشه، و اگه از @cloudflare/ci/worker استفاده میکنی، باید فلگ سازگاری nodejs_compat رو فعال کنی.
بخشی از یه اکوسیستم بزرگتر
@cloudflare/ci بهتنهایی منتشر نشده؛ بخشی از یه دسته کامل از ابزارهای جدیده که کلادفلر همزمان معرفی کرده تا کل چرخهی SDLC (برنامهریزی، طراحی، پیادهسازی، تست، دیپلوی، نگهداری، بازنشستگی) رو برای agent ها قابل مدیریت کنه:
OpenTelemetry traces تو dev محلی؛ که یعنی agent همون سطح observability که تو production داره رو موقع توسعهی محلی هم داره؛ مستقیم تو Wrangler و Vite plugin کلادفلر.
Cloudflare Agents و Agent Traces؛ یه فضای جدید برای مشاهده، نگهداری، و بهبود agent ها، بر پایهی trace های OpenTelemetry.
تجربهی داخلی کلادفلر از اجرای استانداردهای مهندسی با هوش مصنوعی رو تمام ریپازیتوریها و specification هاشون.
تجربهی ساخت یه «کارخانهی نرمافزار» که تعداد issue های باز پروژهی Astro رو به صفر رسونده؛ یه سیستم خودکار برای triage، بازتولید، تأیید، و رفع مشکلات.
نکتهی معماری: Workflow بهجای YAML خطی
استدلال فنی کلادفلر اینه که یه pipeline CI/CD کلاسیک، صرفاً یه مورد خاص از یه Workflow عمومیه؛ ولی خود Workflow میتونه خیلی فراتر از این بره. تو مثال دیگهای که تو پست رسمی اومده، یه Workflow میتونه یافتههای روزانه رو جمع کنه، یه agent رو با اون context صدا بزنه، منتظر جوابش بمونه، و بر اساس نتیجه تصمیم بگیره — همهچیز تحت کنترل کامل خود Workflow، نه یه اسکریپت خطی که فقط دستورات رو پشت سر هم اجرا میکنه.
جدول کامل: کدوم ابزار کلادفلر کدوم مرحله رو پوشش میده
طبق جدولی که خود کلادفلر منتشر کرده، مراحل مختلف SDLC حالا اینطور روی ابزارهای کلادفلر map میشن:
برنامهریزی/طراحی/پیادهسازی: Vite، Rolldown، و Oxc (زنجیرهابزار سریع)، dev محلی که دقیقاً همون runtime production رو شبیهسازی میکنه، Local Explorer و Local Traces، remote bindings، و Preview URL برای هر pull request.
تست: Browser Run (مرورگرهای headless قابلبرنامهریزی تو کلاود) و پشتیبانی از Vitest مستقیم تو runtime خود Workers.
دیپلوی: Flagship (فیچر فلگ خودکار برای هر تغییر) و Gradual Deployments (رولاوت تدریجی).
نگهداری/بازنشستگی: Workers Logs (برای اینکه agent بتونه لاگ زنده رو دنبال کنه)، Agent Traces، Cloudflare MCP Server، و Analytics Engine.
این برای توسعهدهندهها چه معنایی داره
اگه از قبل رو Cloudflare Workers کار میکنی، @cloudflare/ci یه راه بومی برای ساختن pipeline هایی میده که فراتر از یه سری دستور خطی هستن؛ میتونن خودشون رو self-heal کنن و در صورت نیاز، کارهای پیچیدهتر رو به یه agent جدا بسپرن. ولی نکتهی مهم اینه که این ابزار، مثل خیلی از قابلیتهای جدید کلادفلر، عمیقاً به اکوسیستم خودشون (Workers، Workflows، Wrangler) وابستهست؛ یعنی اگه رو یه پلتفرم دیگه host میکنی، این ابزار برات مستقیماً قابل استفاده نیست.
کلادفلر خودش هم اعتراف میکنه که این فقط شروع کاره؛ به قول خودشون «primitive» های لازم الان در دسترسن، ولی کار زیادی برای اتصال کامل این قطعات به هم و یادگیری از تجربهی واقعی هنوز باقی مونده.
ذکر نشده
لایسنس
MIT
MIT
زبان پیادهسازی
TypeScript / Next.js
JavaScript
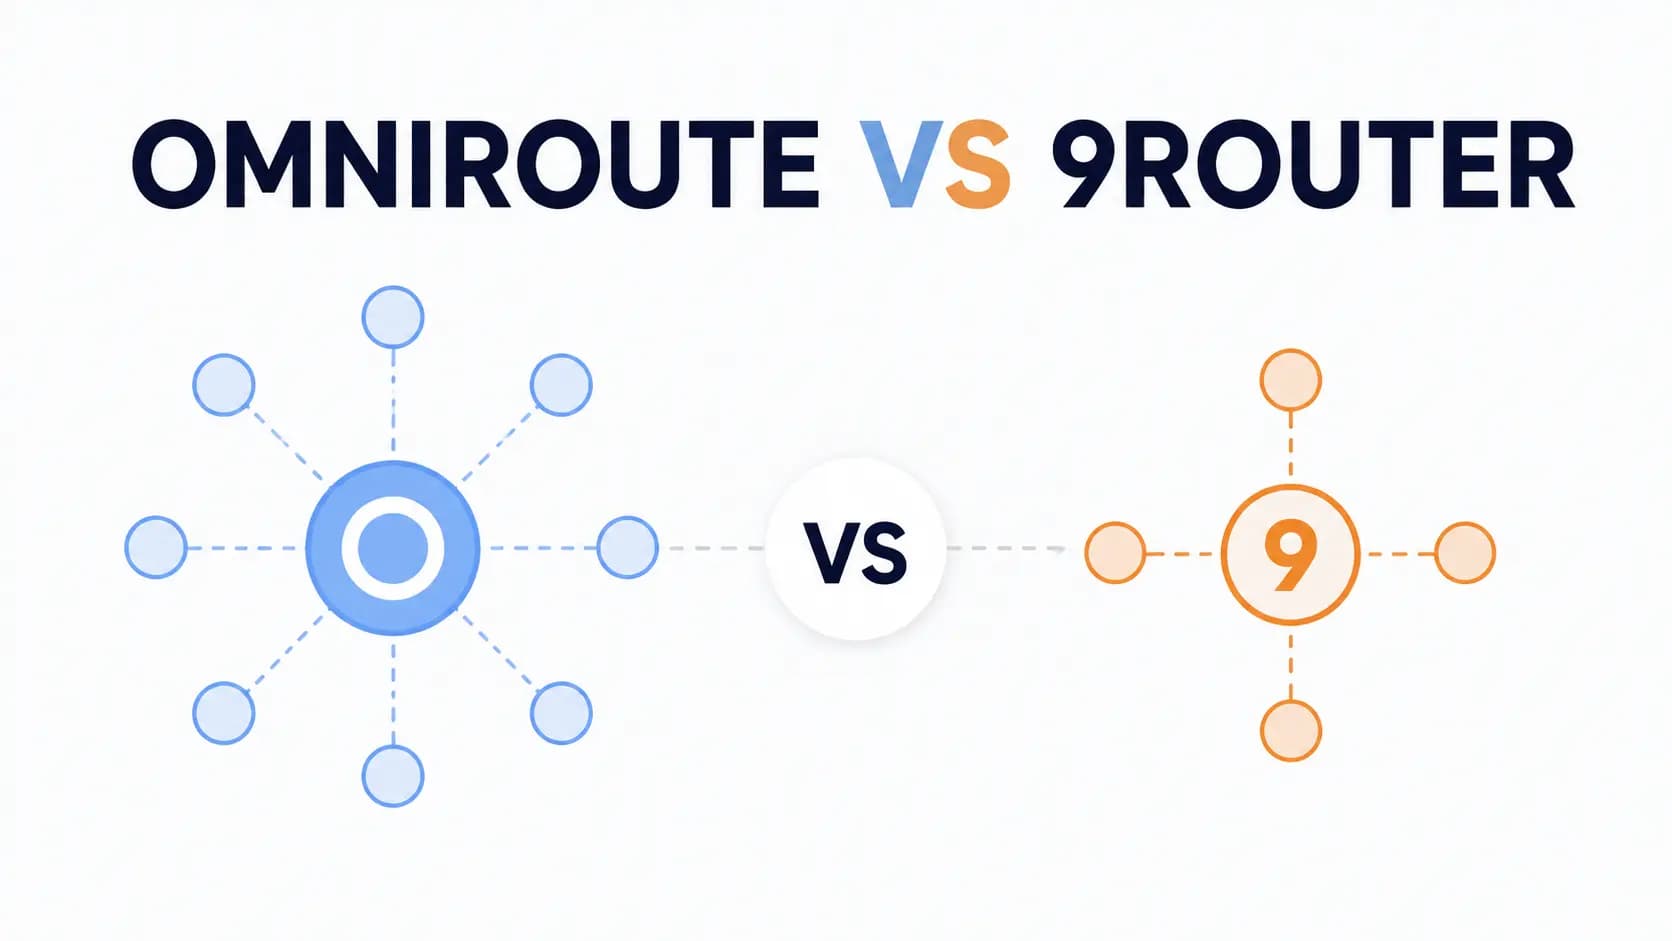
نکتهی مهم دربارهی این جدول: بخش زیادیش (مخصوصاً اعداد OmniRoute) از صفحهی مقایسهی رسمی خود سایت OmniRoute اومده، که طبیعتاً به نفع خودشه. برای همین اعداد 9Router رو از منابع مستقل (Medium، AIMojo، EveryDev.ai، NGJOO) کراسچک کردم تا تصویر متوازنتری داشته باشیم، ولی بازم توصیه میشه قبل از تصمیم نهایی، خودت این دو تا رو مستقیم امتحان کنی.
کجا هرکدوم برندهست
9Router برای سادگی و تمرکز: اگه فقط میخوای مشکل rate limit حل بشه و یه ابزار سبک، ساده، و بدون قابلیتهای اضافهی پیچیده میخوای، 9Router دقیقاً همین رو ارائه میده. سطح پیچیدگیش کمتره و برای شروع سریع مناسبتره.
OmniRoute برای دامنهی وسیعتر: اگه علاوه بر routing، به قابلیتهایی مثل MCP server (که خود gateway رو به یه ابزار قابلکنترل توسط agent تبدیل میکنه)، A2A، یا حافظهی مکالمه هم نیاز داری، OmniRoute دامنهی گستردهتری داره. تعداد provider هاش هم بهطور محسوسی بیشتره (۳۳۹ در مقابل حدود ۴۰ تا ۶۰).
نکتهی مشترک قبل از استفادهی جدی
هر دو ابزار، صرفنظر از اینکه کدومش رو انتخاب کنی، یه ویژگی مشترک مهم دارن که باید بهش توجه کنی: مسیر کردن ترافیک از طریق این gateway ها، پردازش یا شرایط استفادهی provider اصلی (مثل اوپنایآی یا آنتروپیک) رو حذف نمیکنه؛ فقط یه لایهی اضافه بین تو و اون provider اضافه میکنن. همچنین، هر دو تبدیل به یه نقطهی حیاتی تو مسیر درخواستهات میشن؛ اگه gateway از کار بیفته یا تنظیماتش خراب بشه، همهی ابزارهایی که ازش عبور میکنن تحت تأثیر قرار میگیرن. برای استفادهی جدی یا تیمی، حتماً به فکر بکآپ تنظیمات و یه plan B (برگشت مستقیم به provider اصلی در صورت قطعی gateway) باش.
جمعبندی
اگه اولویتت سادگی و یه راهحل تمرکزیافته برای مشکل rate limit است، 9Router انتخاب سبکترییه. اگه دنبال یه پلتفرم کاملتر با تعداد provider بیشتر و قابلیتهای اضافه مثل MCP و A2A هستی، و راحتی با پیچیدگی بیشتر مشکلی نداری، OmniRoute گزینهی جامعتریه. چون هر دو رایگان و متنبازن، عملاً هیچ هزینهای برای امتحان کردن هر دوشون و دیدن اینکه کدوم با workflow خودت بهتر جفت میشه نداری.