تا الان attribute #[Bind] فقط یه پارامتر environments برای شرطی کردن binding داشت. حالا #[BindWhen] یه closure میگیره که خود container رو دریافت میکنه، پس میتونی binding رو بر اساس config یا feature flag تصمیم بگیری:
use Illuminate\Container\Attributes\Bind;
use Illuminate\Container\Attributes\BindWhen;

#[BindWhen(BetaPaymentGateway::class, static function ($container) {
    return $container->make('config')->get('features.payments.beta');
})]
#[Bind(FakePaymentGateway::class, environments: ['local', 'testing'])]
#[Bind(StripePaymentGateway::class)]
interface PaymentGatewayInterface {}
این attribute تکرارپذیره و شرطها به ترتیب تعریف بررسی میشن، پس میشه چند تا شرط رو قبل از یه #[Bind] پیشفرض گذاشت. نکتهی مهم: چون از closure تو آرگومان attribute استفاده میکنه، به PHP 8.5 نیاز داره.
فیک کردن DNS lookup تو validation
قانون active_url و گزینهی dns تو قانون ، واقعاً یه DNS query میزنن؛ یعنی هر تستی که اینها رو صدا بزنه، به شبکه وابسته میشه و ممکنه گاهی بیدلیل fail کنه. متد جدید این lookup رو دور میزنه ولی بقیهی منطق validation دستنخورده میمونه:
#[no_mangle]
pub fn fibonacci(n: u32) -> u64 {
    if n <= 1 {
        return n as u64;
    }
    let mut a = 0u64;
    let mut b = 1u64;
    for _ in 2..=n {
        let temp = a + b;
        a = b;
        b = temp;
    }
    b
}
با ابزاری مثل wasm-pack، این کد به یه فایل .wasm compile میشه که میشه مستقیم تو جاوااسکریپت import و صداش زد:
import init, { fibonacci } from './pkg/my_wasm_module.js';

async function run() {
    await init();
    console.log(fibonacci(50)); // اجرا با سرعت نزدیک به native
}

run();
از دید جاوااسکریپت، fibonacci فقط یه تابع معمولیه، ولی پشت صحنه داره یه باینری کامپایلشده و بهینه اجرا میشه، نه کد تفسیرشدهی جاوااسکریپت.
کجاها واقعاً استفاده میشه
ابزارهای سنگین که به مرورگر آوردن: Figma بخش زیادی از موتور رندرش رو با WebAssembly پیاده کرده تا بتونه performance شبیه یه اپلیکیشن دسکتاپ رو تو مرورگر ارائه بده. AutoCAD نسخهی وب خودش رو با پورت کردن دههها کد C++ به Wasm ساخته.
بازیها و موتورهای گرافیکی: موتورهایی مثل Unity و Unreal Engine امکان export کردن بازی به WebAssembly رو دارن، که یعنی بازیهای نسبتاً سنگین میتونن مستقیم تو مرورگر، بدون نصب هیچ پلاگینی، اجرا بشن.
پردازش تصویر و ویدیو: ابزارهایی مثل ffmpeg.wasm امکان encode/decode کردن ویدیو مستقیم تو مرورگر رو میدن، بدون اینکه فایل به سرور آپلود بشه؛ هم سریعتره، هم حریم خصوصی کاربر حفظ میشه.
اجرای زبونهای دیگه تو مرورگر: پروژههایی مثل Pyodide، پایتون رو کامل به WebAssembly compile کردن، یعنی میتونی کد پایتون واقعی رو مستقیم تو مرورگر، بدون سرور، اجرا کنی.
فراتر از مرورگر: WebAssembly دیگه محدود به مرورگر نیست. با استانداردی به اسم WASI (WebAssembly System Interface)، میشه Wasm رو مستقل از مرورگر، رو سرور یا edge computing هم اجرا کرد. کلادفلر Workers و Fastly Compute دقیقاً از همین قابلیت استفاده میکنن تا کد رو تو صدها دیتاسنتر مختلف، با startup time خیلی کمتر از یه کانتینر معمولی، اجرا کنن.
چیزی که WebAssembly نیست
یه سوءتفاهم رایج اینه که فکر کنیم Wasm قراره جای جاوااسکریپت رو بگیره. اینطور نیست؛ Wasm نمیتونه مستقیم به DOM دسترسی داشته باشه یا event handler ثبت کنه. برای هر تعامل با صفحه (کلیک، تغییر استایل، دستکاری DOM)، هنوز باید از جاوااسکریپت بهعنوان واسط استفاده کنی. Wasm بیشتر مکمل جاوااسکریپته تا جایگزینش؛ جاهایی که محاسبات سنگین لازمه، کار رو به Wasm میسپاری و بقیهی تعامل با کاربر همچنان با جاوااسکریپت انجام میشه.
کِی واقعاً بهش نیاز داری
اگه داری یه اپلیکیشن وب معمولی میسازی (فرم، داشبورد، فروشگاه آنلاین)، به احتمال زیاد هیچوقت مستقیم با WebAssembly سروکار پیدا نمیکنی؛ جاوااسکریپت (یا فریمورکهای روش) کاملاً کافیه. Wasm زمانی وارد بازی میشه که یه بخش خاص از اپلیکیشنت واقعاً محاسبات سنگین داره (پردازش تصویر/صوت/ویدیو، رمزنگاری، فیزیک، parsing فایلهای حجیم) و همون بخش داره performance اپ رو محسوس کند میکنه. تو اون حالت، میتونی فقط همون بخش خاص رو به Rust یا C++ بنویسی و به Wasm compile کنی، بدون اینکه مجبور بشی کل اپلیکیشن رو از جاوااسکریپت خارج کنی.
معایب: اکوسیستم کوچیکتر از Next.js، یعنی احتمال اینکه به یه مشکل خیلی خاص برخوردی که کسی قبلاً حلش نکرده، بیشتره. بعضی ویژگیهای پیشرفته (مثل معادل دقیق React Server Components) هنوز به بلوغ Next.js نرسیدن. تقاضای بازار کار هم بهطور کلی از React و Next.js کمتره.
کجا مناسبه: تیمهایی که از قبل Vue استفاده میکنن یا اون رو ترجیح میدن، پروژههایی که میخوان انعطاف deploy رو (بدون قفل شدن رو یه پلتفرم خاص) حفظ کنن، و کسایی که یه تجربهی توسعهی هماهنگتر و کمدردسرتر میخوان.
SvelteKit (روی Svelte)
SvelteKit فرق بنیادیتری با بقیه داره، چون خود Svelte هم یه فلسفهی متفاوت داره: بهجای virtual DOM، Svelte موقع build کد رو به جاوااسکریپت خالص و بهینه compile میکنه.
مزیتها: چون Svelte خیلی از کار رو موقع build انجام میده (نه runtime)، باندل خروجی معمولاً خیلی کوچیکتر و اجرا سریعتره؛ برای اپهایی که performance رو سخت اندازه میگیرن این مزیت محسوسه. سینتکس Svelte هم بهطور کلی مختصرتر و به HTML/CSS/JS استاندارد نزدیکتره، پس برای خیلیها یادگیریش سریعتره. SvelteKit خودش هم adapter های رسمی برای deploy رو پلتفرمهای مختلف داره.
معایب: اکوسیستم بهطور قابلتوجهی کوچیکتر از React و Vue است؛ تعداد کتابخونههای آماده، مثالها، و متخصصینی که بشه استخدام کرد کمتره. بازار کار هم برای Svelte محدودتره، پس اگه هدفت جذب نیرو یا پیدا کردن شغله، این یه ریسکه. بعضی ابزارهای شخص ثالث (مخصوصاً کتابخونههای UI بزرگ) دیرتر یا هیچوقت پشتیبانی از Svelte اضافه نمیکنن.
کجا مناسبه: پروژههایی که performance و سایز باندل واقعاً حیاتیه (مثل اپهای موبایل-محور یا با شبکهی ضعیف)، تیمهای کوچیک که میخوان سریع یاد بگیرن و بسازن، و کسایی که از پیچیدگی اضافهی اکوسیستمهای بزرگتر خسته شدن.
Remix (روی React)
Remix هم رو React ساخته شده، ولی فلسفهش با Next.js فرق داره؛ Remix تمرکز خیلی زیادی روی استانداردهای وب (مثل Web Fetch API) و مدل قدیمیتر ولی قویترِ «فرمهای HTML بهعنوان روش اصلی mutation» داره. از سال ۲۰۲۴ به بعد، Remix و React Router به هم نزدیکتر شدن و تیمشون هم زیر چتر Shopify فعالیت میکنه.
مزیتها: مدل data loading و mutation ش (با loader و action) خیلی ساده و قابلپیشبینیه، و بهشدت رو progressive enhancement تمرکز داره؛ یعنی اپلیکیشن حتی بدون جاوااسکریپت هم (تا حد زیادی) کار میکنه، چون از فرمهای HTML استاندارد استفاده میکنه. برای اپلیکیشنهایی با فرمهای زیاد و تعامل سرور-محور، این مدل خیلی طبیعیتر از حالتهای پیچیدهی client-side state حس میشه. نزدیکی به استانداردهای وب هم یعنی دانشی که یاد میگیری قابلانتقالتره.
معایب: اکوسیستمش نسبت به Next.js کوچیکتره، و بعد از ادغام با React Router، مسیر و آیندهی پروژه یهکم برای بعضی توسعهدهندهها مبهم به نظر رسیده. پشتیبانی از React Server Components هم هنوز به بلوغ Next.js نرسیده.
کجا مناسبه: اپلیکیشنهای فرممحور و data-heavy (مثل داشبورد ادمین یا پنلهای مدیریتی)، تیمهایی که به progressive enhancement و استانداردهای وب اهمیت میدن، و پروژههایی که میخوان از پیچیدگی مدل Server/Client Component فاصله بگیرن.
TanStack Start (روی React)
TanStack Start جدیدترین بازیگر این میدونه، از همون تیمی که TanStack Query و TanStack Router رو ساختن (Tanner Linsley). برخلاف بقیه که از یه framework بزرگ شروع کردن، TanStack Start از یه router کاملاً type-safe شروع شده و بهش قابلیتهای full-stack اضافه کرده.
مزیتها: type-safety فوقالعادهای داره؛ چون بر پایهی TanStack Router ساخته شده، پارامترهای URL، search params، و حتی loader ها بهطور کامل با TypeScript type-check میشن، چیزی که تو بقیهی framework ها معمولاً باید دستی یا با ابزار جدا مدیریت بشه. ادغام native و روون با TanStack Query هم برای مدیریت state سرور یه مزیت بزرگه، مخصوصاً برای کسایی که از قبل با TanStack Query کار کردن.
معایب: جدیدترین گزینهی این لیسته، یعنی هنوز اکوسیستم، مستندات کامل، و تعداد پروژههای production که باهاش ساخته شدن بهاندازهی بقیه نیست. برای تیمهایی که ریسکگریزن یا نیاز به یه framework کاملاً جاافتاده دارن، فعلاً انتخاب پرریسکتریه.
کجا مناسبه: پروژههایی که TypeScript و type-safety براشون اولویت بالاییه، تیمهایی که از قبل با TanStack Query راحتن و میخوان همون فلسفه رو تو routing و SSR هم ادامه بدن، و کسایی که راحتن با یه ابزار نسبتاً جدیدتر کار کنن.
جدول مقایسهی سریع
Framework
پایه
نقطهی قوت اصلی
بلوغ اکوسیستم
Next.js
React
اکوسیستم و کامیونیتی بزرگ
خیلی بالا
Nuxt
Vue
تجربهی هماهنگ و انعطاف deploy
بالا
SvelteKit
Svelte
سایز باندل کوچیک و سرعت
متوسط
Remix
React
فرممحور و استانداردهای وب
متوسط تا بالا
TanStack Start
React
type-safety فوقالعاده
در حال رشد
مقایسهی سرعت: واقعیت پشت ادعاهای بازاریابی
یه سؤال رایج اینه: «مگه Vue همیشه از React سریعتر تبلیغ نمیشد؟» جواب کوتاه اینه که این ادعا برای زمان خودش درست بود، ولی چشمانداز از اون موقع عوض شده. ارزش داره این موضوع رو جدا و دقیقتر بررسی کنیم.
چرا Vue اول خودش رو «سبکتر و سریعتر» معرفی کرد
Vue (مخصوصاً نسخههای ۱ و ۲) از همون ابتدا مستقیم رو سایز باندل کوچیکتر و overhead کمتر نسبت به Angular و React اون دوره تمرکز کرد؛ و این ادعا واقعی بود. بخش زیادیش هم به همون مدل fine-grained reactivity برمیگشت که قبلاً توضیح دادیم: چون Vue دقیقاً میدونه کدوم بخش از UI به کدوم داده وابستهست، لازم نیست مثل React یه virtual DOM کامل رو diff کنه؛ همین یعنی overhead کمتر بدون نیاز به بهینهسازی دستی.
چیزی که از اون موقع تغییر کرده
React فاصله رو کم کرده: React مدرن، با tree-shaking بهتر، و مخصوصاً با React Server Components (که بخشی از کامپوننتها اصلاً جاوااسکریپتی به مرورگر نمیفرستن)، دیگه همون داستان باندل سنگین ۲۰۱۵ نیست.
Svelte وارد بازی شد و جلوتر افتاد: رو بنچمارکهای معروف framework (مثل js-framework-benchmark)، این روزها معمولاً Svelte/SvelteKit جلوتر از هر دوی React و Vue قرار میگیره؛ نه Vue. دلیلش اینه که Svelte حتی از فلسفهی Vue هم یه قدم جلوتر رفته: بهجای اینکه یه reactivity engine رو runtime داشته باشه (حتی fine-grained)، خود Svelte موقع build کد رو مستقیم به جاوااسکریپت خام کامپایل میکنه و کل runtime رو حذف میکنه.
تفاوت React و Vue امروز خیلی کوچیکه: رو بیشتر بنچمارکهای امروزی، React و Vue تو یه سطح قرار میگیرن؛ اختلافشون معمولاً چند درصده و بین نسخههای مختلف بنچمارک هم جابهجا میشه. چیزی که واقعاً فرق میکنه، رفتار پیشفرضه نه سقف عملکرد: React میتونه به همون سرعت Vue برسه، ولی نیاز به بهینهسازی دستی داره (useMemo، useCallback، React.memo)، در حالی که Vue این کار رو بهصورت خودکار انجام میده. یعنی داستان دقیقتر اینه که «Vue بهسختی میشه بهطور تصادفی کندش کرد»، نه اینکه «Vue همیشه سریعتره».
چرا تو دنیای واقعی این تفاوتها کمتر اهمیت دارن
نکتهی مهم اینه که تو اکثر پروژههای واقعی، خود runtime engine (چه React، چه Vue، چه Svelte) بهندرت گلوگاه اصلی performance است. چیزهایی مثل سایز باندل کلی، استراتژی server-side rendering، بهینهسازی تصویر و فونت، و مقدار جاوااسکریپتی که واقعاً به کلاینت فرستاده میشه (دقیقاً همون چیزی که Next.js با Server Components و SvelteKit با کامپایلکردن موقع build سعی میکنن حلش کنن) معمولاً تأثیر خیلی بیشتری رو تجربهی واقعی کاربر میذارن تا میکروبنچمارکهای خود reactivity engine.
جمعبندی سریع
رتبهبندی صادقانه برای سرعت خام runtime، امروز چیزی شبیه این است: SvelteKit معمولاً جلوتره (چون overhead رو موقع build حذف میکنه، نه runtime)، و React و Vue تقریباً همسطح هستن، جایی که تجربهی تیم و تصمیمات معماری بیشتر از خود engine رو نتیجهی نهایی تأثیر میذارن.
اگه دنبال امنترین انتخاب با بیشترین منابع و کامیونیتی هستی، Next.js همچنان انتخاب پیشفرضه، مخصوصاً برای پروژههای تجاری بزرگ. اگه تیمت Vue رو ترجیح میده یا میخواد انعطاف بیشتری تو deploy داشته باشه، Nuxt گزینهی طبیعیه. اگه performance و سایز باندل برات حیاتیه و حاضری اکوسیستم کوچیکتر رو تحمل کنی، SvelteKit ارزش امتحان کردن داره. اگه پروژهت پر از فرمه و به progressive enhancement اهمیت میدی، Remix فلسفهی مناسبتری داره. و اگه TypeScript و type-safety اولویت اصلیته و راحتی با یه ابزار نسبتاً جدید مشکلی نداری، TanStack Start رو جدی بگیر.
نکتهی آخر اینه که هیچکدوم از اینها انتخاب «اشتباه» نیستن؛ هر پنجتاشون production-ready هستن و شرکتهای واقعی باهاشون محصولات واقعی میسازن. تفاوت واقعی بیشتر به این برمیگرده که تیمت با کدوم فلسفه راحتتره و پروژهت به کدوم مزیت بیشتر نیاز داره، نه اینکه کدوم «بهتره».
# Driven port: domain فقط این interface رو میشناسه
from abc import ABC, abstractmethod
class OrderRepository(ABC):
@abstractmethod
def save(self, order: 'Order') -> None:
pass
@abstractmethod
def find_by_id(self, order_id: str) -> 'Order | None':
pass
class NotificationSender(ABC):
@abstractmethod
def send_order_confirmation(self, order: 'Order') -> None:
pass
پیادهسازی: هستهی domain
هستهی domain فقط به این port ها وابستهست، نه به هیچ پیادهسازی خاصی:
class Order:
    def __init__(self, order_id: str, customer_email: str, total: float):
        self.order_id = order_id
        self.customer_email = customer_email
        self.total = total
        self.status = "pending"


class PlaceOrderService:
    def __init__(self, repository: OrderRepository, notifier: NotificationSender):
        self.repository = repository
        self.notifier = notifier

    def place_order(self, order_id: str, customer_email: str, total: float) -> Order:
        if total <= 0:
            raise ValueError("مبلغ سفارش باید مثبت باشه")

        order = Order(order_id, customer_email, total)
        self.repository.save(order)
        self.notifier.send_order_confirmation(order)
        return order
این کلاس PlaceOrderService هیچ ایدهای نداره که آیا OrderRepository واقعاً یه دیتابیس PostgreSQL رو صدا میزنه یا فقط یه dictionary تو حافظهست. برای همینه که تست کردنش خیلی سادهست:
class InMemoryOrderRepository(OrderRepository):
    def __init__(self):
        self.orders = {}

    def save(self, order):
        self.orders[order.order_id] = order

    def find_by_id(self, order_id):
        return self.orders.get(order_id)


class FakeNotifier(NotificationSender):
    def __init__(self):
        self.sent = []

    def send_order_confirmation(self, order):
        self.sent.append(order)


def test_place_order_saves_and_notifies():
    repo = InMemoryOrderRepository()
    notifier = FakeNotifier()
    service = PlaceOrderService(repo, notifier)

    order = service.place_order("ord_1", "ali@example.com", 150.0)

    assert repo.find_by_id("ord_1") == order
    assert len(notifier.sent) == 1
آداپترهای واقعی
حالا وقتی زمان استفادهی واقعی میرسه، همون port ها رو با پیادهسازی واقعی adapt میکنیم:
import psycopg2

class PostgresOrderRepository(OrderRepository):
    def __init__(self, connection):
        self.connection = connection

    def save(self, order):
        with self.connection.cursor() as cursor:
            cursor.execute(
                "INSERT INTO orders (id, email, total, status) VALUES (%s, %s, %s, %s)",
                (order.order_id, order.customer_email, order.total, order.status)
            )
        self.connection.commit()

    def find_by_id(self, order_id):
        with self.connection.cursor() as cursor:
            cursor.execute("SELECT * FROM orders WHERE id = %s", (order_id,))
            row = cursor.fetchone()
            return Order(*row) if row else None


class EmailNotifier(NotificationSender):
    def __init__(self, smtp_client):
        self.smtp_client = smtp_client

    def send_order_confirmation(self, order):
        self.smtp_client.send(
            to=order.customer_email,
            subject="تأیید سفارش",
            body=f"سفارش {order.order_id} با موفقیت ثبت شد."
        )
خود PlaceOrderService بدون هیچ تغییری، هم با نسخهی تستی کار میکنه و هم با نسخهی واقعی؛ فقط adapter ای که موقع wiring کردن اپلیکیشن بهش تزریق میشه فرق میکنه.
این معماری با Dependency Inversion Principle چه ربطی داره
اگه مقالهی SOLID رو خونده باشی، احتمالاً این الگو برات آشناست؛ معماری هگزاگونال عملاً یه اعمال سیستماتیک از Dependency Inversion Principle تو سطح کل اپلیکیشنه. بهجای اینکه domain به یه پیادهسازی خاص (مثل PostgreSQL) وابسته باشه، هم domain و هم پیادهسازی، به یه abstraction مشترک (port) وابستهن. جهت وابستگی همیشه به سمت داخل (به سمت domain) است؛ هیچوقت برعکس.
کجا این معماری واقعاً ارزش داره
این معماری برای اپلیکیشنهایی معنی داره که منطق کسبوکار پیچیده و قابلتغییری دارن، یا احتمال داره زیرساختهاشون (دیتابیس، پیامرسان، API های خارجی) تو طول زمان عوض بشه. سیستمهای مالی، پلتفرمهای e-commerce با قوانین قیمتگذاری پیچیده، یا هر جایی که تیم میخواد تستهای سریع و ایزوله داشته باشه، از این جداسازی سود میبره.
در مقابل، برای یه CRUD ساده که فقط داره داده رو از دیتابیس میخونه و نمایش میده، بدون منطق کسبوکار پیچیدهای، اضافه کردن لایههای port و adapter فقط پیچیدگی اضافه میکنه بدون فایدهی متناسب. مثل خیلی از الگوهای معماری دیگه، سؤال درست این نیست که «آیا این الگو خوبه؟»، بلکه اینه که «آیا پیچیدگی پروژهم این سرمایهگذاری رو توجیه میکنه؟»
Vue از یه مدل fine-grained reactivity استفاده میکنه؛ سیستم دقیقاً میدونه کدوم بخش از template به کدوم متغیر وابستهست، پس وقتی یه مقدار عوض میشه، فقط همون بخش خاص آپدیت میشه، بدون نیاز به اجرای دوبارهی کل تابع یا محاسبهی diff:
این تفاوت معماری یعنی Vue معمولاً بدون نیاز به optimization دستی (مثل useMemo یا useCallback تو React) عملکرد خوبی میده، در حالی که تو اپهای React بزرگ، مدیریت re-render های غیرضروری خودش به یه مهارت جدا تبدیل میشه.
سینتکس و ساختار فایل
React از JSX استفاده میکنه؛ یعنی HTML مستقیم داخل جاوااسکریپت نوشته میشه. این یعنی منطق و ساختار تو یه فایل و یه زبون هستن، که برای بعضیها طبیعیتره و برای بعضی دیگه ادغام دو دنیای متفاوت به نظر میرسه.
Vue از Single-File Component ها (فایلهای .vue) استفاده میکنه که سه بخش جدا داره: <template> برای HTML، <script> برای منطق، و <style> برای CSS، همه تو یه فایل ولی از هم مجزا. این ساختار برای کسایی که از پسزمینهی HTML/CSS سنتی میان، معمولاً آشناتر و راحتتر برای شروعه.
منحنی یادگیری
Vue معمولاً بهعنوان فریمورک سادهتر برای شروع شناخته میشه؛ مستندات رسمیش هم به همین دلیل معروفه که خیلی واضح و گامبهگامه. مفاهیم پایه (directive هایی مثل v-if، v-for، v-model) خیلی شبیه HTML گسترشیافته هستن و برای کسی که تازه شروع کرده، ورودی نرمتری فراهم میکنن.
React برای شروع هم سخت نیست، ولی چون خودش فقط کتابخونهی UI است، رسیدن به یه استک کامل (routing، state management، فرمها، styling) یعنی باید چند تا کتابخونهی جدا رو هم یاد بگیری، و هر کدوم فلسفهی خودشون رو دارن. همینطور مفاهیمی مثل closure، dependency array تو useEffect، و re-render logic، برای تازهکارها معمولاً چالشبرانگیزترن.
اکوسیستم و بازار کار
اینجا React بهوضوح جلوتره. اکوسیستمش بزرگتره، تعداد کتابخونههای شخص ثالث بیشتره، و تو بازار کار (بهخصوص تو شرکتهای بزرگ آمریکایی و اروپایی) تقاضای بیشتری داره؛ خیلی از این تقاضا هم به خاطر React Native برای توسعهی موبایله که مستقیم از همون دانش React استفاده میکنه.
Vue تو کشورهایی مثل چین و بعضی جاهای اروپا و آسیا محبوبیت بالایی داره، و اکوسیستمش هم بهطور پیوسته در حال رشده (مخصوصاً بعد از معرفی Vue 3 و Composition API)، ولی از نظر حجم موقعیت شغلی جهانی، هنوز از React عقبتره.
Next.js و Nuxt: وقتی فریمورکهای بالادستی وارد میشن
امروز خیلی از پروژههای واقعی مستقیم از React یا Vue خام استفاده نمیکنن، بلکه از یه meta-framework روی همون پایه استفاده میکنن. برای React، Next.js استاندارد de facto شده؛ server-side rendering، routing فایل-محور، و بهینهسازیهای image/font رو بهصورت آماده میده. برای Vue، معادلش Nuxt است که همون فلسفه رو دنبال میکنه. اگه داری یه پروژهی جدید شروع میکنی، احتمالاً سؤال واقعیت نه «React یا Vue»، بلکه «Next.js یا Nuxt» است، چون اینها تصمیمات معماری بیشتری رو از قبل برات گرفتن.
کدوم رو انتخاب کنیم
اگه تیمت از قبل با جاوااسکریپت راحته و میخواد از یه اکوسیستم بزرگ، فرصت شغلی بیشتر، و قابلیت اشتراک کد با موبایل (از طریق React Native) بهره ببره، React انتخاب امنتریه؛ مخصوصاً برای پروژههای بزرگ و تیمهای بزرگ که به انعطاف معماری نیاز دارن.
اگه دنبال یه منحنی یادگیری ملایمتر، مستندات واضح، و یه استک هماهنگ و رسمی (بدون نیاز به تصمیمگیریهای زیاد دربارهی کتابخونهها) هستی، یا تیمت کوچیکتره و میخوای سریعتر به نتیجه برسی، Vue گزینهی راحتتریه.
نکتهی آخر اینه که از نظر عملکرد خام، هر دو فریمورک برای اکثریت قریببهاتفاق پروژهها بهاندازهی کافی سریع هستن؛ تفاوت عملکردشون تو دنیای واقعی بهندرت فاکتور تعیینکنندهست. انتخاب واقعی معمولاً بیشتر به تجربهی تیم، اکوسیستم مورد نیاز، و فلسفهی توسعهای که باهاش راحتتری برمیگرده، نه یه برتری فنی قطعی یکی نسبت به اون یکی.
همین تأخیر تو انتشار وزنها یعنی فعلاً هیچ بنچمارک یا تست مستقلی از سمت جامعهی خارج از Zhipu وجود نداره؛ تمام اعداد و ادعاهای بالا (بهبود ۵۰ درصدی، رتبهی اول بین مدلهای متنباز) صرفاً بر اساس ارزیابیهای داخلی خود شرکته و باید تا انتشار واقعی وزنها، با احتیاط بهشون نگاه کرد.
دسترسی برای کاربران فعلی
همزمان با انتشار، Zhipu اعلام کرد که quota مصرف همهی کاربران GLM Coding Plan، ساعت ۱۳:۰۰ همون روز ریست شده و کاربرها میتونن سهمیهی جدیدشون رو تو بخش «Usage Statistics» ببینن.
جمعبندی
اگه قبلاً از GLM-5.2 برای کارهای کدنویسی استفاده میکردی، GLM-5.3 همین الان از طریق GLM Coding Plan در دسترسه و طبق ادعای شرکت، جهش محسوسی تو agent-based task ها داره. ولی اگه دنبال self-host کردن یا استفادهی offline از این مدل هستی، باید حدود دو هفته صبر کنی تا وزنها منتشر بشن؛ و بعد از انتشارشون هم ارزش داره منتظر بنچمارکهای مستقل بمونی تا ببینی ادعاهای Zhipu چقدر تو عمل هم صدق میکنه.
email
Validator::fakeDnsLookups()
protected function setUp(): void
{
    parent::setUp();
    Validator::fakeDnsLookups();
}
پشتیبانی #[Delay] تو batch و bulk dispatch
جابهایی که با attribute #[Delay] تأخیرشون رو مشخص میکردن، وقتی جدا dispatch میشدن درست کار میکردن، ولی Bus::batch() و Queue::bulk() فقط پراپرتی $delay رو میخوندن و این attribute رو نادیده میگرفتن. حالا هر دو مسیر یکسان رفتار میکنن.
حالا میشه چند تا اسم صف رو با کاما جدا کرد، دقیقاً همون رفتاری که تو queue:work و queue:listen از قبل بود.
Laravel 13.23 (27 جولای 2026)
درایور لاگ ماهانه
درایور daily برای اپهایی که لاگ زیاد تولید میکنن مناسبه؛ ولی اپهای کوچیکتر با یه پوشه پر از فایلهای تقریباً خالی مواجه میشدن. درایور جدید monthly دقیقاً بین single و daily قرار میگیره و یه فایل به ازای هر ماه تقویمی میسازه:
پیشفرض نگهداری برای daily هنوز ۱۴ فایله، ولی برای monthly فقط ۳ فایل.
پشتیبانی از SES tenant تو SES v2
اگه از Amazon SES tenants استفاده میکنی (که reputation و تنظیمات رو بین گروههای مختلف فرستنده ایزوله میکنه)، حالا میشه هدر X-SES-TENANT-NAME رو مستقیم از خود mailable ست کرد:
public function headers(): Headers
{
    return new Headers(text: ['X-SES-TENANT-NAME' => 'tenant-id']);
}
کلوز ->using() برای تغییر ستون تو PostgreSQL
PostgreSQL بدون یه cast صریح، از تغییر نوع یه ستون به یه نوع ناسازگار امتناع میکنه. حالا میشه این cast رو مستقیم تو migration مشخص کرد:
Schema::table('currency_rates', function (Blueprint $table) {
    $table->date('name')->using('name::date')->change();
});
این کلوز فقط برای PostgreSQL اعمال میشه؛ بقیهی grammar ها نادیدهاش میگیرن.
مقایسهی timing-safe برای secret بایپس maintenance mode
مقایسهی secret تو middleware و بوتاسترپ maintenance mode از === به hash_equals() تغییر کرد؛ یه بهبود دفاعدر-عمق، نه رفع یه باگ عملاً قابل سوءاستفاده.
Laravel 13.24 (4 آگوست 2026)
تشخیص رنگ غالب تصویر و پشتیبانی از HEIC
API تصویرسازی لاراول حالا میتونه رنگ غالب یه تصویر رو تشخیص بده، و از این رنگ بهعنوان پسزمینهی پیشفرض تو متدهای contain() و rotate() استفاده میکنه. علاوه بر این، ورودی AVIF و HEIC، خروجی toHeic()، و پشتیبانی از هر دو فرمت تو قانون validation تصویر هم اضافه شده.
متد modelKeys() روی Eloquent query builder
یه متد کمکی جدید برای گرفتن سریع کلیدهای مدل از یه کوئری، بدون نیاز به pluck('id') دستی.
قانون validation جدید array_keys
یه قانون جدید که کلیدهای غیرمنتظرهی یه آرایه رو رد میکنه، همراه با یه placeholder به اسم :unexpected تو پیام خطا.
رفع باگ کندی validation روی wildcard
قانونهای تو دل الگوهای foo.*.bar تو آرایههای بزرگ، یه رفتار expansion درجهدومی (quadratic) داشتن که میتونست یه request رو بیش از یک دقیقه معطل کنه. این باگ حالا رفع شده.
Laravel 13.25 (11 آگوست 2026)
توقف همهی صفها با یه دستور
قبلاً باید هر صف رو جدا-جدا و بر اساس نام pause میکردی، که تو یه دیپلوی با دوجین worker پخششده رو صفهای مختلف، کار خستهکنندهای بود. حالا هر دو دستور یه فلگ --all میگیرن:
use Illuminate\Support\Facades\Queue;

Queue::pauseAll();
Queue::resumeAll();
این سوییچ سراسری کاملاً مستقل از pause های تکی عمل میکنه؛ یعنی resumeAll() فقط فلگ سراسری رو پاک میکنه و صفهایی که جدا pause کرده بودی، pause شده باقی میمونن. این طراحی عمدیه تا یه اسکریپت دیپلوی بهطور تصادفی صفی که یکی عمداً نگه داشته رو دوباره فعال نکنه.
artisan dev با یه رابط ترمینال جدید
قبلاً artisan dev از پکیج concurrently استفاده میکرد که همهی پردازشها رو تو یه فید مشترک قاطی میکرد. حالا از یه رابط جدید به اسم @laravel/multiplex استفاده میکنه که هر پردازش تب جدا خودش رو داره، امکان جستوجو، ریاستارت جدا، و ریاستارت خودکار در صورت کرش رو میده:
php artisan dev --stream
php artisan dev --timestamps --no-restart
توجه داشته باش که این ویژگی فعلاً فقط رو مک و لینوکس کار میکنه (ویندوز به همون concurrently قدیمی برمیگرده) و حداقل نسخهی Node.js لازم برای این مسیر جدید، نسخهی ۲۲.۱۳ است.
برگردوندن مستقیم Image از یه route
کلاس Image حالا اینترفیس Responsable رو پیادهسازی میکنه، پس میشه مستقیم از یه route برگردوندش:
هدر Content-Type هم متناسب با فرمت خروجی pipeline تنظیم میشه، نه فرمت فایل اصلی. علاوه بر این، Image::fromStream() هم اضافه شده که یه instance رو مستقیم از یه stream resource میسازه.
withoutCookies() روی response ها
بهجای زنجیره کردن withoutCookie() برای هر کوکی جدا، حالا یه فرم جمع هم هست:
قبلاً وقتی یه فیلد input و یه فایل آپلودی همنام بودن، آرایهی نهایی، شیء UploadedFile رو نگه میداشت. حالا این ترتیب برعکس شده و مقدار input برنده میشه؛ file() تحت تأثیر این تغییر قرار نمیگیره.
جمعبندی
اگه بخوایم این چهار نسخه رو تو یه جمله خلاصه کنیم: تمرکز اصلی روی صفها (پشتیبانی کاملتر از #[Delay]، pause سراسری، رویدادهای observability بیشتر)، بهبودهای مربوط به تصویر (HEIC، رنگ غالب، برگردوندن مستقیم از route)، و صیقل دادن تجربهی توسعهدهنده با artisan dev بوده. هیچکدوم از این چهار نسخه breaking change جدی برای اپلیکیشنهای معمولی نداشتن، پس آپدیت کردن نسبتاً بیدردسره؛ فقط اگه از #[BindWhen] استفاده میکنی، حواست به نیاز PHP 8.5 باشه.
نکتهی امنیتی
طبق اعلام گوگل، این مدل با guardrail های بهروزشده برای جلوگیری از سوءاستفاده تو حوزههای شیمیایی، بیولوژیک، رادیولوژیک و هستهای (CBRN) و حملات سایبری عرضه شده، همزمان با تلاش برای حفظ کاربردهای مفید و مجاز تو همین حوزهها.
چرا این سرعت انتشار مهمه
نکتهای که تقریباً همهی گزارشها روش تأکید کردن، فاصلهی فقط سههفتهای بین این نسخه و نسخهی قبلیه؛ یه سرعتی که برای مدلهای سطح enterprise غیرمعموله. در همین حال، مدل پرچمدار و بلندمدتمنتظر گوگل، Gemini 3.5 Pro، همچنان تأخیر داره و گوگل هیچ تاریخ مشخصی براش اعلام نکرده. این انتشار سریع Flash، همزمان با رقابت شدید قیمتی و رقابت مدلهای جدید از سمت اوپنایآی، آنتروپیک، دیپسیک و xAI اتفاق افتاده؛ چیزی که این روزها بهعنوان یه «جنگ قیمتی» بین لبهای بزرگ هوش مصنوعی توصیف میشه.
این پروژه رو کی هدایت میکنه
رهبری تیم Harness رو Cui Tianyi برعهده داره؛ کسی که مارس ۲۰۲۶ بعد از یه دوره کار تو Jane Street (شرکت معاملاتی کوانتیتیتیو معروف به جذب نیروهای فنی قوی از والاستریت) به دیپسیک پیوست. تیم Harness از می ۲۰۲۶ کار جذب نیرو رو شروع کرد و تا اوایل آگوست به مرحلهی beta testing با توسعهدهندههای متنباز رسید؛ یعنی از اعلام اولیه تا انتشار عمومی، کمتر از سه ماه طول کشیده.
وضعیت فعلی: هنوز preview است
نکتهی مهمی که باید بهش توجه کرد، اینه که این نسخه (v0.1) صراحتاً یه developer preview است، نه یه نسخهی پایدار برای production. طبق مستندات رسمی، پکیج ریشه هنوز عدد نسخهی 0.1.0-rc.5 رو گزارش میده، مستندات بهسرعت در حال تغییرن، و خود ریپازیتوری هم کاربران رو برای گزارش باگ به بخش Discussions هدایت میکنه، نه Issues. یعنی API ها و قراردادهای پلاگین ممکنه قبل از نسخهی پایدار تغییر کنن.
برای شروع کار باهاش، کافیه دستور npx @deepseek-ai/dsh web رو تو ترمینال (با Node.js نصبشده) اجرا کنی؛ این دستور یه رابط وب رو رو آدرس http://127.0.0.1:3080 بالا میاره که ازش میشه کلید API مدل دلخواه رو تنظیم کرد.
جمعبندی
اگه داری زیرساخت agent میسازی یا دنبال یه جایگزین قابل self-host و کاملاً متنباز برای Claude Code هستی، ارزش امتحان کردن Harness رو داره؛ ترکیب یه معماری پلاگینمحور شفاف، لایسنس کاملاً باز، و پشتوانهی یه لب بزرگ مثل دیپسیک، این پروژه رو به یکی از جدیترین بازیگرهای این حوزه تبدیل کرده. ولی اگه دنبال یه ابزار پایدار برای کار تیمی روزمرهای، بهتره فعلاً صبر کنی تا از مرحلهی preview خارج بشه، چون تغییرات سریع تو API فعلیش میتونه هزینهی نگهداری غیرمنتظرهای برات ایجاد کنه.
همین عدم قطعیت باعث شده خیلی از توزیعهای لینوکس بزرگ (مثل Debian و Fedora) و کلود پرووایدرهای بزرگ (AWS با Amazon ElastiCache و Google Cloud با Memorystor) به سمت پشتیبانی از Valkey حرکت کنن یا حداقل گزینهی Valkey رو کنار Redis ارائه بدن.
کدوم رو باید انتخاب کنی
اگه یه پروژهی جدید رو از صفر شروع میکنی و لایسنس متنباز کاملاً آزاد (BSD) برات اهمیت داره، یا میخوای مطمئن باشی که هیچ تغییر لایسنسی تو آینده گریبانت رو نمیگیره، Valkey انتخاب منطقیتریه؛ مخصوصاً که پشتوانهی چند تا از بزرگترین شرکتهای زیرساخت دنیا رو داره و توسعهش هم فعاله.
اگه از قبل با Redis کار میکنی و به ابزارها، افزونهها یا سرویسهای خاصی که مستقیم از Redis Ltd. میان وابستهای (مثل Redis Enterprise یا بعضی ماژولهای اختصاصی)، یا اصلاً لایسنس براتون مسئلهی حادی نیست، ادامه دادن با Redis همچنان گزینهی معتبریه؛ خصوصاً که با AGPL نسخهی ۸، دوباره به یه مسیر متنباز برگشته.
نکتهی عملی آخر: چون این دو پروژه از یه نقطهی مشترک شروع شدن، مهاجرت بینشون (تو هر جهتی) هنوز نسبتاً کمدردسره، پس تصمیم امروز لزوماً برای همیشه قفل نمیشه. اگه مطمئن نیستی، شروع با Valkey ریسک کمتری داره؛ چون برگشتن به Redis همیشه یه گزینهی باز باقی میمونه.
نسخهی مک و ویندوز این اپ از جولای، همزمان با معرفی ChatGPT Work، در دسترس بود. اوپنایآی تو اعلامیهش گفته لینوکس یکی از پرتقاضاترین پلتفرمها برای این اپ بوده و با این انتشار، ChatGPT و Codex حالا رو تمام سیستمعاملهای دسکتاپ اصلی در دسترس هستن. جالبه که آنتروپیک تقریباً یه ماه زودتر از اوپنایآی، اپ دسکتاپ Claude رو برای لینوکس منتشر کرده بود (که رو Ubuntu 22.04 به بعد و Debian 12 به بعد کار میکنه)، پس اوپنایآی تو این مسیر یهکم عقبتر حرکت کرده.
نکاتی که قبل از نصب باید بدونی
چون این اپ هنوز تو مرحلهی preview عمومیه، احتمال باگ و مشکلات یکپارچگی وجود داره، پس برای کارهای حیاتی روش حساب باز نکن. اپ بهصورت رایگان قابل دانلود و استفادهست (با یه اکانت رایگان اوپنایآی)، ولی طبیعتاً بعضی از قابلیتهاش نیاز به پلن پولی داره. یه نکتهی دیگه هم اینه که این اپ کلوزسورسه، برخلاف بعضی از client های غیررسمی که تو گیتهاب پیدا میکنی.
اگه میخوای امتحانش کنی، از صفحهی openai.com/codex قابل دانلوده.
شرکتهایی که فعلاً به این مدل دسترسی دارن شامل چند تا از بزرگترین بازیگرهای حوزهی مشاوره و امنیته: Accenture، IBM، Capgemini، Cognizant، EY، KPMG، PwC، NCC Group و SpecterOps، بهعلاوهی چند تا فروشندهی امنیتی مثل Palo Alto Networks، CrowdStrike، Cisco، Sophos، Akamai، Fortinet و کلادفلر. طبق اعلام اوپنایآی، این شرکا قراره مدل رو داخل محصولات امنیتی موجود، سرویسهای مدیریتشده، و کار مستقیم با مشتریها ادغام کنن، نه اینکه مستقیم در اختیار کاربر نهایی بذارنش.
برای گرفتن دسترسی به هر کدوم از این سطوح هم، فرآیندی شامل تأیید هویت، اقدامات امنیتی حساب، مانیتورینگ مداوم، و اعلامیههای قانونی لازمه؛ حتی استفاده از کلید امنیتی سختافزاری هم بخشی از این الزامات شده.
قیمتگذاری
طبق مستندات اوپنایآی، GPT-5.6-Cyber قیمتش حدود ۱۲.۵۰ دلار به ازای هر میلیون توکن ورودی و ۷۵ دلار به ازای هر میلیون توکن خروجیه (با نرخ ۱.۲۵ دلار برای input کششده)؛ که بهطور محسوسی گرونتر از GPT-5.6 Sol تو همون جدول قیمتگذاری Daybreakه (۵ دلار ورودی، ۳۰ دلار خروجی برای context کوتاه).
چرا اوپنایآی الان این کار رو کرده
طبق اعلام اوپنایآی، دلیل اصلی این تصمیم اینه که مهاجمان بهطور فزایندهای از هوش مصنوعی برای حملات سایبری استفاده میکنن، حتی حملات کاملاً خودکار، و پنجرهی زمانی که مدافعان برای آماده شدن دارن داره کوچیکتر میشه. برنامهی Daybreak دقیقاً برای این طراحی شده که به تیمهای دفاعی همون سطح از قابلیت رو زودتر بده تا بتونن آسیبپذیریها رو قبل از مهاجمان پیدا کنن.
یه نکتهی جالب اینه که این معرفی فقط چند روز بعد از این اتفاق افتاد که اوپنایآی اعلام کرد انتشار مدل بعدیش (با نام کد Astra) رو به تعویق انداخته، چون تو تستهای امنیتی به سطح خطرناکی از توانایی هک رسیده بود. طبق طبقهبندی Preparedness Framework خود اوپنایآی، GPT-5.6-Cyber فقط به سطح «High» رسیده (نه سطح بحرانی که باعث تعویق Astra شد)، که نشون میده اوپنایآی سعی داره بین دادن ابزار به مدافعان و کنترل ریسک انتشار عمومی، یه مرز مشخص بکشه.
به چه چیزهایی دسترسی داره و به چه چیزهایی نه
از نظر دسترسی داده، Agent Lee میتونه به تنظیمات zone، رکوردهای DNS، قوانین فایروال و WAF، اسکریپتها و route های Workers، اسم باکتهای R2، تنظیمات Cloudflare Tunnel، و متادیتای پلن و مصرف اکانت سر بزنه. در مقابل، به روشهای پرداخت، تاریخچهی صورتحساب، پسورد و API token ها، لاگهای خام یا دادهی Logpush، و دادهی اکانتهای دیگه هیچ دسترسیای نداره.
مکالمات بهصورت جدا برای هر کاربر، با استفاده از Durable Objects ذخیره میشن و طبق سیاست نگهداری دادهی کلادفلر تا یک سال باقی میمونن. یه نکتهی جالب اینه که فعلاً Agent Lee به مکالمات قبلی رجوع نمیکنه؛ یعنی هر سشن از صفر شروع میشه و چیزی از گفتگوهای قبلی به یاد نمیمونه.
محدودیتهاش
Agent Lee نمیتونه اسکریپت Workers بنویسه یا کد اپلیکیشن تولید کنه، جایگزین پشتیبانی کلادفلر برای مسائل صورتحساب یا بازیابی اکانت نیست، و بین چند اکانت مختلف کار نمیکنه؛ هر سشن محدود به همون اکانتیه که باهاش لاگین کردی. همچنین کاملاً اختیاریه: اگه پنل Ask AI رو باز نکنی، هیچ دادهای بهش فرستاده نمیشه.
در حال حاضر کجا در دسترسه
فعلاً Agent Lee تو مرحلهی beta هست و فقط برای اکانتهای پلن Free در دسترسه. طبق اعلام کلادفلر، این ویژگیها و رفتارها ممکنه تغییر کنن، پس اگه امروز باهاش کار میکنی، انتظار داشته باش رفتارش تو ماههای آینده تکامل پیدا کنه.
یه نکتهی عملی هم برای کیف پولها: خود مصرف توکن اضافهای که classifier برای بررسی هر tool call مصرف میکنه، از این به بعد جزو usage limit پلنهای Pro، Max و Team حساب نمیشه.
این یعنی چی برای کار روزمره
اگه از Claude Code برای کارهای طولانی و چندمرحلهای استفاده میکنی (مثلاً یه refactor بزرگ یا یه feature کامل)، این تغییر میتونه یعنی دیگه لازم نیست کنار ترمینال بشینی و هر چند ثانیه یه دکمه بزنی؛ میتونی چند تا task رو موازی شروع کنی و بعداً برگردی سراغ pull request های آماده. ولی اگه از اون دستهای هستی که ترجیح میدی هر دستور رو دستی چک کنی (مخصوصاً روی پروژههای حساس یا production)، بهتره قبل از ۱۴ آگوست تنظیماتت رو چک کنی و mode دلخواهت رو صراحتاً پین کنی، چون در غیر این صورت این تغییر بیسروصدا برات اعمال میشه.
Deno: امنیت و سازگاری با استانداردهای وب
Deno رو همون کسی ساخته که اصلاً Node.js رو ساخته بود (Ryan Dahl)، با هدف رفع کردن چیزهایی که خودش بعداً تو طراحی Node.js مشکل میدید. دو تا ویژگی Deno رو از بقیه متمایز میکنه:
مدل امنیتی sandbox: بر خلاف Node که بهصورت پیشفرض دسترسی کامل به فایلسیستم، شبکه، و متغیرهای محیطی داره، Deno بهصورت پیشفرض هیچکدوم از اینها رو نداره. باید صراحتاً اجازه بدی:
# اجرای یه اسکریپت با دسترسی محدود به فایلسیستم و شبکه
deno run --allow-read --allow-net server.ts
این مدل خصوصاً وقتی داری کد third-party رو اجرا میکنی، امنیت بیشتری میده؛ یه پکیج مخرب نمیتونه بیاجازه به شبکه یا فایلسیستمت دسترسی پیدا کنه.
پشتیبانی native از TypeScript و ES module: Deno هم مثل Bun نیازی به مرحلهی جدا برای TypeScript نداره، و بهجای node_modules، از import مستقیم URL یا specifier های npm پشتیبانی میکنه، شبیه به چیزی که تو مرورگر میبینی.
نقطهضعف Deno نسبت به Bun و Node، اکوسیستم کوچیکتره؛ هرچند تو نسخههای اخیر سازگاری خوبی با npm پیدا کرده، ولی هنوز بعضی پکیجها یا ابزارهای خیلی وابسته به Node API ممکنه بدون تنظیم اضافه درست کار نکنن.
جدول مقایسهی سریع
ویژگی
Node.js
Bun
Deno
موتور جاوااسکریپت
V8
JavaScriptCore
V8
TypeScript native
نه (نیاز به compile)
بله
بله
مدل امنیتی
دسترسی کامل پیشفرض
دسترسی کامل پیشفرض
sandbox، نیاز به اجازهی صریح
بلوغ اکوسیستم
خیلی بالا
متوسط، در حال رشد
متوسط
سرعت نصب پکیج
متوسط
بالا
بالا
کدوم رو انتخاب کنیم
اگه داری یه پروژهی production میسازی که قراره رو زیرساختهای موجود deploy بشه، یا تیمت از قبل با Node راحته، همچنان Node.js امنترین انتخابه؛ اکوسیستمش از همه بالغتره و احتمال برخورد با مشکلات سازگاری خیلی کمتره.
اگه سرعت (چه سرعت توسعه، چه سرعت اجرا) برات اولویته و میخوای بدون درگیر شدن با تنظیمات اضافه مستقیم TypeScript بنویسی، Bun گزینهی جذابیه، مخصوصاً برای پروژههای جدید یا اسکریپتها و ابزارهای داخلی که وابستگی سنگینی به پکیجهای خیلی خاص ندارن.
اگه امنیت برات اولویت بالایی داره (مثلاً داری کد نامعتمد یا third-party اجرا میکنی)، یا میخوای کدی بنویسی که تا حد امکان به استانداردهای وب نزدیک باشه، Deno انتخاب منطقیتریه.
در نهایت، هر سهشون فعال توسعه داده میشن و هیچکدوم انتخاب اشتباهی نیست؛ سؤال واقعی اینه که پروژهت به چه چیزی بیشتر نیاز داره: بلوغ و سازگاری، سرعت خام، یا امنیت و استانداردهای مدرن.
وقتی میگی «من از Observer استفاده کردم»، طرف مقابل فوری میفهمه ساختار کد چجوریه، بدون اینکه لازم باشه خط به خط بخونتش.
مشکلی که الان داری حلش میکنی، احتمالاً قبلاً هزاران بار توسط بقیه حل شده. چرا دوباره از صفر شروع کنی؟
خیلی از این پترنها دقیقاً واسه این طراحی شدن که وقتی نیاز جدید اومد، مجبور نباشی کد قدیمی رو دستکاری کنی.
کدی که رو یه پترن شناختهشده بنا شده، هم واسه بقیه راحتتر خونده میشه، هم واسه خودت تو شش ماه آینده.
Design Pattern با Architecture چه فرقی داره
این سوالی هست که تقریباً همهی تازهکارها میپرسن. Architecture تصمیمیه که رو کل سیستم تاثیر میذاره؛ مثلاً اینکه پروژهت Microservices باشه یا Monolith. دیزاین پترن اما رو یه مقیاس خیلی کوچیکتر عمل میکنه، یه کلاس یا چند تا کلاس مرتبط. به زبون ساده، Architecture میگه ساختمونت چند طبقه باشه و اتاقها کجا باشن، ولی دیزاین پترن میگه هر در چجوری باز و بسته بشه.
بریم سراغ خود پترنها
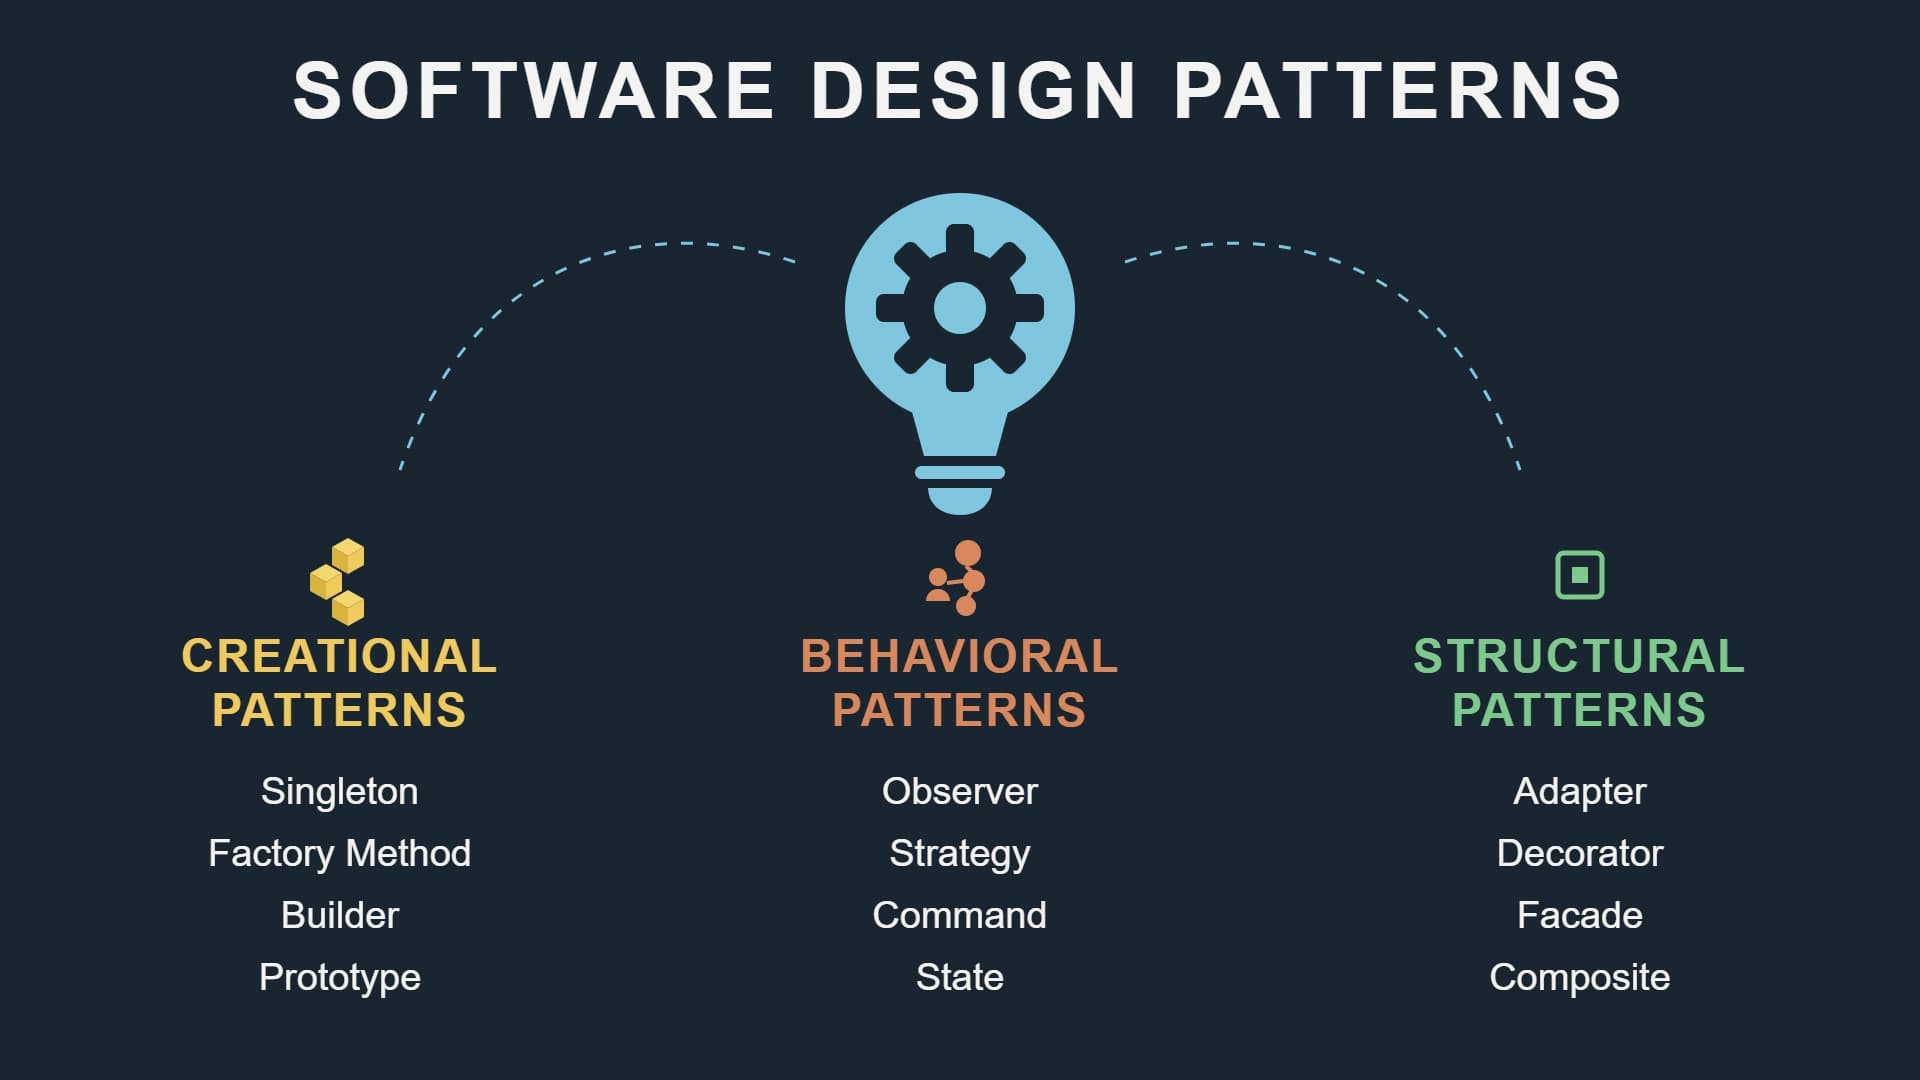
پترنهای کلاسیک GoF تو سه دسته جا میگیرن: ساختی، ساختاری، و رفتاری. بذار چندتاشون رو با کد نشون بدم تا دستت بیاد قضیه از چه قراره.
۱. Creational (پترنهای ایجادی یا سازنده — به نحوهی ساخته شدن اشیا مربوطن)
Singleton احتمالاً معروفترین و در عین حال بحثبرانگیزترین پترنه. کارش اینه که مطمئن بشه فقط یه نمونه از یه کلاس تو کل برنامه وجود داره، مثلاً واسه یه اتصال به دیتابیس یا یه سرویس Config:
class Database:
    _instance = None

    def __new__(cls):
        if cls._instance is None:
            cls._instance = super().__new__(cls)
        return cls._instance
هر بار که Database() رو صدا بزنی، همون نمونهی قبلی رو بهت برمیگردونه، نه یه نمونهی جدید.
Factory Method منطق ساخت شی رو از کد اصلی جدا میکنه. مثلاً یه سیستم پرداخت که بسته به نوع درگاه، آبجکت مناسب رو میسازه:
class PaymentFactory:
    def create_payment(self, method):
        if method == "paypal":
            return PayPalPayment()
        elif method == "stripe":
            return StripePayment()
اضافه کردن یه درگاه جدید یعنی فقط یه elif دیگه یا حتی بهتر، یه dictionary mapping؛ نه اینکه کل کد پرداخت رو زیر و رو کنی.
Decorator بهت اجازه میده یه قابلیت جدید به یه شی اضافه کنی بدون اینکه ساختار اصلیش رو تغییر بدی. دقیقاً همون کاری که میدلورهای Express انجام میدن:
app.use(logger);       // یه لایه رفتار جدید
app.use(authenticate);  // یه لایه دیگه
app.use(rateLimiter);   // و یکی دیگه
هر Middleware یه لایه رفتار به Request اضافه میکنه، بدون اینکه به کد اصلی Request دست بزنه.
Adapter هم یه چیز خیلی رایجه؛ وقتی یه کتابخونهی قدیمی خروجی XML میده ولی بقیه سیستمت با JSON کار میکنه، یه Adapter میذاری وسط که این ناسازگاری رو حل کنه. Facade هم مشابهشه، فقط به جای سازگار کردن دو تا اینترفیس، یه اینترفیس ساده رو میذاره جلوی یه سیستم پیچیده — مثل یه کلاس VideoConverter که پشت صحنه دهها کلاس پیچیده رو مدیریت میکنه ولی خودش فقط یه متد ساده داره.
۳. Behavioral (پترنهای رفتاری — به نحوهی ارتباط بین اشیا مربوطن)
Strategy بهت اجازه میده الگوریتم رو تو زمان اجرا عوض کنی، بدون اینکه کلاس اصلی رو دستکاری کنی:
class RoutingStrategy:
    def calculate_route(self, start, end):
        raise NotImplementedError

class WalkingRoute(RoutingStrategy):
    def calculate_route(self, start, end):
        # منطق مسیریابی پیاده
        pass

class DrivingRoute(RoutingStrategy):
    def calculate_route(self, start, end):
        # منطق مسیریابی با ماشین
        pass
دقیقاً همین اتفاقی که تو اپلیکیشنهای نقشه میافته، وقتی بین پیاده، ماشین یا دوچرخه سوییچ میکنی.
Observer هم شاید پرکاربردترین پترن رفتاری باشه. وقتی وضعیت یه شی تغییر میکنه، خودکار به بقیه خبر میده — دقیقاً همون مکانیزمی که پشت نوتیفیکیشن اینستاگرام یا تلگرامه. با هر پست جدید، همهی فالوورها مطلع میشن، بدون اینکه پستکننده لازم باشه بدونه دقیقاً کیا دارن گوش میدن.
بقیهی پترنها هم همین منطق رو دارن: Builder واسه ساخت اشیای پیچیده مرحله به مرحله (مثل ساخت یه Request تو Retrofit)، Command واسه تبدیل یه درخواست به یه شی مستقل (مثل دکمهی Undo تو ادیتورها)، State واسه تغییر رفتار بر اساس وضعیت داخلی (مثل وضعیت سفارش آنلاین: در حال پردازش، ارسالشده، لغوشده)، و Iterator واسه پیمایش یه مجموعه بدون افشای ساختار داخلیش (همون کاری که for-of تو جاوااسکریپت انجام میده).
کی این پترنها رو کنار بذاریم
این بخش شاید مهمتر از خود پترنها باشه. خیلی از برنامهنویسهای تازهکار، بعد از یادگیری این الگوها، سعی میکنن همهجا ازشون استفاده کنن. این کار معمولاً نتیجهی عکس میده.
اگه یه کلاس ساده کارت رو راه میندازه، لازم نیست بپیچیش تو یه Factory یا Strategy. اگه هدفت از استفادهی یه پترن اینه که خودتو حرفهای نشون بدی نه اینکه یه مشکل واقعی حل کنی، احتمالاً داری کد رو واسه بقیه سختتر میکنی. اگه پروژهت یه اسکریپت یکبار مصرف یا یه MVP سریعه، این سرمایهگذاری اضافه شاید هیچوقت به بازده نرسه. و اگه فریمورکی که داری استفاده میکنی از قبل این پترن رو تو خودش داره (خیلی از فریمورکهای مدرن Dependency Injection یا Observer رو بیلتاین دارن)، دوباره پیادهسازیش کردن دستی فقط تکرار کاره.
در کل یه قانون مهم که باید درنظر بگیری: این پترنها رو وقتی جدی بگیر که کدت داره به جایی میرسه که هر تغییر کوچیک چند جای دیگه رو هم میشکنه، یا وقتی میدونی چیزی میسازی که قراره تو آینده گسترش پیدا کنه. تا اون موقع، ساده نوشتن معمولاً بهتر از over-engineering کردنه.
اگه دیزاین پترنها رو صرفاً یه لیست ۲۳ تایی اسم عجیب ببینی، خیلی زود فراموششون میکنی. ولی اگه هر پترن رو جواب یه مشکل واقعی در نظر بگیری، کمکم میبینی خیلی از فریمورکها و پروژههای بزرگی که هر روز باهاشون کار میکنی، دقیقاً رو همین ایدهها ساخته شدن.