دسترسی به متغیرها: مرز بین سرور و کلانیت به صورت پیشفرض، تمام متغیرهایی که در فایلهای .env تعریف میکنید فقط و فقط در سمت سرور (Node.js) قابل دسترسی هستن (مثلاً در API روتها یا Server Components). این یک قابلیت امنیتی هستش تا اطلاعات حساس شما به مرورگر کاربر ارسال نشه. اما اگر بخواید از یک متغیر در کامپوننتهای سمت کلایت (Client Components) استفاده کنید، باید این کار رو انجام بدید: کافیه اسم متغیر رو با عبارت NEXT_PUBLIC_ شروع کنید. با این کار، Next.js متوجه میشه که این متغیر حساس نیست و اجازه میده که در سمت کلایت هم بهش دسترسی داشته باشید:
# فقط در سمت سرور دسترسی دارد
ANALYTICS_SECRET_KEY=secret_123
# هم در سرور و هم در کامپوننتهای کلایت دسترسی دارد
NEXT_PUBLIC_API_URL=https://api.codoloper.com
ساخت پوشه Configs برای دسترسی بهتر: صدا زدن مداوم process.env.NEXT_PUBLIC_API_URL در سراسر پروژه، علاوه بر شلوغ کردن کد، دو مشکل اساسی داره: اول اینکه هیچ پیشنهادی (Auto-complete) از سمت ادیتور دریافت نمیکنید و دوم اینکه احتمال غلط املایی بالا میره. برای حل این مشکل مراحل زیر رو انجام بدید: ۱. در ریشه (Root) پروژه یک پوشه به نام configs ایجاد کنید. ۲. داخل اون یک فایل به نام global.ts بسازید. ۳. متغیرهای محیطی رو به صورت جدا در این فایل تعریف و اکسپورت کنید:
حالا هر کجای پروژه که به این متغیرها نیاز داشتید، به جای کار با process.env، خیلی راحت متغیر مورد نظرتون رو ایمپورت میکنید:
import { apiUrl, isProduction} from "@/configs/global";
با این کار کدهای تمیزتری هم دارید. جمعبندی مدیریت هوشمندانه متغیرهای محیطی در Next.js به ما این امکان رو میده که پروژههای امنتر و منعطفتری بسازیم. با درک درست از اولویتبندی فایلهای .env و استفاده از قابلیتهایی مثل پیشوند NEXT_PUBLIC_ و رویکرد Centralized Config، فرآیند توسعه و دیپلوی پروژه آسونتر میشه. نکته مهمِ اینکه: حتماً مطمئن شید که فایلهای با پسوند .local در فایل .gitignore شما قرار دارن تا به اشتباه روی مخازن گیت آپلود نشن! شما در پروژههاتون چطور متغیرها رو مدیریت میکنید؟ آیا تا به حال با چالش لود نشدن متغیرها در سمت کلایت مواجه شدید؟ نظرات و تجربیات خودتون رو در بخش کامنتها با ما در میون بذارید!
JSX.Element
ReactElement
props
type
any
// هر دو خط زیر از نظر عملکردی کاملاً یکسان هستند:
const buttonOne: React.ReactElement = <button>کلیک کنید</button>;
const buttonTwo: JSX.Element = <button>کلیک کنید</button>;
۳. مفهوم React Node: میرسیم به بزرگترین تایپ در ریآکت: React Node. تایپ ReactNode در واقع یک ابرمجموعه (Superset) هستش؛ یعنی هر چیزی که ریآکت توانایی رندر کردن اون رو روی صفحه داشته باشه، زیرمجموعه ReactNode قرار میگیره. به تعریف تایپ اون در هسته ریآکت نگاه کنید:
type ReactNode = ReactElement | string | number | Iterable<ReactNode> | ReactPortal | boolean | null | undefined;
همونطور که میبینید، یک ReactNode میتونه یک آبجکت ریاکتی، یک متن ساده، یک عدد، آرایهای از المانها، یا حتی مقادیر خالی مثل null و undefined باشه.
// تمام موارد زیر به عنوان ReactNode کاملاً معتبر هستند:
const nodeText: React.ReactNode = "یک متن ساده";
const nodeNumber: React.ReactNode = 1405;
const nodeElement: React.ReactNode = <div>یک المان کامپوننت</div>;
const nodeNull: React.ReactNode = null;
کجا از کدوم استفاده کنیم؟ الان که با ماهیت هرکدوم آشنا شدیم، بیاید ببینیم در پروژههای واقعی (مخصوصا موقع تعریف ابزارهای کاستوم و پروژههای تیمی) بهترین انتخاب کدوم میشه. سناریوی اول: تعریف فیلد children در کامپوننتها (Best Practice: ReactNode) اگر در حال ساخت یک کامپوننتِ Wrapper مثل دکمههای عمومی، Layout اصلی سایت یا کامپوننتهای Card هستید که قراره محتوای مختلفی درون خودش جا بده، همیشه از ReactNode استفاده کنید. این کار به بقیه برنامهنویسها اجازه میده تا هر چیزی (از متن ساده تا چند تگ تو در تو) رو داخل کامپوننت شما بفرستند:
type LayoutProps = {
  children: React.ReactNode; // بهترین انتخاب برای دریافت هر نوع محتوا
};

export default function Layout({ children }: LayoutProps) {
  return <main className="main-container">{children}</main>;
}
سناریوی دوم: محدود کردن خروجی به تگهای ساختاریافته (Best Practice: ReactElement) تصور کنید در حال ساخت کامپوننتی به نام List هستید و میخواید کاربر فقط و فقط تگهای <ListItem /> رو به عنوان فرزند ارسال کنه و اجازه نداشته باشه رشته متنی ساده یا عدد خالی بفرسته. در این سناریو، ReactElement انتخاب بهتری هست:
type ListProps = {
// کاربر نمیتواند متن ساده بفرستد، حتماً باید یک کامپوننت یا تگ معتبر باشد
children: React.ReactElement;
};
سناریوی سوم: تایپدهی خروجی توابع یا هوکهای کاستوم (Best Practice: JSX.Element) اگر متدی نوشتید که وظیفهش تولید و برگردوندن یک قطعه کد HTML یا کامپوننت هستش، تعیین JSX.Element به عنوان تایپ خروجی، خوانایی کد شما رو بالا میبره و مشخص میکنه که خروجی این تابع یک سینتکس JSX هستش:
جمعبندی انتخاب درست بین این سه تایپ، بستگی به میزان سختگیری یا انعطافپذیری لازم در کدهای شما داره. اگر دنبال انعطاف زیاد برای رندر انواع دادهها باشید، ReactNode انتخاب خوبیه. اما اگر میخواید ساختار رو محدود به آبجکتهای معتبر طراحی UI کنید، ReactElement و JSX.Element بهترین گزینهها هستن. شما در پروژههای خودتون بیشتر با کدوم از این تایپها سر و کار دارید؟ تا حالا به خاطر استفاده جابجا از اونها به باگهای تایپاسکریپتی خوردید؟ تجربیات خودتون رو در بخش نظرات با ما در میون بذارید!
برای یک اپ ساده مشکلی نیست. برای یک اپ موبایل با شبکهی ضعیف که هر round-trip اضافه چند صد میلیثانیه هزینه دارد، همین چیزی است که کاربران را اذیت میکند.
GraphQL: یک endpoint، دقیقاً همون چیزی که خواستی
GraphQL همین مشکل را حل میکند با این ایده که فقط یک endpoint داشته باشی، و کلاینت دقیقاً مشخص کند چه فیلدهایی را میخواهد:
query {
  user(id: 42) {
    name
    posts(limit: 5) { title }
    followersCount
  }
یک درخواست، دقیقاً دادهای که لازم داری، نه کمتر نه بیشتر. تیمهای فرانتاند معمولاً عاشق این میشوند چون دیگر برای هر تغییر کوچک در UI نباید از بکاند بخواهند یک endpoint جدید بسازد.
اما این آزادی قیمتی دارد. همان مثال N+1 که اول گفتم: اگر برای هر post بخواهی اطلاعات نویسندهاش را هم بگیری، resolver پیشفرض میتواند بهازای هر پست یک کوئری جدا به دیتابیس بزند. ده پست یعنی ده کوئری اضافه. راهحلش وجود دارد (مثل DataLoader برای batch کردن)، ولی این یعنی یک لایهی پیچیدگی که در REST اصلاً مجبور نبودی به آن فکر کنی. کش کردن هم سرراست نیست؛ چون همهچیز از یک endpoint با متد POST میآید، کشهای HTTP معمولی که برای REST جا افتادهاند، اینجا کار نمیکنند و باید کش را خودت در سطح اپلیکیشن مدیریت کنی.
gRPC: وقتی سرعت بین سرویسها مهمتر از خوانایی است
gRPC داستان متفاوتی دارد. این یکی اصلاً برای مرورگر طراحی نشده (هرچند gRPC-Web هم هست)؛ هدف اصلیاش ارتباط بین سرویسها در یک سیستم میکروسرویس است. بهجای JSON متنی، از Protocol Buffers استفاده میکند که باینری و فشرده است، و روی HTTP/2 کار میکند که چندین استریم را روی یک کانکشن همزمان میبرد.
نتیجهاش سرعت است؛ هم در حجم داده، هم در latency. قیمتش این است که دیگر نمیتوانی با مرورگر یا curl ساده پاسخ را بخوانی؛ باید فایل .proto را داشته باشی و کد را generate کنی. برای ارتباط بین دو سرویس داخلی که هیچکدام انسان نیست که مستقیم پاسخ را بخواند، این مشکلی نیست. برای یک API عمومی که توسعهدهندههای بیرونی باید با آن کار کنند، احتمالاً تجربهی بدتری میسازد.
پس کدوم رو انتخاب کنیم؟
اگر یک API عمومی یا نسبتاً ساده میسازی که کلاینتهای مختلف (وب، موبایل، شاید حتی توسعهدهندههای بیرونی) با آن کار میکنند و نیازهای دادهایشان شبیه هم است، REST هنوز انتخاب امنتری است. کسی که برای اولینبار با APIات روبهرو میشود، سریعتر میفهمدش.
اگر چند کلاینت با نیازهای دادهای خیلی متفاوت داری (مثلاً اپ موبایل که میخواهد کمترین داده ممکن را بگیرد، و داشبورد ادمین که میخواهد همهچیز را یکجا ببیند)، GraphQL این مشکل را با هزینهی پیچیدگی بیشتر در بکاند حل میکند. فقط حواست به N+1 باشد.
و اگر صحبت از ارتباط داخلی بین سرویسهاست، جایی که سرعت مهمتر از قابلخواندنبودن است، gRPC معمولاً برنده است.
نکتهی آخر: هیچ قانونی نمیگوید باید فقط یکی را انتخاب کنی. خیلی از سیستمهای واقعی، REST را برای API عمومی نگه میدارند و gRPC را برای ارتباط داخلی بین سرویسها به کار میبرند. انتخاب درست همیشه یکی نیست؛ گاهی سهتاست، هر کدام جایی که واقعاً مزیت دارد.
interface Client {
  name: string;
}

interface Client {
  age: number;
}

// ادغام خودکار: حالا کلاینت هر دو فیلد را دارد
const newClient: Client = {
  name: "Ali",
  age: 25
};
اگر همین کار رو با type انجام بدید، بلافاصله با خطای دیتای تکراری (Duplicate identifier) مواجه میشد. این ویژگیِ interface برای زمانهایی که میخواید برای یک کتابخانه اکسترنال (مثل اضافه کردن فیلد به درخواستهای Express یا تنظیمات تلویند) متغیر جدیدی اضافه کنید، حیاتیه. ۲. انواع دادههای غیر شیء یا Primitive Types (کدوم بهتره: Type) یک interface فقط و فقط میتونه شکل یک شیء (Object) یا تابع (Function) رو مشخص کنه. اما کلمه کلیدی type بسیار انعطافپذیرتره و میتونه برای تعریف انواع الیاسها (Aliases)، تایپهای ترکیبی (Union) یا چندوجهی (Intersection) استفاده شه:
// Union Types (تعریف تایپی که میتواند یکی از چند حالت باشد)
type Status = "pending" | "approved" | "rejected";
type ID = string | number;
// Tuple (آرایهای با طول و تایپ مشخص)
type Point = [number, number];
انجام کارهای بالا با interface غیرممکنه. ۳. نحوه ارثبری و گسترش کد (Extending) هر دو ابزار روش خاص خودشون رو برای گسترش دادن تایپها دارن. interface از کلمه کلیدی extends استفاده میکنه که از نظر فکری به شیءگرایی (OOP) نزدیکتره، در حالی که type از عملگر & (Intersection) استفاده میکنه:
// گسترش با Interface
interface Animal { name: string; }
interface Bear extends Animal { honey: boolean; }

// گسترش با Type
type AnimalType = { name: string; };
type BearType = AnimalType & { honey: boolean; };
بالاخره چه زمانی از کدوم استفاده کنیم؟ (Best Practices) امروز تو دنیای توسعه وب، توافقهای نانوشته اما استانداردی شکل گرفته که بر اساس اونها میشه از فرمول زیر برای پروژهها به استفاده کرد: از Type استفاده کنید اگر: •در حال طراحی کامپوننتهای فرانتاند (مثل Props در ریاکت و نکست) هستید؛ چون تایپها برای این کار تمیزترن، جلوی ادغامهای ناخواسته رو میگیرن و کار با قابلیتهای کامپوننت رو راحتتر میکنن. •نیاز به تعریف Union Types دارید (مثلاً وضعیتهای یک دکمه یا کامپوننت: 'primary' | 'secondary' | 'danger'). •میخواید رفتارهای پیچیدهای مثل کدهای داینامیک، تایپهای شرطی (Conditional Types) یا الیاسهای ساده برای کدهای پایه (Primitives) بسازید. از Interface استفاده کنید اگر: •ساختار دادههای دیتابیس، مدلها یا API (مثل خروجیهای Prisma یا آبجکتهای سمت بکآند) رو تعریف میکنید که فرمت کاملاً شیءگرا دارن. •در حال نوشتن یک کتابخانه (Library) یا بسته نرمافزاری هستید و میخواید دیگران بتونن با قابلیت Declaration Merging، ویژگیهای جدیدی به متغیرهای شما اضافه کنن و اون رو گسترش بدن.
Ctrl + S
Cmd + S
.scss
.scss
settings.json
"scss.lint.unknownAtRules": "ignore"
نکته: اگر تو پروژههای مختلفتون هم از CSS معمولی و هم از SCSS استفاده میکنید، میتونید هر دو خط کد رو در فایل تنظیمات قرار بدید تا این خطا تو هیچکدوم از فایلها تکرار نشه.
جمعبندی گاهی اوقات هشدارهای پیشفرضِ ابزارهای توسعه، برای کدهای مدرن بهینهسازی نشدن و باعث شلوغی محیط کدنویسی میشن. با انجام این تغییر ساده، ادیتورتون رو جوری شخصیسازی کردید که تنها خطاهای واقعی و ساختاری کد رو به شما نشون میده. شما برای حل این مشکل از چه روشی استفاده میکردید؟
تصور کنید طراح پروژه، یک رنگ اصلی (Primary Color) به شما داده که قراره در دکمهها و لینکها ازش استفاده کنید. خب، این المانها قطعاً به حالت Hover (وقتی موس روی اونها میره) نیاز دارن.
یک راه این هستش که رنگ اصلی رو در سایت oklch.com وارد کنید و فقط با کم و زیاد کردن بخش Lightness (روشنایی)، خیلی راحت نسخههای تاریکتر یا روشنترِ همون رنگ رو برای Hover بسازید.
راه دوم که پیشنهاد میشه افزونه OKLChanger در VS Code هست:
برای اینکه مدام بین مرورگر و ادیتور جابجا نشید: ۱. افزونه OKLChanger رو در VS Code نصب کنید. ۲. در فایل استایل خود (مثلاً global.css در پروژههای Next.js) رنگ Hex خودتون رو بنویسید:
:root {
  --color-primary: #3b82f6;
}
۳. کد رنگ رو با موس انتخاب کنید و کلیدهای Ctrl+Shift+P (در مک Cmd+Shift+P) رو بزنید. ۴. عبارت OKLChanger رو سرچ و اینتر کنید تا رنگ شما به فرمت OKLCH تبدیل بشه. به همین راحتی!
قسمت اصلی: ترکیب OKLCH با تابع color-mix
حالا چطور با این کار حجم باندل پروژه رو کم کنیم؟ جواب ساده است: با کمک تابع color-mix در CSS. با این فانکشن دیگه نیازی نیست برای هر حالت Hover یک متغیر رنگی جدید تعریف کنید؛ بلکه همهچیز رو به صورت داینامیک در خودِ مرورگر ترکیب میکنید!
به این کد نگاه کنید:
:root {
  --color-primary: oklch(0.63 0.25 258.2); /* رنگ اصلی */

  /* ساخت رنگ به صورت داینامیک */
  --primary-hover: color-mix(in oklch, var(--color-primary), black 7%);
}
این تابع دقیقاً چطور کار میکنه؟
فرمولش خیلی ساده است: color-mix(فضای رنگی, رنگ اصلی شما, رنگی که میخواهید با آن مخلوط شود + درصد آن)
در مثال بالا، ما به مرورگر گفتیم: «در فضای رنگی oklch، رنگ اصلی ما رو با ۷٪ رنگ مشکی ترکیب کن». نتیجه؟ یک رنگ تیره تر و اصولی برای حالت Hover، بدون اینکه خط کد اضافی بنویسیم یا کلی متغیر جدید بسازیم. این یعنی کد کمتر، فایل خلوتتر و در نتیجه کاهش حجم باندل!
یک ایده برای خلاقیت: شما مجبور نیستید فقط از سیاه و سفید برای ترکیب استفاده کنید! در پروژههای شخصی یا کارهای خلاقانه میتونید رنگ اصلیتون رو با رنگهای دیگر (مثلاً کمی زرد یا آبی) ترکیب کنید تا افکتهای جدیدی خلق کنید؛ البته در پروژههای رسمی شرکتی بهتره خیلی ریسک نکنید و به همون تیره و روشن کردن بسنده کنید.
خبر خوب: سازگاری کامل با Tailwind CSS!
خبر خوب اینه که این روش کاملاً با Tailwind سازگاره!
بهخصوص در نسخههای جدید تیلوند، شما میتونید خیلی راحت این متغیرها رو توی دایرکتیو @theme معرفی کنید تا کلاسهای داینامیکی مثل bg-primary و hover:bg-primary-hover رو در اختیارتون بذاره:
با این کار، تیلوند به طور خودکار متغیرهای بومی CSS شما رو میشناسه و بدون هیچ پکیج یا ابزار اضافی، قدرت OKLCH و color-mix رو مستقیم وارد کامپوننتهاتون میکنه.
جمعبندی
استفاده از OKLCH و color-mix دست شما رو برای نوشتن کدهای CSS تمیزتر، هوشمندتر و بهینهتر باز میذاره. با این روش، تغییر تم (Theme) سایت در آینده هم خیلی راحت میشه و دیگه نیازی به تعریف کردن چندین رنگ تکراری ندارید.
شما تا حالا از این قابلیتهای مدرن CSS در پروژههاتون استفاده کردید؟ تجربه یا سوالی دارید؟ در بخش کامنتها منتظرتون هستیم!
چرا ریورس پراکسی اینقدر مهم است؟
در یک محیط پروداکشن واقعی، ریورس پراکسی وظایف زیادی به عهده میگیرد:
SSL Termination: مدیریت گواهینامه HTTPS در یک جا متمرکز میشود. سرویسهای پشتی میتوانند بدون SSL روی شبکه داخلی کار کنند.
Load Balancing: ترافیک بین چند نمونه از یک سرویس تقسیم میشود تا هیچ کدام اشباع نشوند.
Caching: پاسخهای تکراری ذخیره میشوند تا سرور اصلی بار کمتری داشته باشد.
Static File Serving: فایلهای CSS، JS و تصاویر مستقیم از ریورس پراکسی سرو میشوند بدون اینکه سرور برنامه اصلی درگیر شود.
Security: آدرس و پورت سرورهای اصلی از کاربر پنهان میماند. میتوان rate limiting و فیلتر IP را در این لایه اعمال کرد.
Logging: تمام درخواستها در یک نقطه لاگ میشوند.
چرا Nginx؟
Nginx (تلفظ: انجین-ایکس) یک وبسرور با کارایی بالاست که به عنوان ریورس پراکسی هم استفاده میشود. در سال ۲۰۰۴ توسط Igor Sysoev ساخته شد و امروز بیش از ۳۴ درصد از وبسرورهای دنیا از آن استفاده میکنند.
دلیل محبوبیتش ساختار event-driven آن است. برخلاف Apache که برای هر درخواست یک thread جدید باز میکند، Nginx میتواند هزاران اتصال همزمان را با منابع کم مدیریت کند.
گزینههای دیگری مثل Apache، Caddy، Traefik و HAProxy هم وجود دارند که هرکدام کاربرد خودشان را دارند. اما Nginx به دلیل پرفورمنس بالا، مستندات غنی و جامعه بزرگ، رایجترین انتخاب برای محیطهای پروداکشن است.
راهاندازی عملی: از صفر تا پروداکشن
محیط ما
فرض میکنیم یک سرور Ubuntu 22.04 داریم و میخواهیم:
یک اپ Node.js روی پورت 3000 داریم
یک اپ Python/FastAPI روی پورت 8000 داریم
دامنه example.com را داریم
میخواهیم SSL داشته باشیم
میخواهیم استاتیک فایلها بهینه سرو شوند
مرحله اول: نصب Nginx
sudo apt update
sudo apt install nginx -y

# بررسی وضعیت سرویس
sudo systemctl status nginx

# اگر اجرا نیست:
sudo systemctl start nginx
sudo systemctl enable nginx
بعد از نصب، با رفتن به آدرس IP سرور باید صفحه پیشفرض Nginx را ببینید.
مرحله دوم: آشنایی با ساختار فایلهای Nginx
/etc/nginx/
├── nginx.conf ← فایل اصلی تنظیمات
├── sites-available/ ← تنظیمات سایتها (غیرفعال)
├── sites-enabled/ ← تنظیمات فعال (لینک به sites-available)
├── conf.d/ ← فایلهای تنظیمات اضافی
└── snippets/ ← قطعههای قابل استفاده مجدد
فلسفه کار این است که تنظیمات را در sites-available مینویسید و با یک symlink در sites-enabled فعالشان میکنید. این باعث میشود بتوانید سایتها را راحت فعال و غیرفعال کنید.
مرحله سوم: اولین تنظیم ریورس پراکسی
یک فایل تنظیمات برای اپ Node.js بسازیم:
sudo nano /etc/nginx/sites-available/myapp
server {
listen80;
server_name example.com www.example.com;
# لاگهای اختصاصی این سایتaccess_log /var/log/nginx/myapp_access.log;
error_log /var/log/nginx/myapp_error.log;
location / {
proxy_pass http://localhost:3000;
proxy_http_version1.1;
# هدرهای ضروری برای ریورس پراکسیproxy_set_header Host $host;
proxy_set_header X-Real-IP $remote_addr;
proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
proxy_set_header X-Forwarded-Proto $scheme;
# برای WebSocket اگر استفاده میکنیدproxy_set_header Upgrade $http_upgrade;
proxy_set_header Connection 'upgrade';
proxy_cache_bypass $http_upgrade;
}
}
حالا آن را فعال میکنیم:
sudo ln -s /etc/nginx/sites-available/myapp /etc/nginx/sites-enabled/

# بررسی صحت تنظیمات - این دستور را قبل از هر reload اجرا کنید
sudo nginx -t

# اعمال تغییرات
sudo systemctl reload nginx
چرا آن هدرها ضروری هستند؟
proxy_set_header Host $host: بدون این، سرور اصلی نمیداند درخواست برای کدام دامنه آمده.
X-Real-IP و X-Forwarded-For: چون ریورس پراکسی جلوی سرور است، IP کلاینت در سرور اصلی به درستی نمایش داده نشده است. این هدرها IP واقعی کاربر را انتقال میدهند.
X-Forwarded-Proto: به سرور اصلی میگوید کلاینت با HTTP آمده یا HTTPS. بدون این، اگر HTTPS داشته باشید و redirect تولید کنید، ممکن است loop ایجاد شود.
مرحله چهارم: مدیریت چند سرویس
حالا فرض کنید میخواهید هم اپ Node.js و هم اپ Python داشته باشید، هر کدام زیر یک مسیر مختلف:
یک نکته مهم: توجه به slash آخر در proxy_pass http://localhost:8000/ مهم است. وقتی slash دارد، مسیر /api/users به /users تبدیل میشود. اگر slash نباشد، به /api/users ارسال میشود.
تجدید خودکار گواهینامه هم از قبل تنظیم شده. میتوانید با این دستور بررسی کنید:
sudo certbot renew --dry-run
تنظیمات پروداکشن که اغلب نادیده گرفته میشوند
بهینهسازی فایل اصلی nginx.conf
# /etc/nginx/nginx.confuser www-data;
# معمولاً برابر با تعداد هستههای CPUworker_processes auto;
events {
# حداکثر اتصال همزمان هر workerworker_connections1024;
useepoll;
multi_accepton;
}
http {
# پنهان کردن نسخه Nginx در هدرهاserver_tokensoff;
# بهینهسازی ارسال فایلsendfileon;
tcp_nopushon;
tcp_nodelayon;
# فشردهسازی پاسخهاgzipon;
gzip_types text/plain text/css application/json application/javascript text/xml application/xml;
gzip_min_length1000;
gzip_varyon;
# timeoutهای مناسبkeepalive_timeout65;
client_max_body_size10M;
# هدرهای امنیتیadd_header X-Frame-Options "SAMEORIGIN" always;
add_header X-Content-Type-Options "nosniff" always;
add_header X-XSS-Protection "1; mode=block" always;
include /etc/nginx/conf.d/*.conf;
include /etc/nginx/sites-enabled/*;
}
Rate Limiting
جلوگیری از درخواستهای بیش از حد یک کلاینت:
http {
# تعریف zone برای rate limiting# zone=api: اسم zone# 10m: ۱۰ مگابایت حافظه برای ذخیره IPها# rate=10r/s: حداکثر ۱۰ درخواست در ثانیهlimit_req_zone $binary_remote_addr zone=api:10m rate=10r/s;
limit_req_zone $binary_remote_addr zone=login:10m rate=5r/m;
server {
location /api/ {
limit_req zone=api burst=20 nodelay;
proxy_pass http://localhost:3000;
}
location /login {
limit_req zone=login burst=3;
proxy_pass http://localhost:3000;
}
}
}
burst=20 یعنی اگر ناگهان ۲۰ درخواست آمد قبول میشود، اما بعدش باید به نرخ عادی برگردد.
Load Balancing واقعی
http {
# تعریف upstream با چند سرورupstream nodejs_backend {
# روش پیشفرض: round robinserver localhost:3000;
server localhost:3001;
server localhost:3002;
# keepalive برای بهبود پرفورمنسkeepalive32;
}
# یا با وزندهی (اگر یک سرور قویتر است)upstream weighted_backend {
server server1.internal weight=3;
server server2.internal weight=1;
}
# ip_hash: هر کاربر همیشه به یک سرور میرود (مفید برای session)upstream sticky_backend {
ip_hash;
server server1.internal;
server server2.internal;
}
server {
location / {
proxy_pass http://nodejs_backend;
proxy_http_version1.1;
proxy_set_header Connection "";
}
}
}
Caching برای API
http {
# تعریف cache zoneproxy_cache_path /var/cache/nginx levels=1:2 keys_zone=api_cache:10m
max_size=1g inactive=60m use_temp_path=off;
server {
location /api/public/ {
proxy_cache api_cache;
proxy_cache_valid20010m;
proxy_cache_valid4041m;
# هدری که نشان میدهد پاسخ از cache آمده یا نهadd_header X-Cache-Status $upstream_cache_status;
proxy_pass http://localhost:3000;
}
}
}
یک سناریوی کامل پروداکشن
بگذارید همه چیز را در یک تنظیم واقعی کنار هم بگذاریم. فرض میکنیم یک استارتاپ داریم با:
# بررسی صحت تنظیمات
sudo nginx -t
# reload بدون قطع اتصالات فعال
sudo systemctl reload nginx
# بررسی لاگهای خطا به صورت real-time
sudo tail -f /var/log/nginx/error.log
# بررسی اتصالات فعال
sudo nginx -s status
# نمایش تنظیمات کامل بعد از include
sudo nginx -T
# بررسی اینکه کدام فایل تنظیمات اعمال شده
sudo nginx -T | grep server_name
خطاهای رایج
502 Bad Gateway: سرور اصلی در دسترس نیست یا crash کرده. ابتدا بررسی کنید آیا سرویس روی پورت مورد نظر اجرا است:
504 Gateway Timeout: درخواست خیلی طول کشیده. proxy_read_timeout را افزایش دهید یا مشکل سرور اصلی را پیدا کنید.
413 Request Entity Too Large:client_max_body_size را افزایش دهید.
WebSocket کار نمیکند: هدرهای Upgrade و Connection را بررسی کنید.
Nginx در برابر رقبا
Nginx در برابر Apache
Apache مدل process-based دارد و برای هر اتصال یک thread باز میکند. این در ترافیک بالا منابع زیادی مصرف میکند. Nginx با مدل event-driven چندین هزار اتصال را با یک worker process مدیریت میکند. اما Apache مزیتهایی هم دارد: .htaccess که اجازه میدهد تنظیمات در سطح دایرکتوری تعریف شوند، و پشتیبانی بهتر از برخی فناوریهای قدیمی مثل mod_php.
Nginx در برابر Caddy
Caddy یک رقیب جدیدتر است که SSL را به صورت خودکار مدیریت میکند. تنظیمات آن سادهتر است اما کانفیگ Nginx انعطاف و کنترل بیشتری میدهد. برای تیمهای کوچک که میخواهند سریع راه بیافتند، Caddy گزینه خوبی است.
Nginx در برابر Traefik
Traefik برای محیطهای container-native (Kubernetes، Docker Swarm) طراحی شده و کشف خودکار سرویسها را پشتیبانی میکند. اگر با Kubernetes کار میکنید، Traefik یا ingress-nginx انتخابهای بهتری هستند.
مزایا و معایب این رویکرد
مزایا
ریورس پراکسی لایهای از انتزاع بین کاربر و زیرساخت ایجاد میکند. میتوانید سرورهای پشتی را بدون اطلاع کاربر تغییر دهید. SSL در یک جا مدیریت میشود. پرفورمنس بهتری برای فایلهای استاتیک دارید. امنیت بیشتری دارید چون سرورهای اصلی مستقیم در معرض اینترنت نیستند.
معایب
یک لایه پیچیدگی اضافه میشود. دیباگ کردن مشکلات شبکه کمی سختتر میشود چون باید مطمئن شوید مشکل از Nginx است یا سرویس پشتی. اگر Nginx crash کند، همه چیز از کار میافتد (که با high availability میتوان حل کرد).
جمعبندی
ریورس پراکسی دیگر یک گزینه اختیاری نیست. هر اپلیکیشنی که میخواهد به شکل جدی در پروداکشن باشد، به آن نیاز دارد.
Nginx به خاطر پرفورمنس، انعطاف و جامعه بزرگ استانداردترین انتخاب برای این کار است. تنظیمهایی که در این مقاله دیدیم، پایهای هستند که در اکثر محیطهای واقعی استفاده میشوند.
نظر شخصی: اگر تازه شروع میکنید، با یک تنظیم ساده شروع کنید و کمکم گسترش دهید. سعی نکنید از ابتدا همه چیز را کامل کنید. اما حتماً از همان ابتدا SSL داشته باشید و هدرهای پراکسی را درست تنظیم کنید، این دو مورد را نمیتوانید بعداً راحت اضافه کنید بدون اینکه کارها خراب شود.
سوالات متداول
آیا میتوانم بدون Nginx هم اپلیکیشن را deploy کنم؟ بله، میتوانید اپلیکیشن را مستقیم روی پورت 80 یا 443 اجرا کنید. اما در عمل این کار مشکلاتی دارد: SSL مدیریت کردن سختتر است، نمیتوانید چند سرویس روی یک IP داشته باشید، و پرفورمنس سرو فایلهای استاتیک کمتر است.
تفاوت proxy_pass http://localhost:3000 و proxy_pass http://localhost:3000/ چیست؟ وقتی slash آخر هست، مسیر از URL حذف میشود. مثلاً location /api/ با proxy_pass http://localhost:3000/ یعنی /api/users به /users تبدیل میشود. بدون slash، مسیر کامل منتقل میشود.
چطور بفهمم Nginx درست کانفیگ شده؟ با دستور sudo nginx -t صحت syntax را بررسی کنید. بعد با ابزاری مثل curl -v هدرهای پاسخ را بررسی کنید و ببینید هدر Server چه میگوید و هدرهایی که تنظیم کردهاید وجود دارند یا نه.
آیا Nginx برای WebSocket مناسب است؟ بله، اما باید هدرهای Upgrade و Connection را تنظیم کنید و proxy_read_timeout را بالا ببرید چون اتصالات WebSocket طولانیمدت هستند.
چطور یک سرور Nginx را بدون downtime ریستارت کنم؟ از sudo systemctl reload nginx یا sudo nginx -s reload استفاده کنید. این دستورها کانفیگ جدید را بارگذاری میکنند بدون اینکه اتصالات فعال قطع شوند.
آیا Nginx میتواند جایگزین یک load balancer سختافزاری شود؟ برای اکثر پروژهها بله. Nginx در محیطهایی با صدها هزار درخواست در ثانیه هم به خوبی کار میکند. تنها در مقیاسهای بسیار بزرگ (میلیونها درخواست در ثانیه) ممکن است به راهحلهای تخصصیتر نیاز باشد.
FROM node:20-alpine

WORKDIR /app

COPY package*.json ./

RUN npm ci

COPY . .

RUN npm run build

EXPOSE 3000

CMD ["npm", "start"]
اینجا حواستون باشه نوع بیلدتون چیه توی Next Js، مثلا اگر standalone باشه باید از "node /server.js" برای شروع سرو کردن استفاده کنید:
FROM node:20-alpine AS builder

WORKDIR /app

COPY package*.json ./
RUN npm ci

COPY . .

RUN npm run build

FROM node:20-alpine

WORKDIR /app

COPY --from=builder /app/.next/standalone ./
COPY --from=builder /app/.next/static ./.next/static
COPY --from=builder /app/public ./public

EXPOSE 3000

CMD ["node", "server.js"]
دلیل copy کردن package.json قبل از سورس: Docker لایهها رو cache میکنه. اگر سورس کد عوض بشه ولی dependency عوض نشه، npm install مجدداً اجرا نمیشه و build سریعتره.
قبل از اجرا مطمئن شو DNS دامنهات به IP سرور اشاره میکنه و پورت ۸۰ باز باشه.
همچنین اینجا بازم باید بگم که بخاطر شرایط اینترنت ایران، بهتره که ssl رو هم از روش های جایگذین ست کنید که renew بشه که توی devneeds (بخش SSL) مثلا توضیح داده شده به صورت رایگان گرفتن ssl.
۱۰. تنظیمات Production
در docker-compose.yml از restart: unless-stopped استفاده کن تا container بعد از ریاستارت سرور هم بالا بیاد.
برای دیدن لاگهای دقیقتر:
docker logs -f node_app
docker inspect node_app
جمعبندی
ترکیب استاندارد برای یه دیپلوی حرفهای:
Docker — اجرای ایزوله اپ
Docker Compose — مدیریت سرویسها
Nginx — reverse proxy و ورودی ترافیک
SSL — امنیت ارتباط
میرور داخلی — پایداری در شرایط ایران
روش
مشکل اصلی
Node + PM2 مستقیم
وابستگی به سرور — هر تغییری میتونه محیط رو خراب کنه
نصب دستی
conflict dependency — قابل تکرار نیست
Docker + Compose
محیط ثابت — deploy یکسان روی همه سرورها
مشاهده وضعیت کانتینرهای در حال اجرا
خواندن لاگهای هر سرویس مستقیم از مرورگر
ورود به Shell کانتینر بدون نیاز به exec -it
ساخت، حذف و ریاستارت کانتینرها
مدیریت Volume ها و Network ها
اجرای Docker Compose Stack ها
مدیریت چندین سرور Docker از یک پنل واحد
مدیریت Image ها و پاکسازی فضا
رایگان است یا پولی؟
Portainer Community Edition (CE) کاملاً رایگان و متنباز است و برای اکثر توسعهدهندگان بیش از کافی است.
نسخه
هزینه
مناسب برای
Community Edition (CE)
رایگان
توسعهدهندگان، VPS، پروژههای شخصی
Business Edition (BE)
رایگان تا ۳ Node، بعد پولی
تیمها و شرکتها با نیاز به RBAC، SSO، GitOps
اگر میخواهی کانتینر اجرا کنی، لاگ بخوانی، Docker Compose مدیریت کنی و اپلیکیشن Deploy کنی، نسخه CE کاملاً کافی است.
نصب روی VPS در کمتر از یک دقیقه
اگر Docker روی سرورت نصب است، با همین دستورات Portainer را راهاندازی کن:
نکته امنیتی: هرگز Portainer را مستقیم روی پورت عمومی اجرا نکن. حتماً پشت Nginx با HTTPS قرار بده و پورت ۹۴۴۳ را از Firewall مسدود کن.
برای چه کسانی مناسب است؟
توسعهدهندگانی که VPS یا سرور شخصی دارند
کسانی که سرویسهایی مثل PostgreSQL، Redis، MinIO یا Grafana را Self-host میکنند
تازهکارهایی که دارند Docker یاد میگیرند و میخواهند وضعیت کانتینرها را بصری ببینند
فریلنسرها و تیمهای کوچکی که باید چند پروژه روی یک سرور مدیریت کنند
Portainer جایگزین CLI میشود؟
نه، و نباید باشد. Portainer یک ابزار مکمل است، نه جایگزین. برای مدیریت روزمره و مانیتورینگ عالی است، اما برای کارهای پیشرفتهتر مثل دیباگ مشکلات شبکه، نوشتن Compose فایلهای پیچیده یا Scripting، همچنان به CLI نیاز داری.
توصیه: هر دو را یاد بگیر. CLI برای تسلط واقعی ضروری است، Portainer برای مدیریت راحتتر روزانه.
جمعبندی
Portainer یک ابزار رایگان، سریع و کاربرپسند برای مدیریت Docker است. اگر سرور یا VPS داری، نصب Portainer یکی از اولین کارهایی است که باید انجام دهی. در کمتر از یک دقیقه نصب میشود و از همان لحظه مدیریت کانتینرهایت را متحول میکند.
✅ تست نصب
gcc --version
روی مک، gcc در واقع یک alias برای clang هست که کاملاً سازگار با کد C استاندارد است. اگه خروجیای شبیه این دیدید، نصب موفق بوده:
Apple clang version 15.0.0 (clang-1500.0.40.1)
Target: arm64-apple-darwin23.0.0
روش دوم: نصب GCC اصلی با Homebrew
اگه میخواید نسخه اصلی GCC (نه clang) داشته باشید، ابتدا Homebrew رو نصب کنید:
GCC نصبشده از طریق Homebrew با نام مشخص نسخه در دسترسه، مثلاً gcc-13. برای راحتی میتونید alias بسازید:
alias gcc='gcc-13'
این خط رو به فایل ~/.zshrc (یا ~/.bashrc) اضافه کنید تا دائمی بشه.
🐧 لینوکس
روی اکثر توزیعهای لینوکس، GCC یا از قبل نصبه یا با یک دستور ساده نصب میشه. روش نصب بسته به توزیعی که استفاده میکنید فرق داره.
اوبونتو / دبیان و توزیعهای مشابه
ابتدا لیست پکیجها رو بهروز کنید:
sudo apt update
سپس GCC رو نصب کنید:
sudo apt install gcc
اگه میخواید مجموعه کامل ابزارهای توسعه (شامل make، g++ و غیره) رو یکجا نصب کنید:
sudo apt install build-essential
Fedora / RHEL / CentOS
sudo dnf install gcc
یا برای مجموعه کامل ابزارهای توسعه:
sudo dnf groupinstall "Development Tools"
Arch Linux / Manjaro
sudo pacman -S gcc
یا برای مجموعه کامل:
sudo pacman -S base-devel
✅ تست نصب (برای همه توزیعها)
gcc --version
اگه خروجی شبیه زیر دیدید، نصب موفق بوده:
gcc (Ubuntu 13.2.0-23ubuntu4) 13.2.0
🚀 اولین برنامه C روی هر سیستمعامل
بعد از نصب کامپایلر، میتونید اولین برنامهتون رو تست کنید. یک فایل به نام hello.c بسازید با این محتوا:
#include <stdio.h>

int main() {
    printf("Hello, World!\n");
    return 0;
}
سپس با دستور زیر کامپایل و اجرا کنید:
gcc hello.c -o hello
روی ویندوز:
.\hello.exe
روی مک و لینوکس:
./hello
اگه Hello, World! در خروجی دیدید، همه چیز درست کار میکنه و آمادهی شروع برنامهنویسی C هستید! 🎉
gcc -E
gcc -S
جریان کاری کامپایلر (فرآیند کامپایل)
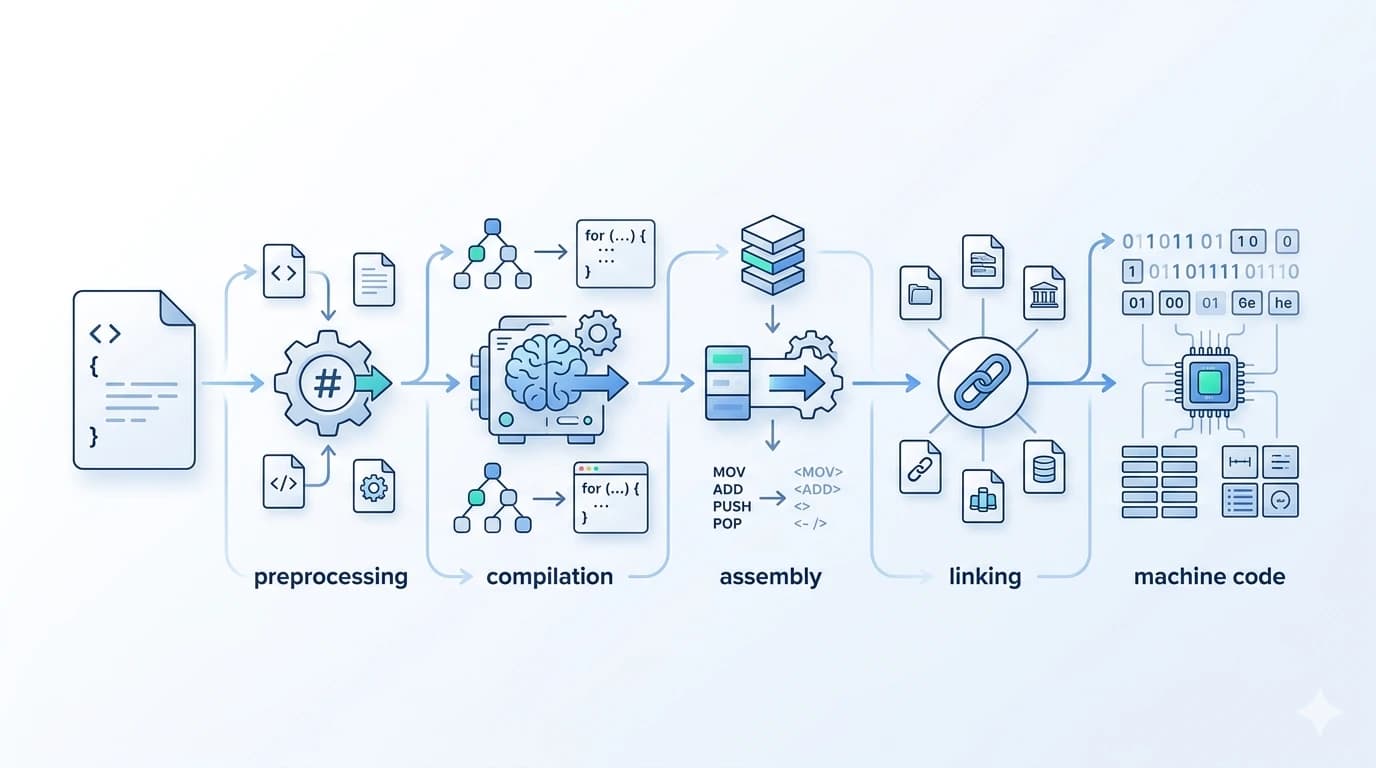
فرآیند کامپایل در زبان C یک جریان خطی است که از کد منبع شروع شده و به فایل اجرایی ختم میشود. بیایید این جریان را گام به گام بررسی کنیم:
۱. پیشپردازش (Preprocessing)
این مرحله توسط پیشپردازنده (preprocessor) انجام میشود که بخشی از کامپایلر است. پیشپردازنده دستورات خاصی مانند #define، #include و #ifdef را پردازش میکند. برای مثال، #define یک ماکرو تعریف میکند که جایگزین مقادیر ثابت میشود. خروجی این مرحله یک فایل موقتی (معمولاً با پسوند .i) است. هیچ چک سینتکسی در این مرحله انجام نمیشود؛ فقط جایگزینی متن صورت میگیرد.
۲. تجزیه و تحلیل Lexical (Lexical Analysis)
در این فاز، کامپایلر کد را به توکنها (tokens) تقسیم میکند. توکنها شامل کلمات کلیدی (مانند int، if)، شناسهها (variables)، عملگرها (+، =) و ثابتها هستند. این مرحله توسط lexer یا scanner انجام میشود و خطاهای ساده مانند کاراکترهای نامعتبر را تشخیص میدهد.
۳. تجزیه و تحلیل نحوی (Syntax Analysis)
parser توکنها را بررسی میکند تا ساختار نحوی کد را بر اساس گرامر زبان C تأیید کند. برای مثال، چک میکند که آیا بعد از if یک پرانتز وجود دارد یا خیر. خروجی این مرحله یک درخت نحوی (syntax tree) است که ساختار کد را نشان میدهد.
۴. تجزیه و تحلیل معنایی (Semantic Analysis)
در این مرحله، کامپایلر معنای کد را چک میکند؛ مثلاً بررسی میکند که آیا متغیرها تعریف شدهاند، انواع دادهها سازگار هستند (type checking)، و هیچ تناقضی وجود ندارد. اگر خطایی مانند استفاده از متغیر تعریفنشده پیدا شود، کامپایلر آن را گزارش میدهد.
۵. بهینهسازی (Optimization)
کامپایلر کد را برای کارایی بیشتر بهینه میکند، مانند حذف کدهای مرده (dead code elimination) یا بازنویسی حلقهها برای سرعت بالاتر. این مرحله اختیاری است و با فلگهایی مانند -O2 در GCC فعال میشود.
۶. تولید کد (Code Generation)
درخت نحوی به کد اسمبلی (با پسوند .s) تبدیل میشود. این کد وابسته به معماری ماشین (مانند x86 یا ARM) است.
۷. اسمبلی (Assembly)
assembler کد اسمبلی را به فایل آبجکت (object file با پسوند .o) تبدیل میکند که شامل کد ماشین باینری است.
۸. لینکینگ (Linking)
linker فایلهای آبجکت را با کتابخانههای استاندارد (مانند libc) ترکیب میکند تا فایل اجرایی (مانند a.out یا .exe) تولید شود. لینکینگ میتواند استاتیک (static) باشد که کتابخانهها را داخل فایل اجرایی کپی میکند، یا دینامیک (dynamic) که به کتابخانههای خارجی اشاره میکند.
اگر در هر مرحله خطایی رخ دهد، فرآیند متوقف شده و کامپایلر پیام خطا نمایش میدهد. جریان کلی را میتوان با دستور زیر خلاصه کرد، که تمام مراحل را به طور خودکار انجام میدهد:
gcc main.c -o output
نحوه ورودیها و خروجیها
ورودی اصلی کامپایلر زبان C، فایل کد منبع با پسوند .c است. ورودیهای دیگر میتوانند شامل فلگهای کامپایلر (مانند -Wall برای هشدارها) یا فایلهای هدر (.h) باشند که از طریق #include ادغام میشوند.
خروجیها بسته به مرحله متفاوت هستند:
پس از پیشپردازش: فایل .i با کد گسترشیافته.
پس از کامپایل: فایل اسمبلی .s.
پس از اسمبلی: فایل آبجکت .o.
پس از لینکینگ: فایل اجرایی که میتواند مستقیماً اجرا شود (مانند ./output در لینوکس).
برای پروژههای بزرگ، چندین فایل .c کامپایل شده و لینک میشوند:
gcc file1.c file2.c -o program
خروجی همچنین میتواند شامل فایلهای دیباگ (با -g) یا بهینهشده باشد.
مکانیسم include کردن در زبان C
یکی از ویژگیهای کلیدی پیشپردازنده C، دستور #include است که اجازه میدهد کد از فایلهای دیگر ادغام شود. این مکانیسم برای سازماندهی کد و استفاده مجدد بسیار مفید است.
چگونگی کارکرد #include
وقتی کامپایلر به #include <stdio.h> یا #include "myheader.h" میرسد، محتوای فایل مربوطه را جایگزین میکند. علامت <> برای فایلهای استاندارد سیستم (مانند /usr/include) استفاده میشود، در حالی که "" برای فایلهای محلی (در دایرکتوری فعلی) است.
جریان ادغام
پیشپردازنده فایل هدر را پیدا کرده، محتوای آن را کپی میکند و در کد منبع جایگذاری مینماید. اگر هدر شامل include دیگری باشد، این فرآیند بازگشتی ادامه مییابد. برای جلوگیری از ادغام تکراری، از گاردهای هدر استفاده میشود:
include کردن کتابخانههایی مانند stdio.h توابع ورودی/خروجی (مانند printf) را فراهم میکند. اما استفاده بیش از حد میتواند زمان کامپایل را افزایش دهد. کامپایلر مسیرهای جستجو را با فلگ -I مشخص میکند.
برای مثال، در کد ساده زیر:
#include <stdio.h>

int main() {
    printf("Hello, World!\n");
    return 0;
}
پیشپردازنده محتوای stdio.h را ادغام میکند، که شامل تعریف printf است.
نتیجهگیری
کامپایلر زبان C ابزاری قدرتمند است که کد انسانی را به دستورات ماشین تبدیل میکند، و درک جریان کاری آن – از پیشپردازش تا لینکینگ – برای هر برنامهنویسی ضروری است. با مدیریت ورودیها (کد منبع و فلگها) و خروجیها (فایلهای واسط و اجرایی)، و استفاده هوشمند از #include برای سازماندهی کد، میتوانید برنامههای کارآمد بسازید.
اگر تازهکار هستید، با GCC شروع کنید و مراحل را جداگانه آزمایش کنید. یادگیری این فرآیند نه تنها مهارتهای برنامهنویسی را تقویت میکند، بلکه به درک عمیقتری از سیستمهای کامپیوتری منجر میشود.
یکی از مهمترین کاربردهای HTML، ایجاد ساختار معنایی (semantic) است. تگهای معنایی مانند <header>، <nav> و <footer> نه تنها به سازماندهی محتوا کمک میکنند، بلکه برای موتورهای جستجو و ابزارهای دسترسیپذیری (مثل صفحهخوانها) مفیدند. این کار باعث میشود وبسایتها برای کاربران و رباتها قابل فهمتر باشند.
HTML همچنین در ایجاد اپلیکیشنهای وب، ایمیلهای HTML، و حتی اسناد دیجیتال مانند PDFهای تعاملی کاربرد دارد. با HTML5، امکان افزودن محتوای چندرسانهای (ویدئو و صدا) بدون نیاز به افزونههایی مانند Flash فراهم شد. همچنین، HTML در کنار CSS و جاوااسکریپت، برای ساخت وبسایتهای responsive که در دستگاههای مختلف به خوبی نمایش داده میشوند، ضروری است. به طور خلاصه، HTML زبان پایهای است که وب را به فضایی تعاملی و قابل دسترس تبدیل کرده است.
فریمورکها و ابزارهای HTML
HTML به تنهایی برای ایجاد ساختار کافی است، اما فریمورکها و ابزارها کار توسعه را سریعتر و کارآمدتر میکنند. این ابزارها معمولاً در کنار CSS و جاوااسکریپت استفاده میشوند، اما برخی مستقیماً به HTML مرتبطند یا فرآیند کار با آن را بهبود میدهند. در ادامه، چند مورد از مهمترین فریمورکها و ابزارهای مرتبط با HTML معرفی میشوند:
Bootstrap: فریمورکی که در سال ۲۰۱۱ توسط توییتر معرفی شد. اگرچه بیشتر به CSS معروف است، Bootstrap شامل قالبهای HTML آماده برای کامپوننتهایی مانند navbar، فرمها و دکمهها است که توسعه وبسایتهای responsive را تسریع میکند.
Tailwind CSS: این فریمورک utility-first که در سال ۲۰۱۷ منتشر شد، به توسعهدهندگان امکان میدهد با استفاده از کلاسهای آماده در HTML، استایلدهی را مستقیماً در کد HTML انجام دهند. این روش نیاز به نوشتن CSS جداگانه را کاهش میدهد.
Jekyll و Hugo: اینها ابزارهای تولیدکننده سایت استاتیک (Static Site Generators) هستند که از قالبهای HTML برای ایجاد وبسایتهای سریع و ساده استفاده میکنند. Jekyll در سال ۲۰۰۸ و Hugo در سال ۲۰۱۳ معرفی شدند و برای وبلاگها و سایتهای محتوامحور محبوباند.
React: کتابخانه جاوااسکریپت توسعهیافته توسط فیسبوک در سال ۲۰۱۳، که از JSX (ترکیبی از HTML و جاوااسکریپت) برای ساخت رابطهای کاربری پویا استفاده میکند. JSX به توسعهدهندگان اجازه میدهد کد HTML را درون جاوااسکریپت بنویسند.
Vue.js و Angular: این فریمورکهای جاوااسکریپت (به ترتیب از سالهای ۲۰۱۴ و ۲۰۱۶) از قالبهای HTML برای تعریف ساختار رابطهای کاربری استفاده میکنند. این ابزارها برای ساخت اپلیکیشنهای وب پیچیده مناسباند.
Pug (قبلاً Jade): یک موتور قالبسازی (Template Engine) که از سال ۲۰۱۰ وجود دارد. Pug سینتکس سادهتری برای نوشتن HTML ارائه میدهد که کد را کوتاهتر و خواناتر میکند و سپس به HTML استاندارد کامپایل میشود.
این فریمورکها و ابزارها به توسعهدهندگان کمک میکنند تا با HTML سریعتر و مؤثرتر کار کنند، بهویژه در پروژههای بزرگ یا زمانی که نیاز به رابطهای کاربری پیچیده است.
نتیجهگیری
HTML از یک زبان ساده برای به اشتراک گذاشتن اسناد علمی در دهه ۱۹۸۰ به پایهای برای وب مدرن تبدیل شده است. این زبان با فراهم کردن ساختار معنایی، امکان ایجاد وبسایتهای قابل دسترس و کاربرپسند را فراهم کرده است. فریمورکها و ابزارهایی مانند Bootstrap، React و Pug، کار با HTML را سریعتر و انعطافپذیرتر کردهاند. اگر میخواهید طراحی وب را شروع کنید، یادگیری HTML اولین قدم ضروری است. با HTML، میتوانید پایهای محکم برای خلق دنیای دیجیتال بسازید.
CSS برای طراحی responsive (واکنشگرا) هم حیاتی است. با استفاده از media queries، میتوانید استایلها را برای دستگاههای مختلف مانند موبایل یا دسکتاپ تنظیم کنید. همچنین، CSS دسترسیپذیری را بهبود میبخشد؛ مثلاً با تعریف استایلهای مناسب برای کاربرانی که از صفحهخوانها استفاده میکنند. علاوه بر وب، CSS در استایلدهی به اسناد XML، گرافیکهای SVG و حتی رابطهای کاربری ابزارکهای GTK کاربرد دارد. به طور خلاصه، CSS وب را کاربرپسندتر، زیباتر و منعطفتر کرده است.
فریمورکها و کتابخانههای CSS
CSS به تنهایی قدرتمند است، اما فریمورکها و کتابخانهها کار با آن را سریعتر و سادهتر کردهاند. این ابزارها مجموعهای از استایلهای آماده یا روشهای سازماندهی کد ارائه میدهند. در ادامه، به چند مورد از مهمترین فریمورکها و کتابخانههای CSS اشاره میکنیم:
Bootstrap: یکی از محبوبترین فریمورکهای CSS که توسط تیم توییتر در سال ۲۰۱۱ توسعه یافت. Bootstrap مجموعهای از کلاسهای آماده برای چیدمانهای گریدی، دکمهها، فرمها و کامپوننتهای responsive ارائه میدهد. این فریمورک برای توسعه سریع وبسایتهای مدرن بسیار مناسب است.
Tailwind CSS: یک فریمورک utility-first که در سال ۲۰۱۷ معرفی شد. به جای کلاسهای آماده برای کامپوننتها، Tailwind کلاسهای کوچک و کاربردی (مانند text-center یا p-4) ارائه میدهد که به شما امکان میدهد استایلها را مستقیماً در HTML اعمال کنید. این رویکرد انعطافپذیری بالایی دارد.
Foundation: فریمورکی از شرکت ZURB که از سال ۲۰۱۱ عرضه شد. Foundation بر طراحی responsive تمرکز دارد و ابزارهایی برای ساخت رابطهای کاربری پیچیده با کد تمیز ارائه میدهد. این فریمورک بیشتر برای پروژههای حرفهای مناسب است.
Bulma: یک فریمورک سبک و مدرن که از سال ۲۰۱۶ محبوب شد. Bulma بر سادگی و استفاده از Flexbox برای چیدمان تمرکز دارد و نیازی به جاوااسکریپت ندارد، که آن را برای پروژههای سبک مناسب میکند.
SASS و LESS: اینها پیشپردازندههای CSS هستند که قابلیتهایی مثل متغیرها، توابع و میکسینها را به CSS اضافه میکنند. SASS (از سال ۲۰۰۶) و LESS (از سال ۲۰۰۹) کد CSS را خواناتر و قابل مدیریتتر میکنند و در نهایت به CSS استاندارد کامپایل میشوند.
CSS-in-JS: رویکردی مدرن که در آن استایلها درون جاوااسکریپت نوشته میشوند، مانند کتابخانههایی مثل styled-components یا Emotion. این روش برای اپلیکیشنهای React بسیار محبوب است و امکان مدیریت دینامیک استایلها را فراهم میکند.
این فریمورکها و کتابخانهها به توسعهدهندگان کمک میکنند تا سریعتر و با کد کمتر، وبسایتهایی حرفهای بسازند. هر کدام برای نیازهای خاصی طراحی شدهاند، از پروژههای کوچک گرفته تا اپلیکیشنهای پیچیده.
نتیجهگیری
CSS از یک ایده ساده در دهه ۱۹۹۰ به ابزاری ضروری برای طراحی وب تبدیل شده است. با جداسازی محتوا از استایل، امکان طراحی وبسایتهای زیبا، responsive و کاربرپسند را فراهم کرده است. فریمورکها و کتابخانههایی مانند Bootstrap، Tailwind و Bulma، همراه با پیشپردازندههایی مثل SASS، CSS را به سطح جدیدی از کارایی و انعطافپذیری رساندهاند. اگر میخواهید وارد دنیای طراحی وب شوید، یادگیری CSS و ابزارهای مرتبطش نقطه شروع فوقالعادهای است.
{
  "name": "Ali",
  "age": 30,
  "married": true
}
۲. آرایه (array)
یک فهرست مرتب از مقادیر که بین [ ] قرار گرفتهاند.
["apple", "banana", "cherry"]
نوعهای داده در JSON
یک ارزش (value) در JSON میتواند یکی از موارد زیر باشد:
رشته (string): متنی بین "..." با یونیکد و پشتیبانی escape.
عدد (number): مشابه C یا Java، فقط به شکل اعشاری.
بولین (boolean):true یا false.
تهی (null): نشاندهنده نبود مقدار.
شیء یا آرایه: میتوانند بهصورت تو در تو باشند.
فضای خالی (whitespace) بین نشانهها مجاز است و تأثیری بر ساختار ندارد.
قواعد نگارش و سینتکس (Syntax)
یک object با { (آکولاد باز) شروع، و با } (آکولاد بسته) تمام میشود. در انتهای هر نام یک : (دو نقطه) قرار میگیرد و زوجهای نام/ارزش با , (ویرگول) جدا میشوند.
{ "a": 1, "b": 2 }
یک array با [ (براکت باز) شروع، و با ] (براکت بسته) تمام میشود. ارزشها توسط , (ویرگول) از هم جدا میشوند.
خوانایی بالا و شباهت زیاد به دیکشنری در زبانهای ساختیافته.
پشتیبانی گسترده در REST API، Ajax و ذخیرهسازی مرورگر.
تبادل داده سریع و سبک بین سرویسها.
محدودیتها
عدم پشتیبانی از کامنت، برخلاف JSON5 یا YAML.
قابلیت ذخیره فقط داده خام، نه کد یا تاریخچه.
مسائل امنیتی هنگام استفاده نادرست از eval() در JavaScript (باید از JSON.parse() استفاده شود).
نحوه استفاده در توسعه نرمافزار
خواندن (parse): تبدیل متن JSON به ساختار دادهای زبان مقصد (مثلاً json.loads() در Python).
نوشتن (serialize): تبدیل داده ساختارمند به متن JSON (مثلاً JSON.stringify() در JavaScript).
ارسال و دریافت از APIها: اغلب APIهای REST از JSON استفاده میکنند؛ معمولاً همراه با Content-Type: application/json.
خروجی: لیست فایلها با اطلاعاتی مثل اندازه و تاریخ.
۳. cd (تغییر مسیر)
برای جابهجایی بین پوشهها از cd استفاده کنید. مثلاً cd documents شما را به پوشه documents میبرد و cd .. یک قدم به عقب برمیگردد.
cd /var/log
مدیریت فایلها و پوشهها
۴. mkdir (ساخت پوشه)
این دستور برای ایجاد یک پوشه جدید استفاده میشود.
mkdir new_folder
۵. rm (حذف)
برای حذف فایل یا پوشه از rm استفاده کنید. برای حذف پوشهها، از rm -r استفاده کنید و برای ایمنی بیشتر، rm -i از شما تأیید میخواهد.
rm -r old_folder
۶. cp (کپی)
این دستور برای کپی کردن فایلها یا پوشهها به کار میرود. گزینه -r برای کپی کردن پوشهها لازم است.
cp file.txt /home/user/backup/
۷. mv (انتقال یا تغییر نام)
برای جابهجایی یا تغییر نام فایلها و پوشهها از mv استفاده کنید.
mv file.txt new_file.txt
مشاهده و ویرایش فایلها
۸. cat (نمایش محتوا)
این دستور محتوای یک فایل متنی را در ترمینال نمایش میدهد.
cat notes.txt
۹. nano یا vim (ویرایش فایل)
برای ویرایش فایلهای متنی، nano یک ویرایشگر ساده و کاربرپسند است. vim پیشرفتهتر است اما نیاز به یادگیری دارد.
nano config.txt
۱۰. less (مشاهده فایلهای بزرگ)
برای خواندن فایلهای طولانی بدون بههمریختگی، از less استفاده کنید. با کلید q از آن خارج میشوید.
less logfile.log
مدیریت سیستم و نرمافزارها
۱۱. apt یا yum (نصب و بهروزرسانی نرمافزار)
در توزیعهای مبتنی بر دبیان (مثل اوبونتو)، از apt برای نصب و مدیریت نرمافزارها استفاده کنید. در توزیعهای مبتنی بر رد هت (مثل CentOS)، yum یا dnf معادل آن است.
sudo apt update
sudo apt install python3
۱۲. ps (مشاهده پروسهها)
این دستور پروسههای در حال اجرا را نشان میدهد. گزینه ps aux اطلاعات کاملتری میدهد.
ps aux
۱۳. kill (متوقف کردن پروسه)
برای بستن یک برنامه یا پروسه گیرکرده، از kill به همراه شماره پروسه (PID) استفاده کنید.
kill 1234
کار با شبکه
۱۴. ping (بررسی اتصال)
این دستور بررسی میکند که آیا میتوانید به یک سرور یا وبسایت وصل شوید.
ping google.com
۱۵. wget یا curl (دانلود فایل)
برای دانلود فایل از اینترنت، wget یا curl ابزارهای قدرتمندی هستند.
wget https://example.com/file.zip
۱۶. ssh (اتصال امن)
برای اتصال به یک سرور دوردست، از ssh استفاده کنید. این دستور به پروتکل SSH که قبلاً توضیح دادیم وابسته است.
ssh user@192.168.1.100
ابزارهای پیشرفتهتر
۱۷. grep (جستجو در متن)
برای جستجوی یک عبارت خاص در فایلها یا خروجی دستورات، از grep استفاده کنید.
grep "error" logfile.log
۱۸. find (جستجوی فایل)
این دستور برای پیدا کردن فایلها بر اساس نام یا ویژگیها به کار میرود.
find /home -name "*.txt"
۱۹. df و du (مدیریت فضای دیسک)
df -h فضای خالی دیسک را نشان میدهد و du -sh اندازه یک پوشه را محاسبه میکند.
df -h
du -sh /var/log
۲۰. top یا htop (نظارت بر سیستم)
این دستورات منابع سیستم مثل CPU و رم را در لحظه نشان میدهند. htop کاربرپسندتر است اما ممکن است نیاز به نصب داشته باشد.
top
نکات تکمیلی برای استفاده از ترمینال
sudo: برای اجرای دستورات با دسترسی مدیر (root) از sudo استفاده کنید، اما مراقب باشید چون میتواند خطرناک باشد.
لولهکشی (|): با علامت | میتوانید خروجی یک دستور را به دستور دیگر بفرستید. مثلاً ls | grep txt فقط فایلهای با پسوند txt را نشان میدهد.
مانوالها: با دستور man (مثل man ls) میتوانید راهنمای هر دستور را بخوانید.
چرا این دستورات مهماند؟
این دستورات مثل کلیدهای یک جعبهابزار هستند که به شما قدرت کنترل کامل سیستم را میدهند. از مدیریت فایلها و نصب نرمافزار گرفته تا عیبیابی شبکه و سرور، این دستورات پایهای هستند که هر کاربر لینوکس باید بلد باشد. یادگیری آنها نهتنها کار با لینوکس را سادهتر میکند، بلکه به شما اعتمادبهنفس میدهد تا کارهای پیچیدهتری مثل مدیریت سرور یا اتوماسیون انجام دهید.
جمعبندی
ترمینال لینوکس قلب تپنده این سیستمعامل است. با یادگیری دستورات پایه مثل ls، cd و cp، مدیریت فایلها و پوشهها مثل آب خوردن میشود. دستورات شبکه مثل ping و ssh به شما کمک میکنند با دنیای بیرون ارتباط برقرار کنید، و ابزارهایی مثل grep و find برای جستجو و تحلیل دادهها عالی هستند.
اگر تازهکار هستید، از دستورات ساده شروع کنید و کمکم سراغ ابزارهای پیشرفتهتر بروید. ترمینال لینوکس مثل یک دوست وفادار است که هرچه بیشتر با آن کار کنید، بیشتر قدرتش را کشف میکنید!