# ساخت کامپایلر از سورس
./bazelw run --config=build-mojo KGEN:mojo -- run hello.mojo
# یا اگه فقط میخوای استفاده کنی، بدون build کردن کامپایلر:
# از فلگ prebuilt-mojo استفاده کن تا آخرین باینری nightly دانلود بشه
زمانبندی: چرا درست بعد از خرید Qualcomm
نکتهی جالبی که تقریباً همهی گزارشها روش تأکید کردن، زمانبندیه. Qualcomm خرید Modular رو ۲۹ جولای نهایی کرد؛ فقط سه هفته بعد، اولین حرکت بزرگ مالک جدید این بوده که کامپایلر رو کاملاً ببخشه. این تصمیم برای خیلیها غیرمنتظره بود، چون تاریخچهی Qualcomm تو متنباز چندان درخشان نیست، و بعضی تو کامیونیتی نگران بودن که خرید یه شرکت سازندهی چیپ، تعهد Modular به یه پلتفرم توسعهی خنثی از نظر vendor رو به خطر بندازه.
استدلال منطقی پشت این تصمیم اینه: هر ساعتی که یه توسعهدهنده صرف قفلشدن تو CUDA (اکوسیستم اختصاصی NVIDIA) میکنه، یه ساعتیه که تراشههای Qualcomm نمیتونن گزینهی رقیب باشن. باز کردن toolchain برای Qualcomm عملاً هزینهای نداشته (چون هیچوقت قرار نبوده از فروش لایسنس کامپایلر پول دربیاره)، ولی میتونه به پذیرش گستردهتر Mojo رو انواع سختافزار کمک کنه؛ از جمله سختافزار خود Qualcomm.
گسترهی سختافزاری: فراتر از NVIDIA
طبق اعلامهای ModCon، پلتفرم Modular (که Mojo موتور اصلیشه) الان از AWS Trainium و Google TPU هم پشتیبانی میکنه، علاوه بر GPU های NVIDIA، AMD، و Apple Silicon. حتی یه دمو رو یه شتابدهندهی چینی (Houmo، با ۲۴ گیگابایت حافظهی M.2) هم نشون داده شده. تراشههای خود Qualcomm (مثل Cloud AI 100 Ultra و Dragonfly) هم حالا هدف اولدرجهی این stack هستن. یه مقام از GV (سرمایهگذار وابسته به گوگل) این چشمانداز رو اینطور خلاصه کرده: «هر مدل هوش مصنوعی رو هر تراشهای اجرا کن.»
نکتهی مهم: MAX هنوز کاملاً باز نشده
یه تمایز مهم که نباید فراموشش کرد: Mojo (خود زبون و کامپایلر) کاملاً متنبازه، ولی MAX (لایهی بالاتر که مدلهای هوش مصنوعی رو serve و بهینه میکنه) فقط «source-available» شده، نه open source؛ یعنی میتونی کدش رو ببینی، ولی زیر یه لایسنس community با شرایط خاص (محدودیتهایی دربارهی telemetry، برندینگ، و ساختن جایگزینهای رقیب) قرار داره. طبق تحلیل Forbes، محدودیتهای قدیمی مبتنی بر تعداد دستگاه از MAX برداشته شده که پیشرفت واقعییه، ولی source-available با governance واقعی کامیونیتی فرق داره. ریسک بزرگتر هم اینه که Modular Cloud (لایهای که تصمیم میگیره workload ت رو کدوم تراشه اجرا بشه) کاملاً proprietary باقی مونده؛ یعنی Apache 2.0 فقط خود زبون رو محدود میکنه، نه ابر (cloud) بالادستیش.
پشتیبانی پلتفرم
Mojo فعلاً از macOS و لینوکس پشتیبانی میکنه. طبق اعلام Modular، دارن مستقیم با تیم ویندوز مایکروسافت همکاری میکنن تا Mojo رو بهصورت native (نه فقط از طریق WSL) به ویندوز بیارن؛ این یکی از پرتقاضاترین درخواستهای کامیونیتی Mojo بوده.
این برای توسعهدهندهها چه معنایی داره
اگه دنبال یه زبون سیستمی با سینتکس نزدیک به پایتون هستی که بتونه همزمان CPU، GPU، و شتابدهندههای AI رو با performance بالا هدف بگیره، Mojo حالا از هر نظر (نه فقط کتابخونه، بلکه کل زنجیرهی ساخت) قابل بازرسی و تغییره؛ چیزی که برای شرکتهایی که نگران قفلشدن تو یه vendor خاص (مثلاً NVIDIA/CUDA) هستن، جذابیت واقعی داره. با این حال، CUDA همچنان عمیقترین و جاافتادهترین toolchain مخصوص سختافزار NVIDIA است؛ یه دهه کتابخونه، پشتیبانی driver، و ابزار که Mojo قرار نیست یکشبه جایگزینش کنه. اگه پروژهت به ویندوز وابستهست، فعلاً باید صبر کنی تا پشتیبانی native تکمیل بشه.
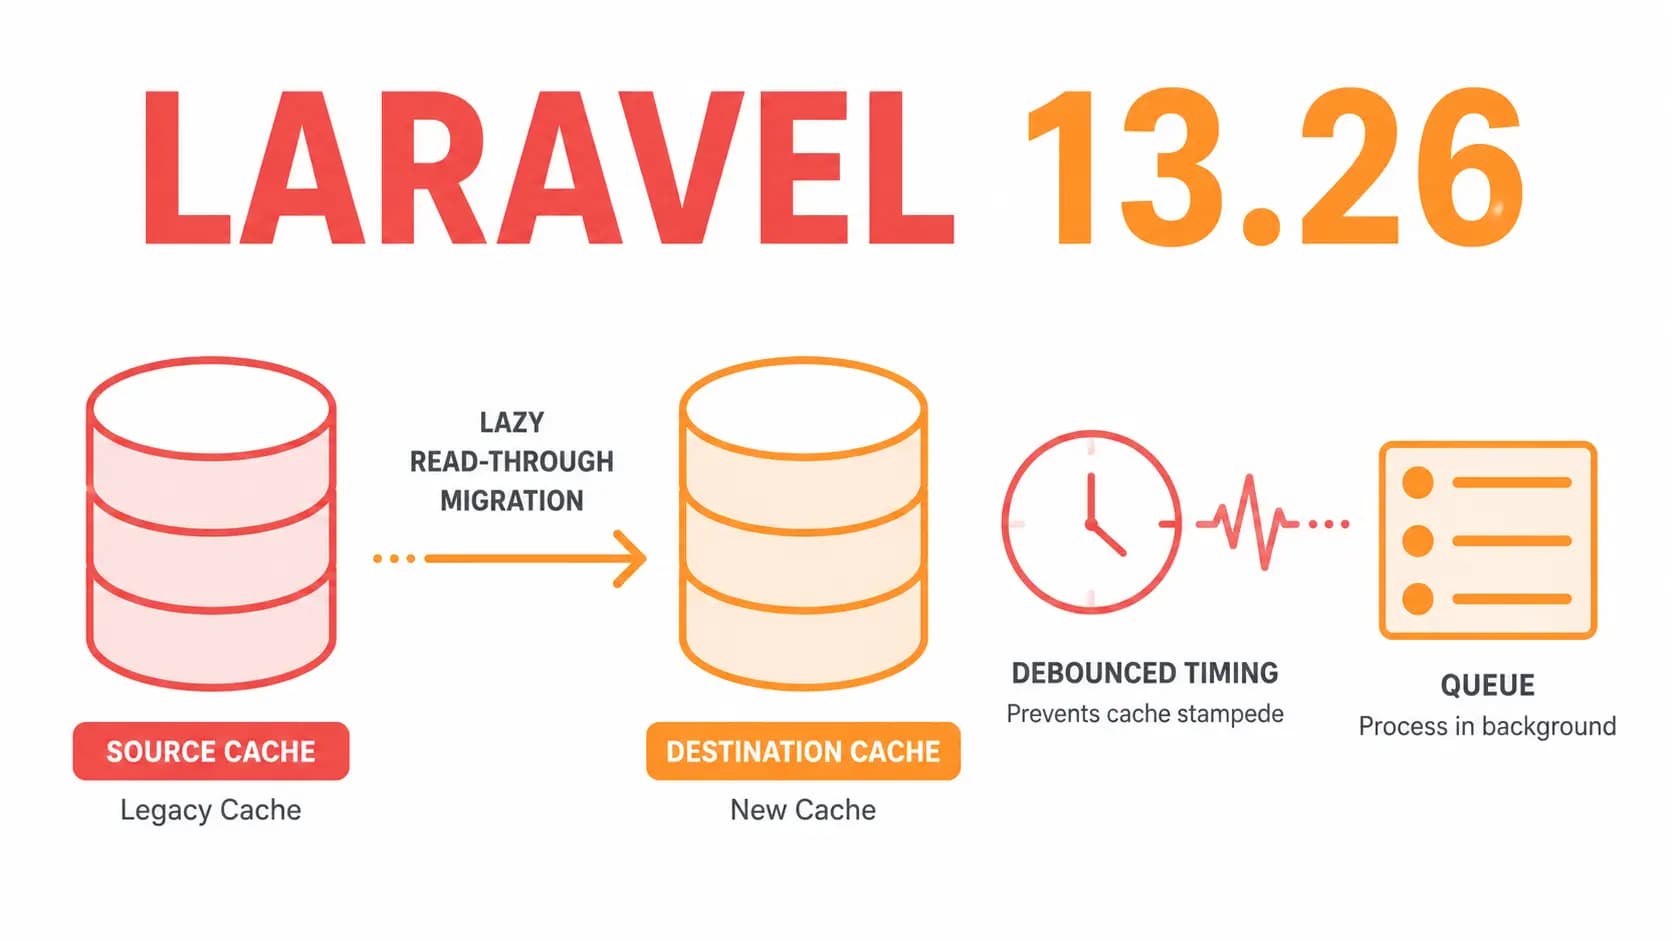
متد debounceId() مشخص میکنه این بازهی زمانی برای کدوم resource حساب بشه، و maxWait سقف میذاره که اگه event خیلی زیاد و پشتسرهم fire بشه، اجرای کار برای همیشه عقب نیفته. این debounce فقط رو همون listener اعمال میشه؛ بقیهی listener های همون event همچنان هر بار اجرا میشن. یه نکتهی مهم: یه listener که #[DebounceFor] داره، نمیتونه همزمان ShouldBeUnique رو implement کنه؛ dispatcher یه LogicException پرتاب میکنه، چون uniqueness اولین dispatch رو نگه میداره ولی debounce آخرین رو.
Queue::forward(): مسیردهی مجدد صف از یه نقطه
این متد جدید همهچیزی که به یه صف dispatch میشه رو به یه صف دیگه، یه connection دیگه، یا هر دو، منتقل میکنه؛ همهی اینها از یه نقطهی مرکزی تو service provider، بدون نیاز به تغییر کلاسهای job یا محلهای dispatch:
use Illuminate\Support\Facades\Queue;
Queue::forward('reports', 'reports.fifo', 'cloud'); // تغییر اسم و جابهجایی connection
Queue::forward('payments', connection: 'cloud'); // فقط جابهجایی connection
Queue::forward('updates', 'notifications'); // تغییر اسم رو همون connection
Queue::forward([
'reports' => 'reports.fifo',
'emails' => 'emails.fifo',
], connection: 'cloud');
این forward ها از همون hook ای که Queue::route() استفاده میکنه عبور میکنن، پس مهم نیست job از چه مسیری به صف میرسه؛ همیشه اعمال میشه.
بهبودهای Process
سه تا اضافهی مربوط به facade Process:
Process pool های iterable: قبلاً foreach روی ProcessPoolResults عملاً هیچی رو iterate نمیکرد (چون این کلاس هیچ پراپرتی public ای نداشت)، یعنی حلقهای که برای چک کردن exit code نوشته میشد، بیصدا هیچی رو چک نمیکرد. حالا هر دو کلاس IteratorAggregate رو implement میکنن.
Exception جدا برای idle timeout: یه idle timeout حالا ProcessIdleTimedOutException خودش رو پرتاب میکنه، جدا از ProcessTimedOutException:
try {
Process::timeout(600)->idleTimeout(30)->run('./deploy.sh');
} catch (ProcessIdleTimedOutException $e) {
// ۳۰ ثانیه هیچ خروجی نداشته: kill کن و هشدار بده
} catch (ProcessTimedOutException $e) {
// هنوز خروجی میده، فقط کنده: با زمان بیشتر دوباره امتحان کن
}
این تفکیک مهمه چون این دو حالت معنی کاملاً متفاوتی دارن: یکی یه پروسهی گیرکردهست، اون یکی فقط کنده.
Assertion های جدید برای Process fake:assertRanCount(2)، assertRanInOrder([...])، و متد recorded() برای فیلتر کردن جفتهای پروسه/نتیجهی ثبتشده با یه callback.
اضافات Eloquent Builder
orWhereKey() و orWhereKeyNot() به whereKey() اضافه شدن؛ جایگزین بهتری برای orWhereIn('id', ...) تو کوئریهایی که نیاز به شرط primary key تو یه شاخهی or دارن.
wherePivot() و orWherePivot() حالا یه closure قبول میکنن که یه builder scopeشده به مدل pivot بهش پاس میشه؛ یعنی scope های تعریفشده رو یه کلاس pivot سفارشی، مستقیم از کوئری رابطه قابلفراخوانی میشن.
inOrderOf() حالا enum ها رو تو لیست مقادیرش قبول میکنه.
یه event جدید به اسم JobReleased حالا موقعی که یه job از handler خودش یا از middleware ای مثل WithoutOverlapping به صف برگردونده میشه، fire میشه. تا قبل از این، JobReleasedAfterException فقط release هایی که بهخاطر throw شدن یه exception اتفاق میافتادن رو پوشش میداد؛ یعنی release ناشی از overlap کاملاً نامرئی بود.
Worker ها هم حالا وقتی صفی که ازش مصرف میکنن pause میشه، یه پیام تو خروجی چاپ میکنن، و همینطور وقتی resume میشه. از وقتی API پاز صف تو Laravel 13.25 اومد، یه worker پازشده فقط تولید خروجی رو متوقف میکرد و شبیه یه hang به نظر میرسید؛ این آپدیت این ابهام رو برطرف میکنه.
بقیهی رفع باگها و بهبودها
پشتیبانی از Guzzle 8 در کنار Guzzle 7.
دستور db:seed --class=SpecificSeeder حالا همون خروجی پیشرفت RUNNING/DONE رو نشون میده که seeder های تودرتو از قبل داشتن.
یه دسته بهبود امنیت/پایداری Redis: چکهای صف pauseشده دیگه رو کلاستر cross-slot read انجام نمیدن، pruning تگهای کش همهی master node ها رو اسکن میکنه و دیگه رو تگهای قدیمی loop بینهایت نمیزنه، یه pipeline یا transaction failشده اتصال رو قابلاستفاده نگه میداره.
درایور صف Cloud متد managedQueues() رو expose میکنه، و long-poll های timeoutشدهی cloud agent حالا retry میشن.
throwUnless() دیگه تو یه حالت خاص که باید throw میکرد، بیصدا هیچ کاری نمیکنه.
تنظیم readonly=false تو Microsoft SQL Server رعایت میشه، و quote های تکی تو attribute های JSON path پستگرس escape میشن.
نکات آپگرید
طبق اعلام رسمی، هیچ breaking change ای برای اپلیکیشنهای معمولی انتظار نمیره. فقط دو نکتهی ریز رو باید بدونی: یه listener که #[DebounceFor] داره، اگه همزمان ShouldBeUnique رو هم implement کنه، حالا یه LogicException میگیره؛ و internal های whereKey()/whereKeyNot() ادغام شدن، که فقط اگه Eloquent builder رو extend کرده باشی و این متدها رو override کرده باشی برات مهمه.
جمعبندی
اگه بخوایم Laravel 13.26 رو خلاصه کنیم: تمرکز اصلی رو مهاجرت تنبل بین storage ها (read-through disks)، کنترل بهتر روی صفها (debounce برای listener، forward برای مسیردهی مجدد، دیدهشدن بهتر worker)، و صیقل دادن جزئیات Process و Eloquent builder گذاشته. مثل چند نسخهی اخیر، آپگرید نسبتاً بیدردسره و میشه بدون نگرانی زیاد بهش رفت.
تضمین رسمی رفتار ManuallyDrop<Box<_>>
تو Rust 1.96، یه رفتار نامشخص (undefined behavior) مربوط به تعامل ManuallyDrop و Box رفع شده بود. تو این نسخه، مستندات رسمی آپدیت شده تا تضمین کنه این رفتار درست، برای همیشه پایدار میمونه؛ یعنی این دیگه یه رفع باگ ساده نیست، بلکه یه ضمانت رسمی و مستند از سمت زبونه (مرتبط با RFC 3336).
تغییرات زبانی
Lifetime shortening تو unsize coercion: حالا میشه lifetime یه &mut رو حتی تو موقعیت invariant، هنگام unsize-coercing کوتاه کرد. مثلاً میشه Cell<&'long mut i32> رو به Cell<&'short mut dyn Send> تبدیل کرد؛ این کوتاهسازی قبلاً فقط هنگام تبدیل &mut به &، یا & به & مجاز بود.
سختگیری بیشتر repr(transparent): این attribute حالا سختگیرتر شده دربارهی اینکه کدوم فیلدها layout «بیاهمیت» (trivial) دارن و میشه نادیدهشون گرفت؛ انواع repr(C)، انواع با فیلد خصوصی، و انواع #[non_exhaustive] دیگه trivial در نظر گرفته نمیشن.
لینتهای امنیتی جدید: یه لینت جدید deny-by-default به اسم invalid_runtime_symbol_definitions اضافه شده که فعلاً سمبلهای runtime اصلی مثل memcmp، memset، و strlen رو هدف میگیره (با برنامهریزی برای گسترش تو نسخههای بعدی). یه لینت warn-by-default هم به اسم c_void_returns اضافه شده که استفاده از core::ffi::c_void بهعنوان نوع بازگشتی رو چک میکنه.
API های جدید کتابخونهی استاندارد
چند تا API جدید هم پایدار شدن که ارزش دونستن دارن: str::substr_range و [T]::subslice_range (برای پیدا کردن محدودهی یه substring/subslice)، یه متد strip_circumfix برای هر دوی اینها، پیادهسازی Send و Sync برای std::process::CommandArgs، پارس کردن radix رو انواع NonZero، متدهای تبدیل lossy UTF-16 رو String، و چند تا کمککنندهی جدید برای mutation اتمیک. یه ماژول جدید به اسم std::range::legacy هم اضافه شده که برای نگهداری کدبیسهای قدیمیتر مفیده.
پلتفرمهای جدید
سه تا هدف جدید به لیست پلتفرمهای پشتیبانیشده اضافه شدن: ویژگیهای target d، e، و f تو RISC-V حالا تو cfg(target_feature = "?") پایدار شدن، و powerpc64-unknown-linux-gnuelfv2 و aarch64-unknown-linux-pauthtest هم بهعنوان هدف Tier 3 اضافه شدن.
نکتهی کوچیک ولی مهم برای نگهداری کد
یه نکتهی جالب اینه که ماکروی derive که تو {core,std}::derive در دسترسه، در واقع بهطور ناخواسته از نسخهی 1.96 پایدار شده بود، ولی حالا رسماً بهعنوان یه API پایدارشده پذیرفته شده. برای همین، حداقل نسخهی موردنیاز Rust (MSRV) برای این ماکرو، 1.96 است، نه 1.98؛ یه نکتهی ریز که موقع مستندسازی وابستگیهای پروژهت ارزش توجه داره.
چطور آپدیت کنیم
اگه از قبل Rust رو با rustup نصب کردی، آپدیت به این نسخه فقط یه دستوره:
rustup update stable
اگه تازهکاری، دستورالعمل نصب رو میتونی مستقیم از سایت رسمی Rust بگیری. برای دیدن کامل تغییرات کامپایلر، Cargo، و Clippy، بهتره یادداشتهای رسمی release رو رو گیتهاب چک کنی.
جمعبندی
Rust 1.98 نسخهاییه که تمرکز زیادی روی محاسبات عددی و performance گذاشته؛ متدهای algebraic برای اعشاریها و استانداردسازی سریالسازی عدد صحیح، هر دو مستقیم برای کدی که محاسبات سنگین یا حجم بالای تبدیل عدد به رشته داره مفیدن. تغییرات زبانی این نسخه هم بیشتر جنبهی سختگیری و ایمنسازی دارن (مثل repr(transparent) و لینتهای جدید) تا اضافه کردن قابلیتهای کاملاً جدید؛ یعنی برای اکثر پروژهها، آپگرید باید بدون درگیری خاصی پیش بره.
از نظر performance، سرعت Marshal تقریباً همسطح پیادهسازی قبلیه، ولی Unmarshal بهطور محسوسی سریعتر شده.
بهبودهای Runtime
تخصیص حافظهی سریعتر: کامپایلر حالا برای تخصیصهای کوچیک (زیر ۸۰ بایت)، فراخوانیهایی به روتینهای تخصیص size-specialized تولید میکنه؛ این کار هزینهی بعضی از این تخصیصها رو تا ۳۰ درصد کم میکنه. طبق گزارشها، بهبود کلی رو برنامههای واقعی و allocation-heavy حدود ۱ درصده، با هزینهی حدود ۶۰ کیلوبایت حجم اضافهی باینری.
پروفایل نشتی goroutine: قابلیتی که بهصورت آزمایشی تو Go 1.26 معرفی شده بود، حالا به یه پروفایل رسمی تبدیل شده. پکیج runtime/pprof الان یه پروفایل goroutineleak داره که با اجرای یه چرخهی garbage collection، goroutine هایی که برای همیشه بلاک شدن رو شناسایی میکنه؛ ابزار مفیدی برای دیباگ کردن نشتیهای goroutine تو production.
SIMD: از amd64 به arm64 و WebAssembly
پشتیبانی آزمایشی SIMD که از Go 1.26 تو پکیج simd/archsimd شروع شده بود، تو این نسخه گسترش پیدا کرده. علاوه بر بازنگری API مربوط به amd64، حالا از SIMD ۱۲۸ بیتی «Neon» رو arm64 و SIMD ۱۲۸ بیتی رو WebAssembly هم پشتیبانی میشه. این پکیج با فعال کردن متغیر محیطی GOEXPERIMENT=simd موقع build در دسترسه، ولی API ش هنوز پایدار در نظر گرفته نمیشه. یه پکیج جدید دیگه هم به اسم simd معرفی شده که پشتیبانی SIMD قابلحمل و مستقل از سایز بردار ارائه میده؛ رو سختافزارهایی که دسترسی دارن، به دستورات vector واقعی کامپایل میشه و رو بقیه، به emulation خالص Go برمیگرده.
کتابخونهی استاندارد: چند تا اضافهی کاربردی
پکیج uuid: حالا تولید و parse کردن UUID مستقیم تو کتابخونهی استاندارده؛ دیگه نیازی به یه dependency خارجی برای این کار رایج نیست.
crypto/mldsa: پشتیبانی از یه الگوریتم امضای دیجیتال پسا-کوانتومی (ML-DSA) به کتابخونهی استاندارد کریپتوگرافی اضافه شده؛ گامی مهم برای آمادهسازی کدبیسها در برابر تهدید کامپیوترهای کوانتومی.
CutLast: یه تابع جدید که یه slice بایت رو حول آخرین رخداد یه جداکننده برش میده (برخلاف Cut معمولی که اولین رخداد رو در نظر میگیره).
Toolchain و ابزارها
go mod tidy هوشمندتر: برای ماژولهایی که رو Go 1.27 یا بالاتر هستن، این دستور حالا بلوکهای require پراکنده رو تو دو بلوک استاندارد (یکی برای وابستگی مستقیم، یکی غیرمستقیم) ادغام میکنه، در حالی که کامنتهای ضمیمهشده رو هم حفظ میکنه.
go tool trace امنتر: وقتی فقط یه پورت مشخص کنی، رابط trace حالا فقط رو localhost گوش میده، هماهنگ با رفتار go tool pprof؛ برای گوش دادن گستردهتر، باید صراحتاً یه آدرس مشخص بدی.
حذف پشتیبانی Bazaar: دستور go دیگه از سیستم کنترل نسخهی Bazaar (bzr) پشتیبانی نمیکنه.
پشتیبانی Response file: ابزارهای compile، link، asm، cgo، cover، و pack حالا از response file (با فرمت سازگار با GCC) پشتیبانی میکنن؛ کمک بزرگی برای سیستمهای build ای که به محدودیت طول خط فرمان برخورد میکنن.
بهبودهای go fix: این دستور modernizer های جدیدی گرفته که کمک میکنن کد قدیمیتر رو به الگوهای مدرنتر Go آپدیت کنی.
تغییرات پلتفرم
طبق گزارشها، این نسخه الزامات پلتفرمی برای macOS رو هم تغییر داده (جزئیات دقیق تو یادداشتهای رسمی release اومده)، پس اگه رو مک کار میکنی، قبل از آپگرید، حتماً حداقل نسخهی موردنیاز رو چک کن.
چطور همین الان امتحانش کنیم
باینریها و نصبکنندههای Go 1.27 از صفحهی دانلود رسمی (go.dev/dl) در دسترسن. اگه از JetBrains GoLand استفاده میکنی، نسخهی 2026.2 همین الان از ویژگیهای زبانی جدید، modernizer های go fix، و پروفایل جدید goroutine leak پشتیبانی میکنه. تیم Go هم بیستوپنجم آگوست، از ساعت ۱۶:۰۰ تا ۱۷:۳۰ به وقت UTC، یه «Go 1.27 Release Party» آنلاین برگزار میکنه که میشه توش با جزئیات بیشتر این تغییرات آشنا شد.
جمعبندی
Go 1.27 با حدود ۱۶۰۰ کامیت بین این نسخه و Go 1.26، یکی از نسخههایییه که واقعاً چیزی فراتر از بهبودهای معمولی نگهداری داره. متدهای generic، نسل جدید JSON، و بهبود چشمگیر تخصیص حافظه، همه چیزهایی هستن که مستقیم رو کد روزمرهی خیلی از تیمها تأثیر میذارن. با این حال، بهخاطر تغییر پیشفرضهای سختگیرانهی JSON v2 (رد کردن UTF-8 نامعتبر و کلیدهای تکراری)، قبل از آپگرید پروژههای production، ارزش داره تستهات رو کامل اجرا کنی تا مطمئن بشی دادهی ورودیت با این استانداردهای جدید مشکلی نداره.
نگرانی جدی: بدون شرایط مشخص برای داده
مهمترین نکتهای که باید قبل از استفادهی جدی از Origin بهش توجه کنی، مربوط به دادهست. طبق گزارش TechTimes، Origin با enrollment بهصورت opt-out (نه opt-in) برای همهی کاربران پولی فعال شده؛ یعنی بهصورت پیشفرض روشنه، مگه اینکه ادمین سازمانت صراحتاً غیرفعالش کنه. در همون زمان انتشار، کرسر هیچ سند رسمیای دربارهی نگهداری داده (data retention)، افشای subprocessor ها، سیاست استفاده از کد برای آموزش مدل، یا ابزار migration برای کدهایی که مستقیم رو Origin هاست میشن منتشر نکرده بود.
این نگرانی برای تیمهایی که کد اختصاصی، دادهی شخصی کاربر تو فیکسچرهای تست، credential های احتمالی تو تاریخچهی commit، یا کدهای با محدودیتهای قانونی/رگولاتوری دارن، جدیتره؛ چون الان کدشون رو زیرساختی هاست میشه که متعلق به SpaceX است، بدون اینکه سیاست مشخصی دربارهی نحوهی استفاده از اون کد منتشر شده باشه.
دسترسی
Origin فقط برای پلنهای Pro، Teams، و Enterprise در دسترسه، نه پلن رایگان. برای سازمانهای Enterprise، ادمینها میتونن صراحتاً opt-out کنن. برای شروع، باید یه اسم codebase (namespace) رو claim کنی که فعلاً تو دورهی بتا قابل تغییر نیست، و بعد از اون میتونی ریپازیتوری جدید بسازی یا از طریق OAuth، ریپازیتوریهای گیتهابت رو sync کنی.
جمعبندی
Origin نشون میده کرسر (حالا زیر پرچم SpaceX) قصد داره فراتر از یه ادیتور کدنویسی بره و مستقیم وارد قلمروی زیرساخت توسعهی نرمافزار (همون چیزی که گیتهاب و گیتلب سالهاست توش تسلط دارن) بشه. برای تیمهایی که کاملاً درگیر اکوسیستم کرسر هستن و از agent های کدنویسی زیاد استفاده میکنن، یکپارچگی ریپازیتوری/PR/agent تو یه محیط واحد میتونه جذاب باشه. ولی با توجه به اینکه این محصول هنوز early beta است و مهمتر از همه، هیچ سند رسمیای دربارهی شرایط داده منتشر نشده، توصیه میشه قبل از هاست کردن کد حساس یا اختصاصی رو Origin، منتظر انتشار این سیاستها بمونی یا حداقل از تیم پشتیبانی کرسر مستقیم دربارهش سؤال کنی.
یکی از جذابترین بخشهای Wasp، مدل ارتباطی client-server شه. بهجای اینکه خودت endpoint بسازی و بعد جدا یه fetch call بنویسی، فقط یه تابع سرور رو تعریف میکنی و Wasp خودش یه hook تایپشده تو کلاینت تولید میکنه:
// سمت کلاینت: استفاده مستقیم، بدون نوشتن fetch یا API route
import { useQuery, getTasks } from 'wasp/client/operations';

function TaskList() {
  const { data: tasks, isLoading } = useQuery(getTasks);
  if (isLoading) return <div>در حال بارگذاری...</div>;
  return <ul>{tasks.map(t => <li key={t.id}>{t.description}</li>)}</ul>;
}
نکتهی مهم اینجاست که تایپهای TypeScript بین سرور و کلاینت بهصورت خودکار sync میشن؛ اگه ساختار دادهای که از سرور برمیگرده عوض بشه، همون لحظه تو کلاینت هم خطای type-check میگیری، بدون اینکه خودت مجبور باشی این هماهنگی رو دستی نگه داری.
قابلیتهای آماده که معمولاً باید خودت بسازی
Wasp خودش رو «batteries-included» معرفی میکنه، و این ادعا با فهرست قابلیتهاش پشتیبانی میشه:
Auth کامل: ایمیل/پسورد، گوگل، گیتهاب، اسلک، مایکروسافت، همه با پیکربندی چند خطی.
Background jobs: برای کارهایی که نباید request رو بلاک کنن.
ارسال ایمیل: بدون نیاز به تنظیم دستی SMTP یا SDK جدا.
Type-safety کامل full-stack: از دیتابیس تا کامپوننت React.
Deploy با یه دستور:wasp deploy میتونه اپ رو مستقیم رو زیرساختهای پشتیبانیشده بالا بیاره.
نکتهی مهم: بدون lock-in
برخلاف پلتفرمهایی مثل Firebase یا Supabase که کدت به سرویس اونا وابسته میشه، Wasp ادعا میکنه هیچ lock-in ای نداره. خروجی کامپایل، کد خام React و Node.js و Prisma است که میتونی مستقیم تو پوشهی .wasp/ ببینیش. یعنی اگه یه روز تصمیم گرفتی از Wasp CLI فاصله بگیری، کد تولیدشده رو برمیداری و مستقل ازش ادامه میدی؛ بدون runtime اختصاصی یا لایهی مخفی سمت سرور.
چرا این روزها خودش رو «فریمورک عصر AI» معرفی میکنه
نکتهی جالب اینه که Wasp این روزها تمرکز بازاریابیش رو گذاشته رو اینکه برای کدنویسی با agent های هوش مصنوعی بهینهست. استدلالشون اینه: چون Wasp یه توصیف سطحبالا و declarative از کل اپلیکیشن داره (نه هزاران فایل پراکندهی boilerplate)، یه agent کدنویس میتونه ساختار کامل اپ رو خیلی سریعتر «بفهمه» و تغییرات درستی اعمال کنه. خود پروژه یه سری plugin و skill هم برای ابزارهایی مثل Claude Code منتشر کرده که مستقیم دانش Wasp رو به agent اضافه میکنه.
جالبه که این رویکرد هیچ ارتباطی به یه provider خاص هوش مصنوعی نداره؛ Wasp خودش هیچ AI داخلی نداره و اگه بخوای یه ویژگی AI به اپت اضافه کنی (مثلاً چتبات)، باید مدل دلخواهت (OpenAI، آنتروپیک، یا یه مدل local) رو مثل یه dependency معمولی Node.js وصل کنی؛ چیزی که خودشون توش دخالتی ندارن.
کجا این فریمورک جای خودش رو پیدا میکنه
Wasp دقیقاً یه خلأ خاص رو پر میکنه: جایی بین انعطاف کامل ولی کاردستی Next.js یا Remix (که همهچیز رو خودت وایر میکنی)، و انتزاع بالا ولی وابستهبه-سرویس Firebase یا Supabase (که برای هر چیزی به یه پلتفرم شخص ثالث وابستهای). اگه دنبال یه تجربهی شبیه Rails یا Laravel هستی، ولی میخوای تو دنیای TypeScript و React بمونی، Wasp دقیقاً همین رو ارائه میده.
معایب و محدودیتها
طبیعتاً این سطح از انتزاع هزینه هم داره. اکوسیستم Wasp نسبت به Next.js یا حتی Nuxt خیلی کوچیکتره؛ تعداد پروژههای واقعی، منابع آموزشی، و توسعهدهندههای آشنا محدودتره. یادگیری DSL اختصاصیش هم یه گام اضافهست، هرچند سینتکسش نسبتاً سادهست. و چون فریمورک هنوز رسماً تو مرحلهی beta است (با اینکه برای ساخت بیش از ۵۰ هزار پروژه استفاده شده)، برای پروژههای خیلی بزرگمقیاس یا سازمانی، ممکنه بلوغ لازم رو نداشته باشه. علاوه بر این، طبیعت «opinionated» فریمورک یعنی برای اپلیکیشنهایی که ساختارشون خیلی از الگوی معمول CRUD/auth/jobs فاصله داره، ممکنه بیشتر از اینکه کمک کنه، محدودت کنه.
جمعبندی
اگه داری یه SaaS یا اپلیکیشن full-stack نسبتاً استاندارد میسازی (auth، دیتابیس، چند تا صفحه، شاید یه سری background job) و میخوای سریعتر از صفر شروع کنی، بدون اینکه هفتهها وقت صرف wiring کردن قطعات مختلف کنی، Wasp ارزش امتحان کردن داره؛ مخصوصاً که رایگان، متنباز، و بدون lock-in است. اگه پروژهت نیاز به کنترل خیلی دقیق روی هر جزئیات معماری داره، یا از قبل تیمی داری که با Next.js یا Nuxt راحته، احتمالاً همون مسیر آشناتر منطقیتره.
پایهی نظری: Metric First-Order Temporal Logic
از نظر فنی، Dogwood رو یه فرمالیسم از رشتهی runtime verification به اسم MFOTL (Metric First-Order Temporal Logic) ساخته شده. عملگرهایی که به Cedar اضافه میکنه شامل چیزهایی مثل formerly (چیزی قبلاً اتفاق افتاده؟)، count_within (چند بار تو یه بازهی زمانی؟)، count_distinct_within، و sum_within (مجموع یه مقدار تو یه بازه) هستن؛ دقیقاً همون عملگرهایی که برای بیان قوانین بالا لازمه.
ادغام با Amazon Bedrock AgentCore
Dogwood مستقیم پشت یه قابلیت جدید تو AgentCore Policy قرار گرفته؛ لایهای تو Amazon Bedrock AgentCore که مستقل از خود مدل عمل میکنه: مدل یه tool call رو پیشنهاد میده، policy engine قبولش میکنه یا ردش میکنه، و خود مدل هیچوقت مستقیم درگیر اجرای enforcement نمیشه. تا قبل از این، این چکها کاملاً stateless بودن؛ حالا با «temporal policies» که Dogwood قدرتش رو میده، این تصمیمات میتونن به تاریخچهی سشن agent هم نگاه کنن.
AWS همچنین یه ابزار به اسم Policy Authoring هم معرفی کرده که با هوش مصنوعی، سند policy نوشتهشده به زبون طبیعی رو مستقیم به قوانین Dogwood درست تبدیل میکنه؛ یعنی لازم نیست حتماً خودت سینتکس Dogwood رو یاد بگیری تا بتونی قوانین سازمانیت رو پیاده کنی.
چطور همین الان امتحانش کنیم
Dogwood زیر لایسنس Apache 2.0 منتشر شده و شامل یه راهنمای زبان و یه پیادهسازی مرجع (reference interpreter) روی گیتهابه. برای شروع:
git clone https://github.com/cedar-policy/dogwood
یه نمونهی خیلی ساده از یه قانون Dogwood که همون سناریوی پرداخت اول مقاله رو حل میکنه، تقریباً اینطور به نظر میرسه (بر پایهی گسترش Cedar):
یعنی پرداخت فقط زمانی مجازه که قبلش یه فاکتور برای همون resource ثبت شده باشه، و مجموع پرداختهای همون روز از یه سقف مشخص بیشتر نشه.
اگه از قبل رو Amazon Bedrock AgentCore کار میکنی، AgentCore Policy همین الان از Dogwood پشتیبانی میکنه و میتونی مستقیم ازش استفاده کنی. اگه رو یه استک دیگه کار میکنی، میتونی پیادهسازی مرجع رو مستقیم از گیتهاب بگیری و باهاش آزمایش کنی.
نکتهی مهم: هنوز برای production آماده نیست
خود AWS صراحتاً اعلام کرده که پیادهسازی مرجع Dogwood برای اکتشاف و تست طراحی شده، نه استفادهی production. اگه بخوای این رو تو یه محیط واقعی اجرا کنی، باید خودت چیزهایی مثل نگهداری قابلاعتماد تاریخچهی رویدادها، ایزولهسازی بین tenant های مختلف، و سیاست نگهداری داده رو پیادهسازی کنی؛ اینها جزو خود زبان یا reference interpreter نیستن.
چرا این موضوع مهمه
با گسترش استفاده از agent های خودمختار برای کارهای حساس (پرداخت، دسترسی به دادهی حساس، تغییرات زیرساختی)، مشکلی که Dogwood حلش میکنه دقیقاً همون چیزیه که این روزها تو خیلی از تیمهای مهندسی مطرحه: چطور میشه به یه agent اجازه داد کار واقعی انجام بده، بدون اینکه مجبور بشیم به کل هیستوری رفتارش اعتماد کورکورانه داشته باشیم؟ Dogwood با اضافه کردن حافظه به لایهی authorization (بدون از دست دادن قابلیتهای اثباتپذیر Cedar)، یه جواب مشخص و متنباز به این سؤال میده؛ و چون AWS از جامعه دعوت کرده که Dogwood رو تو محصولات و پروژههای خودشون هم بسازن، این رویکرد میتونه فراتر از خود AWS هم به یه استاندارد غیررسمی تبدیل بشه.
نتیجهی هر ارزیابی میتونه allow، deny، یا یه زنجیرهی پیچیدهتر شامل داور LLM یا تأیید انسانی (مثلاً از طریق Slack) باشه؛ یعنی برای عملیات پرریسک مثل kubectl delete pod، میشه درخواست رو متوقف کرد تا یه انسان تأییدش کنه.
مدیریت credential ها
یکی از نکات کلیدی طراحی اینه که credential های واقعی هیچوقت رو خود agent نمیشینن. Agent فقط یه placeholder میفرسته، و این gateway است که موقع عبور دادن ترافیک، توکن واقعی رو جایگزینش میکنه. یعنی حتی اگه agent کامل کنترل بشه یا لاگش لو بره، خود secret ها هیچوقت در معرض دید agent قرار نمیگیرن.
سه مدل استقرار
طبق ریپازیتوری رسمی گیتهاب، Claw Patrol سه شکل مختلف استقرار داره:
clawpatrol run: یه تونل مخصوص هر پروسه باز میکنه (رو لینوکس با netns، رو مک با NetworkExtension)؛ فقط ترافیک همون دستور wrapشده از gateway عبور میکنه.
clawpatrol join: یه تونل WireGuard کامل بالا میاره که کل ترافیک host رو مسیر میده.
clawpatrol gateway: خود proxy است؛ یه باینری تکی که HCL config رو لود میکنه و کلاینتها رو میپذیره.
میتونی هرکدوم از این سه شکل رو بسته به نیازت انتخاب کنی؛ لازم نیست همیشه کل host رو مسیر بدی.
چطور همین الان امتحانش کنیم
پروژه زیر لایسنس MIT منتشر شده و از طریق اسکریپت نصب خود پروژه یا از سورس (که نیاز به Go و Node.js داره) قابل بیلده. برای شروع:
# نصب سریع
curl -fsSL https://clawpatrol.dev/install.sh | sh

# یا از سورس (نیاز به Go و Node.js)
git clone https://github.com/denoland/clawpatrol
cd clawpatrol && make
بعد از نصب، یه فایل HCL برای قوانینت مینویسی (مثلاً بلاک کردن DROP TABLE رو یه دیتابیس خاص، یا نیاز به تأیید انسانی برای حذف پاد رو Kubernetes production)، و agent ت رو طوری تنظیم میکنی که ترافیکش از یکی از سه مسیر بالا عبور کنه. ابزار همچنین یه دستور clawpatrol test هم داره که میتونی قوانینت رو در برابر یه سری fixture (رکورد شده از دشبورد یا نوشتهشدهی دستی) تو CI تست کنی؛ اگه یه تغییر قانون، نتیجهی یه fixture رو عوض کنه، تست fail میشه و diff نشونت میده.
نکتهی مهم: هنوز alpha است
خود Deno صراحتاً اعلام کرده که Claw Patrol فعلاً alpha software است. پشتیبانی پروتکلها دقیقاً به اندازهی نیاز خود Deno گسترشه، نه بیشتر؛ اگه پروتکل خاصی میخوای که پشتیبانی نمیشه، باید یا خودت کدش رو اضافه کنی (مستندات کافی برای این کار هست)، یا از تیم Deno درخواست کنی. شرکت هم صراحتاً از جامعه خواسته که الگوهای قانوننویسی واقعی، پروتکلهای موردنیاز بعدی، و باگهای مسیر نصب رو گزارش بدن.
جمعبندی
اگه داری agent هایی میسازی که دسترسی نوشتنی به زیرساخت واقعی (دیتابیس، کلاستر، سرویسهای ابری) دارن، Claw Patrol یه لایهی امنیتی جدی و متنباز ارائه میده که فراتر از یه HTTP proxy ساده عمل میکنه؛ مخصوصاً به این خاطر که پروتکلهای غیر-HTTP رو هم میفهمه و credential های واقعی رو از دید خود agent مخفی نگه میداره. ولی چون هنوز alpha است، برای استفادهی production جدی، بهتره اول رو یه محیط تست یا staging امتحانش کنی و منتظر بلوغ بیشتر پروژه بمونی.
دسترسی و قیمت
Grok Bot فعلاً تو مرحلهی beta است و فقط برای مشترکین SuperGrok Heavy، Cursor Ultra، و Cursor Teams Premium در دسترسه؛ رو دسکتاپ (مک، ویندوز، لینوکس) و iOS، با اندروید که قراره بعداً اضافه بشه. مشتریان enterprise هم فعلاً باید تو یه لیست انتظار ثبتنام کنن. طبق گزارش Constellation Research، این سرویس از حدود ۱۲۰ دلار در ماه شروع میشه.
چرا الان و چرا اینقدر مهمه
با این انتشار، SpaceXAI رسماً وارد بازار agent های سازمانی میشه؛ بازاری که تا الان بیشتر تحت تسلط اوپنایآی و آنتروپیک بود. طبق گزارش Bloomberg، ایلان ماسک مستقیم تو ایکس اعلام کرده که بعد از رفع مشکلات اولیهی beta و انتشار Grok 4.6 (که قراره همون هفته بیاد)، مقیاس تست Grok Bot رو گسترش میده. این انتشار همزمان با تمرکز بیشتر SpaceX رو بخش enterprise تکنولوژی اتفاق افتاده؛ چیزی که تو گزارش سهماههی اخیر شرکت هم (چه دربارهی Cursor، چه دربارهی اتصال سازمانی از طریق Starlink) بهوضوح دیده میشه.
نگرانیهای امنیتی
طبق چند گزارش، از جمله Analytics Insight، این نوع دسترسی گسترده (login مستقیم به ابزارها و اطلاعات حساس شرکتی) نگرانیهای امنیتی جدیای هم به همراه داره؛ شرکتها احتمالاً قبل از اجازه دادن به اینجور bot ها برای دسترسی به اطلاعات حساس، به کنترلهای دسترسی سختگیرانهتری نیاز دارن. این دقیقاً همون چالشیه که هر ابزار agentic دیگهای هم که دسترسی وسیع به سیستمهای داخلی داره باهاش مواجهه.
جمعبندی
Grok Bot، مثل خیلی از محصولات agentic دیگهای که این روزها میبینیم، نشون میده صنعت هوش مصنوعی داره از مدل «سؤال و جواب ساده» به سمت «انجام کار واقعی و مستقل» حرکت میکنه. نکتهی مهمی که باید بهش توجه کرد اینه که این محصول هنوز تو مرحلهی early beta است، دسترسیش محدود به مشترکین پولی خاصیه، و مثل هر ابزار جدیدی که به سیستمهای حساس دسترسی میگیره، ارزش داره قبل از استفادهی جدی، سیاستهای امنیتی و کنترل دسترسیش رو دقیق بررسی کنی.
وقتی یه کاربر دیگه یه task جدید اضافه کنه، Collection سمت کلاینت بهصورت خودکار آپدیت میشه و کامپوننت React (به لطف useTracker) دوباره رندر میشه؛ همهی اینها بدون اینکه خودت مستقیم WebSocket handler بنویسی یا polling بزنی. این دقیقاً چیزیه که Meteor رو برای اپلیکیشنهای real-time (چت، داشبورد زنده، ابزارهای همکاری تیمی) جذاب میکنه.
MongoDB بهعنوان دیتابیس پیشفرض
Meteor از اول با MongoDB طراحی شده و این وابستگی عمیقه؛ نه یه انتخاب سطحی. سیستم reactivity، سینک شدن Collection ها بین سرور و کلاینت، و حتی امکان اجرای query های MongoDB مستقیم تو کلاینت (با یه minimongo که تو حافظهی مرورگر اجرا میشه)، همه بر پایهی مدل دادهی MongoDB ساخته شدن. اگه پروژهت نیاز به یه دیتابیس رابطهای مثل PostgreSQL داره، میشه با یهکم کار اضافه بهش وصلش کرد، ولی دیگه از خیلی از مزیتهای خودکار Meteor بیبهره میمونی.
مزیتها
سرعت توسعهی اولیه: برای پروتوتایپ کردن سریع یه اپ real-time، کمتر فریمورکی میتونه به سرعت Meteor برسه؛ چون خیلی از کارهایی که معمولاً باید دستی پیادهسازی کنی (WebSocket، sync داده، hot code push) از قبل آمادهست.
Hot code push: Meteor میتونه آپدیتهای جدید رو به کلاینتهای متصل، بدون نیاز به رفرش کامل صفحه، پوش کنه.
بستهبندی کامل: بیلد، bundling، و حتی deploy (با Galaxy، سرویس هاستینگ خود Meteor، یا Docker) همه از قبل تو اکوسیستم فریمورک هماهنگ شدن.
معایب و محدودیتها
وابستگی سنگین به MongoDB: اگه تیمت یا پروژهت به یه دیتابیس رابطهای نیاز داره، Meteor دیگه اون تجربهی یکپارچه رو نمیده.
اکوسیستم کوچیکتر و کمرونقتر: Meteor دیگه اون momentum اوایل دههی ۲۰۱۰ رو نداره. تعداد کتابخونهها، تعداد سؤالهای Stack Overflow، و تعداد پروژههای جدیدی که باهاش شروع میشن بهطور محسوسی از React یا Vue خام (چه برسه به Next.js یا Nuxt) کمتره.
سایز باندل کلاینت: بهخاطر minimongo و DDP client که باید رو مرورگر لود بشن، سایز باندل اولیهی Meteor معمولاً بزرگتر از یه اپ سادهی React یا Vue است.
منحنی یادگیری غیرمستقیم: مفاهیمی مثل Collection، publication/subscription، و method call (روش استاندارد Meteor برای mutation) یه مدل ذهنی جدا از چیزیه که تو REST یا GraphQL معمول یاد میگیری؛ یعنی دانشش کمتر قابلانتقاله به پروژههای دیگه.
کجا هنوز منطقیه
اگه داری یه اپ کاملاً real-time میسازی (مثل یه ابزار همکاری زنده، یه چت، یا یه داشبورد که باید فوری آپدیت بشه)، و مشکلی با MongoDB بهعنوان دیتابیس اصلی نداری، Meteor هنوز میتونه سرعت توسعهی بالایی بهت بده؛ خصوصاً برای تیمهای کوچیک یا MVP هایی که سرعت رسیدن به بازار مهمتر از انعطاف بلندمدت معماریه.
برای پروژههای عمومیتر که نیاز به real-time فوری ندارن، یا تیمت ترجیح میده از یه استک رابطهای و ابزارهای مدرنتر مثل Next.js یا Nuxt استفاده کنه، احتمالاً امروز گزینههای بهتری نسبت به Meteor پیدا میکنی؛ نه به این خاطر که Meteor بد شده، بلکه چون بقیهی اکوسیستم جاوااسکریپت از اون موقع بهطور قابلتوجهی رشد کرده و خیلی از ایدههای خوب Meteor (مثل full-stack بودن) رو به روشهای مدرنتری پیاده کردن.
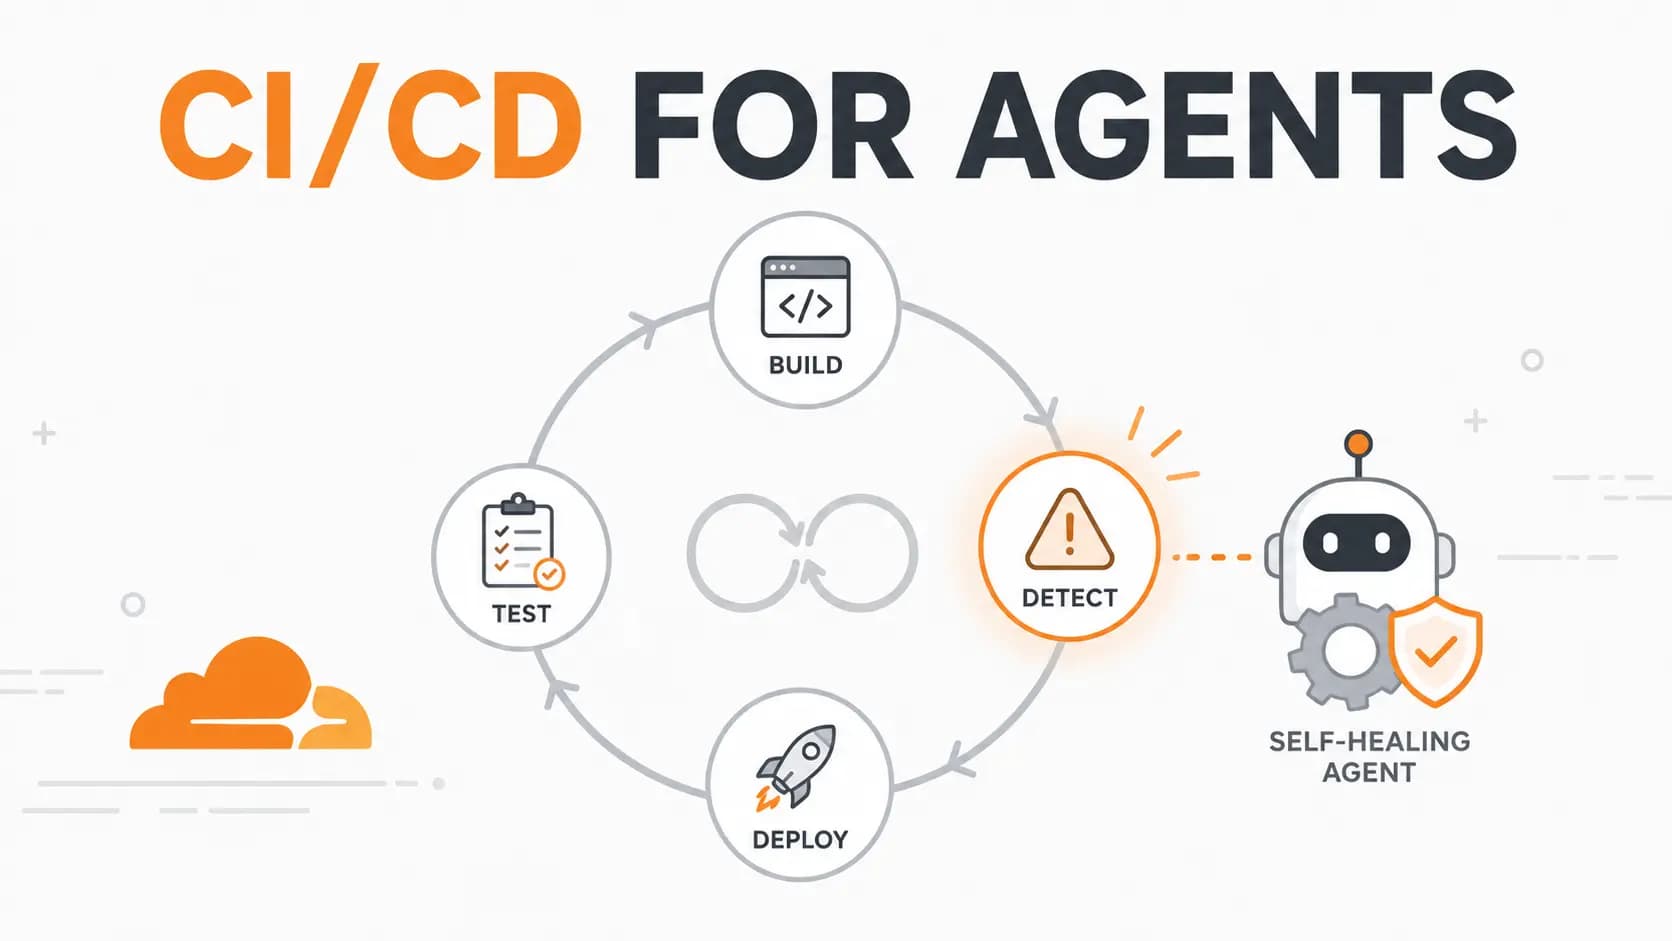
چون این پکیج مستقیم رو Cloudflare Workers اجرا میشه، نکتهی فنی مهمی داره: @cloudflare/ci یه پکیج معمولی Node.js نیست و مستقیم قابل اجرا نیست؛ باید با یه bundler آگاه به Workers (مثل Wrangler) استفاده بشه، و اگه از @cloudflare/ci/worker استفاده میکنی، باید فلگ سازگاری nodejs_compat رو فعال کنی.
بخشی از یه اکوسیستم بزرگتر
@cloudflare/ci بهتنهایی منتشر نشده؛ بخشی از یه دسته کامل از ابزارهای جدیده که کلادفلر همزمان معرفی کرده تا کل چرخهی SDLC (برنامهریزی، طراحی، پیادهسازی، تست، دیپلوی، نگهداری، بازنشستگی) رو برای agent ها قابل مدیریت کنه:
OpenTelemetry traces تو dev محلی؛ که یعنی agent همون سطح observability که تو production داره رو موقع توسعهی محلی هم داره؛ مستقیم تو Wrangler و Vite plugin کلادفلر.
Cloudflare Agents و Agent Traces؛ یه فضای جدید برای مشاهده، نگهداری، و بهبود agent ها، بر پایهی trace های OpenTelemetry.
تجربهی داخلی کلادفلر از اجرای استانداردهای مهندسی با هوش مصنوعی رو تمام ریپازیتوریها و specification هاشون.
تجربهی ساخت یه «کارخانهی نرمافزار» که تعداد issue های باز پروژهی Astro رو به صفر رسونده؛ یه سیستم خودکار برای triage، بازتولید، تأیید، و رفع مشکلات.
نکتهی معماری: Workflow بهجای YAML خطی
استدلال فنی کلادفلر اینه که یه pipeline CI/CD کلاسیک، صرفاً یه مورد خاص از یه Workflow عمومیه؛ ولی خود Workflow میتونه خیلی فراتر از این بره. تو مثال دیگهای که تو پست رسمی اومده، یه Workflow میتونه یافتههای روزانه رو جمع کنه، یه agent رو با اون context صدا بزنه، منتظر جوابش بمونه، و بر اساس نتیجه تصمیم بگیره — همهچیز تحت کنترل کامل خود Workflow، نه یه اسکریپت خطی که فقط دستورات رو پشت سر هم اجرا میکنه.
جدول کامل: کدوم ابزار کلادفلر کدوم مرحله رو پوشش میده
طبق جدولی که خود کلادفلر منتشر کرده، مراحل مختلف SDLC حالا اینطور روی ابزارهای کلادفلر map میشن:
برنامهریزی/طراحی/پیادهسازی: Vite، Rolldown، و Oxc (زنجیرهابزار سریع)، dev محلی که دقیقاً همون runtime production رو شبیهسازی میکنه، Local Explorer و Local Traces، remote bindings، و Preview URL برای هر pull request.
تست: Browser Run (مرورگرهای headless قابلبرنامهریزی تو کلاود) و پشتیبانی از Vitest مستقیم تو runtime خود Workers.
دیپلوی: Flagship (فیچر فلگ خودکار برای هر تغییر) و Gradual Deployments (رولاوت تدریجی).
نگهداری/بازنشستگی: Workers Logs (برای اینکه agent بتونه لاگ زنده رو دنبال کنه)، Agent Traces، Cloudflare MCP Server، و Analytics Engine.
این برای توسعهدهندهها چه معنایی داره
اگه از قبل رو Cloudflare Workers کار میکنی، @cloudflare/ci یه راه بومی برای ساختن pipeline هایی میده که فراتر از یه سری دستور خطی هستن؛ میتونن خودشون رو self-heal کنن و در صورت نیاز، کارهای پیچیدهتر رو به یه agent جدا بسپرن. ولی نکتهی مهم اینه که این ابزار، مثل خیلی از قابلیتهای جدید کلادفلر، عمیقاً به اکوسیستم خودشون (Workers، Workflows، Wrangler) وابستهست؛ یعنی اگه رو یه پلتفرم دیگه host میکنی، این ابزار برات مستقیماً قابل استفاده نیست.
کلادفلر خودش هم اعتراف میکنه که این فقط شروع کاره؛ به قول خودشون «primitive» های لازم الان در دسترسن، ولی کار زیادی برای اتصال کامل این قطعات به هم و یادگیری از تجربهی واقعی هنوز باقی مونده.
.cs
dotnet reference
publish کردن container حالا runtime های native پلتفرم رو ترجیح میده.
سیشارپ
از نظر زبانی، چهار تا ویژگی مهم اضافه شده:
break و continue با برچسب (labeled)؛ یعنی میشه مشخص کرد کدوم حلقه از چند تا حلقهی تودرتو باید break یا continue بشه، بدون نیاز به flag های دستی.
الگوهای union (union pattern) حالا هم خود union و هم مقدار داخلیش رو match میکنن.
بهبود exhaustiveness checking برای type parameter هایی که به یه closed type محدود شدن.
تغییراتی تو «Unsafe Evolution»؛ شامل یه حالت سازگاری (compat mode) و رفتار nameof تو کد unsafe.
ASP.NET Core
بخش Blazor بیشترین تغییرات رو گرفته:
توقف خودکار circuit های Blazor موقع بیفعالیتی؛ که مصرف منابع سرور رو برای سشنهای رهاشده کاهش میده.
یه ویژگی جدید به اسم CacheView برای کش کردن خروجی Blazor SSR.
چند تا analyzer جدید برای Blazor که مشکلات رایج رو زودتر گزارش میکنن.
QuickGrid حالا InitialItemIndex و ScrollToItemAsync رو پشتیبانی میکنه؛ یعنی کنترل بهتری رو موقعیت اسکرول و آیتم اولیهی grid داری.
ابزار wasm-tools به Emscripten 6 آپدیت شده.
علاوه بر این، Razor حالا attribute های literal رو برای پارامترهای کامپوننت از نوع union قبول میکنه، validation localization بهصورت built-in اضافه شده، کلاینت SignalR .NET حالا بعد از redirect هم میتونه auth رو refresh کنه، و OpenAPI پشتیبانی از Server-Sent Events تو نسخهی OpenAPI 3.2 رو گرفته.
.NET MAUI
چند تا قابلیت جدید و کاربردی:
احراز هویت با passkey بهصورت cross-platform؛ یعنی دیگه لازم نیست پیادهسازی جدا برای هر پلتفرم بنویسی.
XAML Incremental Hot Reload؛ که سرعت دیدن تغییرات UI موقع توسعه رو بهبود میده.
الگوهای route جدید برای Shell.
binding های RelativeSource که با AOT سازگارن.
پشتیبانی از backend های platform-specific شخص ثالث.
TabbedPage حالا رو پلتفرمهای اپل از همون معماری handler استفاده میکنه که بقیهی کنترلها استفاده میکنن.
Entity Framework Core
بهبودهایی تو ترجمهی کوئری LINQ، بهبود provider مربوط به Azure Cosmos DB، بهبود migration ها، و پشتیبانی از نوع Half رو SQLite اضافه شده.
افشارپ
چهار تا بهبود کوچیکتر ولی مفید: binding های computation expression حالا داخل یه let ساده هم کار میکنن، attribute ها داخل ماژولها و namespace های recursive درست resolve میشن، پیام تشخیصی واضحتری برای type abbreviation های generic اضافه شده، و یه باگ مربوط به محاسبهی سایز StructLayout برای union های struct بدون داده رفع شده.
Windows Forms
تمرکز این بخش رو Dark Mode بوده؛ پنج تا pull request مستقیم به بهبود ظاهر تو حالت تاریک اختصاص داشته (شامل ToolTip، HelpProvider، LinkLabel، TabControl تودرتو، و آیکونهای چک تو ToolStrip). علاوه بر این:
یه حالت اختیاری جدید به اسم VisualStylesMode برای شخصیسازی بیشتر ظاهر کنترلها.
جلوگیری از فلاش سفید موقع باز شدن فرمها تو dark mode، با تأخیر انداختن نمایش فرم تا زمانی که استایلها اعمال بشن.
توقف رندر موقع تغییرات دستهای (bulk) رو کنترلها، مثل تغییر همزمان موقعیت و سایز.
ظاهر toggle-switch برای CheckBox و RadioButton.
رفع چند باگ پایداری، شامل یه کرش GDI+ تو SplitContainer و یه exception تو اسکرول ToolStrip.
این preview تو چه فضایی منتشر شده
نکتهی جالب اینه که واکنش جامعهی توسعهدهندهها به کل چرخهی .NET 11 (نه فقط این preview) صرفاً مثبت نبوده. بعضی توسعهدهندهها نسبت به افزایش پیچیدگی زبان سیشارپ و سرعت انتشار نسخههای بزرگ ابراز نگرانی کردن. همچنین، نقشهی راه ASP.NET Core تو .NET 11 تمرکز زیادی رو «Agentic AI» گذاشته (از جمله پشتیبانی از Model Context Protocol تا اپلیکیشنهای .NET بتونن بهعنوان ابزار برای agent های هوش مصنوعی عمل کنن)؛ جهتی که بعضی توسعهدهندهها معتقدن داره روی نیازهای اصلی و پایهای framework سایه میندازه.
چطور امتحانش کنیم
برای شروع، کافیه SDK نسخهی .NET 11 رو نصب کنی. اگه رو ویندوز با Visual Studio کار میکنی، مایکروسافت توصیه میکنه از آخرین نسخهی Visual Studio 2026 Insiders استفاده کنی؛ از Visual Studio Code هم با extension مربوط به C# Dev Kit میشه استفاده کرد. یادت باشه این هنوز preview است، نه نسخهی نهایی، پس برای production حتماً صبر کن تا نسخهی پایدار نوامبر منتشر بشه؛ ولی برای آشنایی زودهنگام با تغییرات و کاهش ریسک آپدیت آینده، امتحانش کردنش الان ارزش داره.
ذکر نشده
لایسنس
MIT
MIT
زبان پیادهسازی
TypeScript / Next.js
JavaScript
نکتهی مهم دربارهی این جدول: بخش زیادیش (مخصوصاً اعداد OmniRoute) از صفحهی مقایسهی رسمی خود سایت OmniRoute اومده، که طبیعتاً به نفع خودشه. برای همین اعداد 9Router رو از منابع مستقل (Medium، AIMojo، EveryDev.ai، NGJOO) کراسچک کردم تا تصویر متوازنتری داشته باشیم، ولی بازم توصیه میشه قبل از تصمیم نهایی، خودت این دو تا رو مستقیم امتحان کنی.
کجا هرکدوم برندهست
9Router برای سادگی و تمرکز: اگه فقط میخوای مشکل rate limit حل بشه و یه ابزار سبک، ساده، و بدون قابلیتهای اضافهی پیچیده میخوای، 9Router دقیقاً همین رو ارائه میده. سطح پیچیدگیش کمتره و برای شروع سریع مناسبتره.
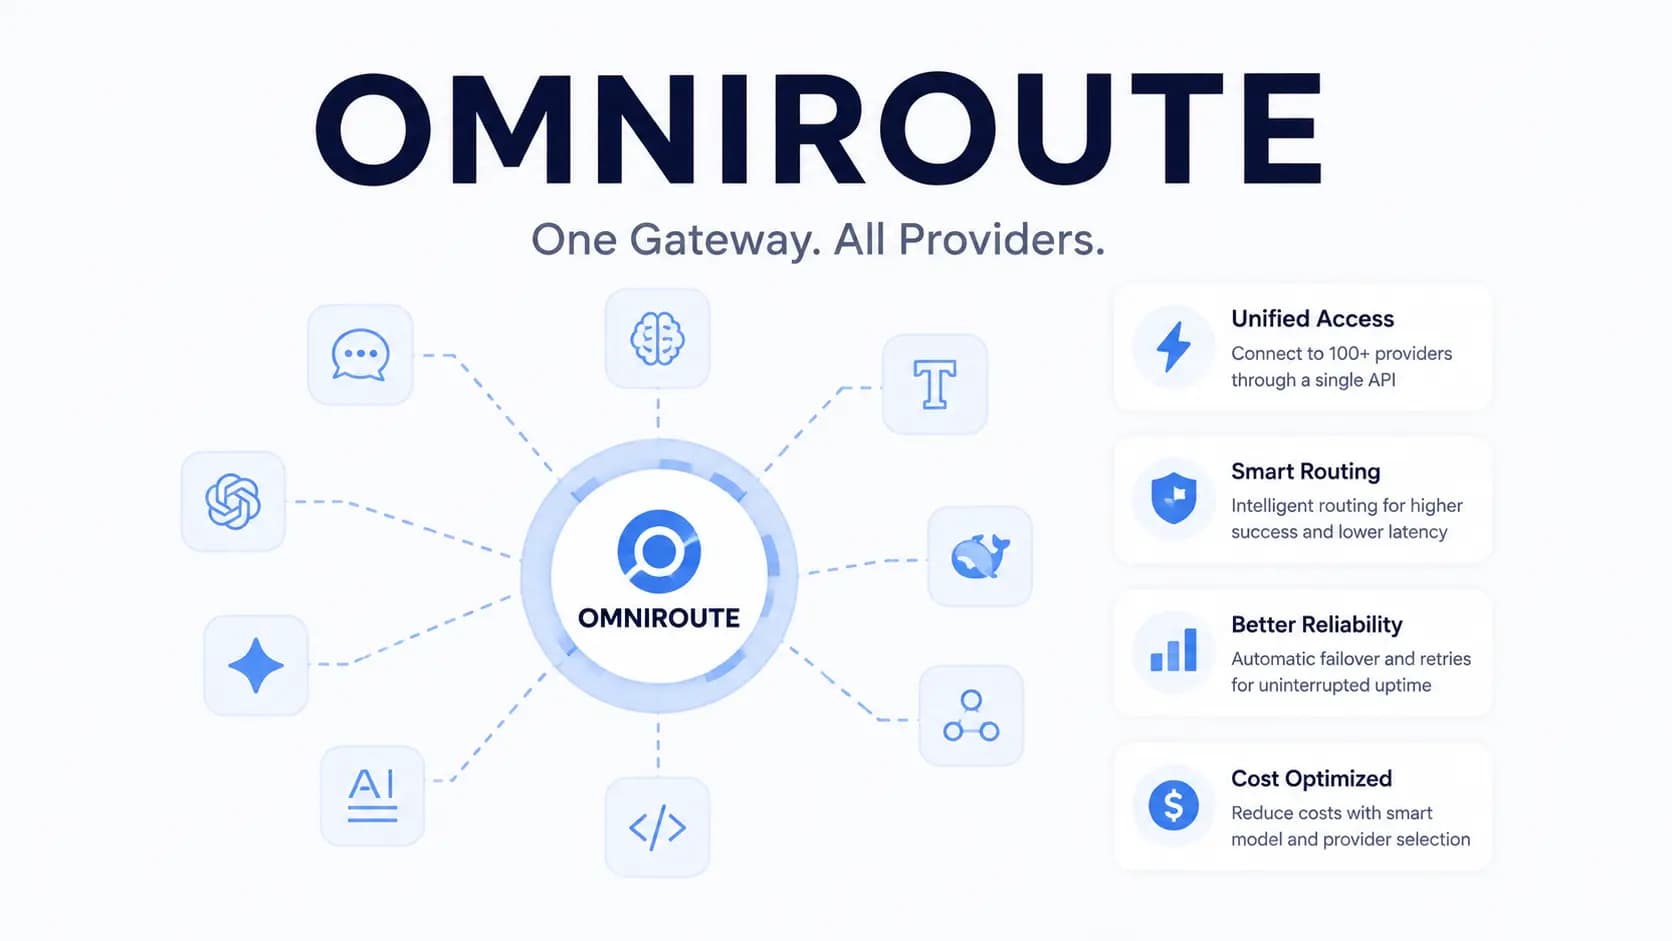
OmniRoute برای دامنهی وسیعتر: اگه علاوه بر routing، به قابلیتهایی مثل MCP server (که خود gateway رو به یه ابزار قابلکنترل توسط agent تبدیل میکنه)، A2A، یا حافظهی مکالمه هم نیاز داری، OmniRoute دامنهی گستردهتری داره. تعداد provider هاش هم بهطور محسوسی بیشتره (۳۳۹ در مقابل حدود ۴۰ تا ۶۰).
نکتهی مشترک قبل از استفادهی جدی
هر دو ابزار، صرفنظر از اینکه کدومش رو انتخاب کنی، یه ویژگی مشترک مهم دارن که باید بهش توجه کنی: مسیر کردن ترافیک از طریق این gateway ها، پردازش یا شرایط استفادهی provider اصلی (مثل اوپنایآی یا آنتروپیک) رو حذف نمیکنه؛ فقط یه لایهی اضافه بین تو و اون provider اضافه میکنن. همچنین، هر دو تبدیل به یه نقطهی حیاتی تو مسیر درخواستهات میشن؛ اگه gateway از کار بیفته یا تنظیماتش خراب بشه، همهی ابزارهایی که ازش عبور میکنن تحت تأثیر قرار میگیرن. برای استفادهی جدی یا تیمی، حتماً به فکر بکآپ تنظیمات و یه plan B (برگشت مستقیم به provider اصلی در صورت قطعی gateway) باش.
جمعبندی
اگه اولویتت سادگی و یه راهحل تمرکزیافته برای مشکل rate limit است، 9Router انتخاب سبکترییه. اگه دنبال یه پلتفرم کاملتر با تعداد provider بیشتر و قابلیتهای اضافه مثل MCP و A2A هستی، و راحتی با پیچیدگی بیشتر مشکلی نداری، OmniRoute گزینهی جامعتریه. چون هر دو رایگان و متنبازن، عملاً هیچ هزینهای برای امتحان کردن هر دوشون و دیدن اینکه کدوم با workflow خودت بهتر جفت میشه نداری.
فشردهسازی توکن: با ترکیب چند تا موتور فشردهسازی (که خودشون بهش میگن RTK و Caveman)، خروجی ابزارها و context تکراری رو قبل از رسیدن به مدل فشرده میکنه؛ طبق ادعای پروژه، بین ۱۵ تا ۹۵ درصد صرفهجویی تو مصرف توکن، بسته به نوع کار.
استفاده از quota رایگان: پروژه ادعا میکنه بیش از ۹۰ provider با پلن رایگان رو ردیابی میکنه و مصرف رایگان رو بهصورت pool-deduped (بدون شمارش تکراری) جمع میزنه؛ رقمی که خودشون حدود ۱.۵ میلیارد توکن رایگان در ماه اعلام میکنن.
پشتیبانی از MCP و A2A: خود gateway بهعنوان یه سرور MCP هم عمل میکنه (بیش از ۱۰۰ ابزار در قالب چند ده scope)، و از پروتکل A2A هم پشتیبانی میکنه؛ یعنی یه agent میتونه مستقیم خود OmniRoute رو بهعنوان یه ابزار کنترل کنه، نه فقط ازش عبور کنه.
نکتهی مهم قبل از استفادهی جدی
قبل از اینکه این ابزار رو رو یه workflow حساس یا production تکیه بدی، چند تا نکته رو باید در نظر بگیری. اول، مسیر کردن ترافیک از طریق gateway خودت، پردازش، شرایط استفاده، یا نگهداری دادهی provider اصلی رو حذف نمیکنه؛ دادهت هنوز به همون provider (مثلاً OpenAI یا آنتروپیک) میرسه، فقط از یه لایهی اضافه عبور کرده. دوم، این ابزار خودش یه نقطهی حیاتی تو مسیر درخواستهات میشه؛ اگه down بشه، تنظیماتش خراب بشه، یا دیتابیس local ش (SQLite) کرش کنه، همهی ابزارهایی که ازش عبور میکنن تحت تأثیر قرار میگیرن. برای همین، برای استفادهی جدی، حتماً باید persistence، بکآپ، و کنترل دسترسی مناسب رو خودت تنظیم کنی.
یه نکتهی دیگه هم اینه که چون این پروژه خیلی تازه و بهشدت پرتغییره (۲۷۱ نسخه تو کمتر از چهار ماه)، بهتره قبل از هر آپدیت، یه نسخهی مشخص رو pin کنی و رفتار ابزارهای کدنویسیت رو (streaming، tool call، context طولانی) بعد از هر آپدیت جدا تست کنی، نه اینکه فقط بر اساس لیست مدلها قضاوت کنی که همهچیز درست کار میکنه.
جمعبندی
اگه خسته شدی از مدیریت دستی چند تا کلید API و برخورد مکرر با rate limit وسط کار، OmniRoute یه راهحل عملی و رایگانه که با یه دستور نصب میشه و تقریباً با هر ابزار agentic معروفی (Claude Code، Cursor، Codex، Cline، Copilot) سازگاره. ولی برای پروژههای production یا تیمی، بهتره اول یه دورهی ارزیابی جدی (تست کیفیت پاسخ، latency، failover واقعی) قبل از تکیهی کامل روش انجام بدی؛ چون production-ready بودن این ابزار، بیشتر به تنظیمات و تستهای خودت بستگی داره تا صرفاً نصب و راهاندازیش.