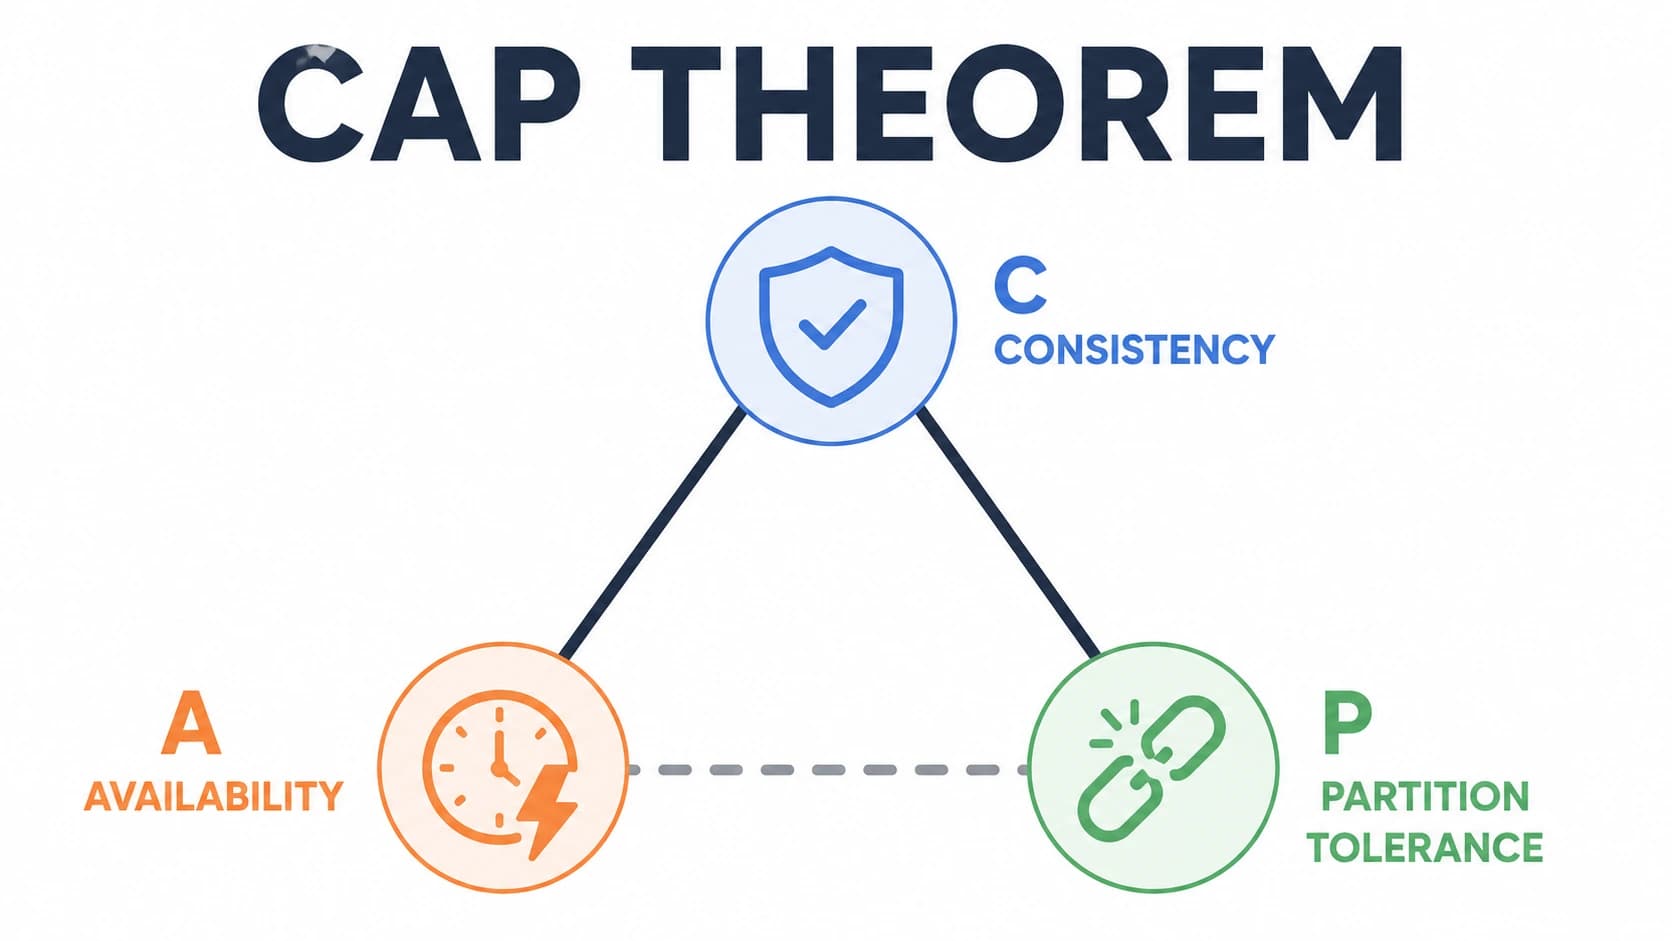
قضیهی CAP (که اریک برور اولین بار مطرحش کرد) میگه یه سیستم دیتابیس توزیعشده، وقتی network partition اتفاق میافته (یعنی ارتباط بین بخشی از node ها قطع میشه)، فقط میتونه یکی از این دو تا رو تضمین کنه، نه هر دو رو با هم:
Consistency: هر خواندنی، آخرین نوشتهی موفق رو برمیگردونه. یعنی همهی node ها همیشه یه نسخهی یکسان و بهروز از داده رو نشون میدن.
Availability: هر درخواستی (چه خواندن، چه نوشتن) یه جواب دریافت میکنه، حتی اگه بعضی node ها از کار افتاده باشن. سیستم هیچوقت با یه خطا جواب رد نمیده.
ضلع سومِ قضیه، Partition tolerance است: توانایی سیستم برای ادامهی کار حتی وقتی شبکه بین node ها قطع میشه. نکتهی مهم اینجاست که partition tolerance تو دنیای واقعی یه انتخاب نیست؛ شبکه دیر یا زود قطع میشه، پس هر سیستم توزیعشدهی واقعی باید partition tolerant باشه. این یعنی انتخاب واقعی همیشه بین C و A است، نه بین سهتا گزینه.
یعنی چی وقتی partition اتفاق میافته؟
فرض کن یه کلاستر سهnode ای داری و ارتباط شبکه بین node یک با node های دو و سه قطع میشه. حالا دو گروه جدا از هم داری. وقتی یه کلاینت به node یک درخواست نوشتن میفرسته، دو مسیر پیش رو داری:
اگه سیستم انتخاب کنه Consistency رو حفظ کنه (CP)، node یک باید درخواست رو رد کنه یا صبر کنه، چون نمیتونه مطمئن بشه node های دیگه هم همین مقدار رو دارن. کاربر یه خطا میگیره، ولی داده هیچوقت inconsistent نمیشه.
اگه سیستم انتخاب کنه Availability رو حفظ کنه (AP)، node یک همون لحظه به کاربر جواب میده و نوشتن رو قبول میکنه، حتی اگه ندونه node های دیگه چه مقداری دارن. بعداً وقتی partition برطرف شد، سیستم باید یه مکانیزم برای reconcile کردن این تناقضها داشته باشه (مثلاً last-write-wins یا vector clocks).
مهمه که این رو از شاردینگ جدا کنی. توی شاردینگ، هر سرور فقط بخشی از داده رو داره. توی ریپلیکیشن، هر سرور (یا حداقل هر replica) یک کپی کامل از کل داده رو نگه میداره. این دو تکنیک هدف متفاوتی دارن و معمولاً با هم ترکیب میشن، نه جایگزین همدیگه.
چرا ریپلیکیشن میخوایم
دو دلیل اصلی برای ریپلیکیشن وجود داره، و هر کدوم مسئلهی متفاوتی رو حل میکنن.
اول، دسترسپذیری بالا (high availability). اگه سرور اصلی (که بهش primary یا master میگن) از کار بیفته، یکی از replica ها میتونه جاش رو بگیره و نقش primary جدید رو بازی کنه، بدون اینکه سرویس کامل قطع بشه. به این فرآیند failover میگن.
دوم، توزیع بار خواندن. توی خیلی از اپلیکیشنها، تعداد خواندن (SELECT) خیلی بیشتر از نوشتن (INSERT/UPDATE) است. اگه همهی این خواندنها روی همون یک سرور primary انجام بشه، اون سرور زیر فشار میمونه. با ریپلیکیشن میتونی خواندنها رو بین چند replica پخش کنی و فقط نوشتنها رو روی primary نگه داری — الگویی که بهش read/write splitting میگن.
چطور داده از primary به replica میرسه
مکانیزم رایج این است که primary هر تغییری که روی دادهاش اعمال میشه رو توی یک لاگ ترتیبی ثبت میکنه — توی PostgreSQL بهش WAL (Write-Ahead Log) میگن، توی MySQL بهش binlog. هر replica این لاگ رو از primary میخونه و همون تغییرات رو دقیقاً به همون ترتیب روی نسخهی خودش اعمال میکنه. یعنی replica عملاً داره یک تاریخچهی کامل از هر اتفاقی که روی primary افتاده رو دنبال میکنه و بازش تولید میکنه.
sync در مقابل async: معاملهای که باید آگاهانه انتخابش کنی
اینجا یکی از مهمترین تصمیمهای طراحی توی ریپلیکیشن پیش میاد: وقتی یک نوشتن روی primary اتفاق میافته، آیا باید صبر کنه تا replica هم همون نوشتن رو تأیید کنه، یا میتونه بدون منتظر موندن به کلاینت جواب «موفق» بده؟
محدودیت نرخ پیام برای کاربران رایگان، سالها یکی از اصلیترین دلایلی بود که کاربران معمولی رو به سمت خرید اشتراک Plus سوق میداد. برداشتن این محدودیت برای متن، بهطور مستقیم همون اصطکاکی رو کم میکنه که کاربران سنگین رایگان باهاش مواجه بودن. با توجه به اینکه چت متنی ساده، بخش اصلی استفادهی اکثر کاربران ChatGPT رو تشکیل میده، این تصمیم میتونه باعث بشه کاربران بیشتری، بدون نیاز به خرید اشتراک، درگیر پلتفرم بمونن.
تو نسخهی دوم، اضافه کردن یه نوع تخفیف جدید یعنی فقط یه کلاس جدید نوشتن، بدون اینکه به تابع اصلی دست بزنی. این دقیقاً همون چیزیه که ریسک شکستن رفتار قدیمی رو کم میکنه.
L — Liskov Substitution Principle
این اصل میگه هر جا که یه کلاس پایه استفاده میشه، باید بشه بهجاش از هر کدوم از زیرکلاسهاش استفاده کرد، بدون اینکه رفتار برنامه خراب بشه. مثال معروفش مشکل مربع و مستطیله:
class Rectangle:
    def set_width(self, w): self.width = w
    def set_height(self, h): self.height = h
    def area(self): return self.width * self.height

class Square(Rectangle):
    def set_width(self, w):
        self.width = w
        self.height = w  # چون مربعه، عرض و ارتفاع باید برابر بمونن
    def set_height(self, h):
        self.width = h
        self.height = h
از نظر ریاضی، مربع نوع خاصی از مستطیله، ولی از نظر رفتار برنامه، Square قرارداد Rectangle رو نقض میکنه؛ چون تغییر عرض بهطور غیرمنتظره ارتفاع رو هم تغییر میده. اگه یه تابع فرض کنه با set_width فقط عرض عوض میشه و ارتفاع دستنخورده میمونه، وقتی همون تابع با یه Square صدا زده بشه، رفتار غلطی میگیره. این مثال نشون میده که ارثبری باید بر اساس رفتار طراحی بشه، نه صرفاً بر اساس رابطهی مفهومی «این یه نوع از اونه».
I — Interface Segregation Principle
این اصل میگه هیچ کلاسی نباید مجبور بشه به متدهایی وابسته باشه که ازشون استفاده نمیکنه. تصور کن یه interface بزرگ برای Worker داری:
class Worker:
    def work(self): raise NotImplementedError
    def eat(self): raise NotImplementedError
اگه بخوای یه RobotWorker بسازی، مجبوری متد eat رو هم پیادهسازی کنی، در حالی که هیچ معنایی برای یه ربات نداره. راهحل اینه که این interface بزرگ رو به دو تا interface کوچیکتر بشکنیم: Workable و Eatable، و هر کلاس فقط اونی رو implement کنه که واقعاً بهش نیاز داره. این اصل خیلی وقتها تو زبانهایی مثل جاوا یا TypeScript که interface صریح دارن پررنگتره، ولی همون فلسفه تو پایتون هم با duck typing و ترکیب کلاسهای کوچیکتر قابل اعماله.
D — Dependency Inversion Principle
این اصل میگه ماژولهای سطح بالا نباید مستقیم به ماژولهای سطح پایین وابسته باشن؛ هر دو باید به یه abstraction وابسته باشن. مثال رایجش وابستگی مستقیم به یه دیتابیس خاصه:
# طراحی بد
class UserService:
def __init__(self):
self.db = MySQLDatabase() # وابستگی سخت به یه پیادهسازی خاص
# طراحی خوب
class UserService:
def __init__(self, db: DatabaseInterface):
self.db = db # هر چیزی که این interface رو implement کنه قابل تزریقه
با نسخهی دوم، میتونی بهراحتی تو تستها یه mock database تزریق کنی، یا بعداً از MySQL به PostgreSQL سوییچ کنی، بدون اینکه خط به خط UserService رو تغییر بدی. این همون ایدهای هست که پشت dependency injection تو فریمورکهایی مثل Spring یا NestJS قرار داره.
کی این اصول رو کنار بذاریم
نکتهای که خیلی وقتها نادیده گرفته میشه اینه که SOLID برای کدی طراحی شده که قراره رشد کنه و تغییر کنه. اگه داری یه اسکریپت یکبار مصرف مینویسی یا یه پروتوتایپ سریع میسازی، رعایت سفتوسخت این اصول فقط پیچیدگی اضافه میکنه بدون اینکه فایدهی واقعی داشته باشه. مثلاً درست کردن یه abstraction برای یه دیتابیسی که مطمئنی هیچوقت عوض نمیشه، فقط یه لایهی اضافهی بدون کاربرده.
قانونی که خودم بهش رسیدم اینه: این اصول رو وقتی جدی بگیر که کدت داره به یه نقطهای میرسه که هر تغییر کوچیک، چند جای دیگه رو هم میشکنه، یا وقتی داری چیزی میسازی که میدونی قراره تو آینده گسترش پیدا کنه. تا اون موقع، ساده نوشتن معمولاً بهتر از over-engineering کردنه.
Build سریعتر
Type checking سریعتر
SSR سریعتر
درخواستهای کمتر برای Prefetch
Cache بهتر برای فایلهای استاتیک
یعنی حتی اگر هیچکدام از قابلیتهای جدید را استفاده نکنی، باز هم احتمالاً تفاوت را حس میکنی.
Turbopack حالا تا ۹۰٪ حافظهی کمتری مصرف میکند
یکی از بزرگترین تغییرات Next.js 16.3 مربوط به Turbopack است.
تا قبل از این نسخه، یکی از شکایتهای رایج دربارهی dev server پروژههای بزرگ، مصرف بالای حافظه بود.
روی یک پروژهی کوچک شاید متوجه نشوی، اما وقتی پروژه چند صد Route، تعداد زیادی dependency و فایلهای زیاد دارد، مصرف RAM میتواند خیلی سریع بالا برود.
در Next.js 16.3 دو قابلیت مهم بهصورت پیشفرض فعال شدهاند:
Disk Cache برای توسعه
Memory Eviction
ترکیب این دو باعث شده Turbopack بتواند بهتر تصمیم بگیرد چه چیزهایی را در حافظه نگه دارد و چه چیزهایی را از RAM خارج کند.
البته مثل همیشه این عددها را نباید کورکورانه برای همهی پروژهها انتظار داشت. نوع پروژه، تعداد Routeها، dependencyها و نحوهی استفاده از Server Componentها تأثیر زیادی دارند.
اما جهت تغییر مشخص است: Turbopack دیگر فقط دنبال سریعتر شدن نیست، بلکه میخواهد در پروژههای واقعی منابع کمتری مصرف کند.
به نظر من این یکی از آن تغییراتی است که توسعهدهندههایی که لپتاپ معمولی دارند بیشتر از همه حسش میکنند.
چون سریع بودن فقط این نیست که یک build چند ثانیه زودتر تمام شود؛ اگر سیستم وسط کار شروع کند به swap کردن و کند شدن، آن سرعت روی کاغذ چندان کاربردی نیست.
Buildهای سریعتر با FileSystem Cache
همان Cacheای که از Next.js 16.1 برای dev معرفی شده بود، حالا وارد مرحلهی بعدی شده و برای next build هم فعال شده است.
ایده ساده است:
اگر قبلاً چیزی محاسبه شده و هنوز معتبر است، دوباره از صفر انجامش نده.
این موضوع مخصوصاً در CI مهم است.
در پروژههایی که مرتب build میشوند، زمان زیادی صرف کارهای تکراری میشود. حالا Turbopack میتواند بخشی از این خروجیها را ذخیره کند و در buildهای بعدی دوباره استفاده کند.
طبق تستهای تیم Next.js، بعضی پروژهها در CI تا ۵.۵ برابر build سریعتر داشتهاند.
این تغییر برای تیمهایی که روزانه چندین deploy انجام میدهند، شاید از هر قابلیت ظاهری دیگری مهمتر باشد.
چون چند ثانیه در یک build شاید مهم نباشد، اما وقتی صدها بار تکرار میشود، تبدیل به زمان واقعی تیم میشود.
TypeScript 7 و Type Checking سریعتر
Next.js 16.3 همزمان با نسل جدید TypeScript آمده است.
TypeScript 7 یک تغییر مهم دارد: بخشهایی از آن با یک پیادهسازی Native بازنویسی شده که هدفش سرعت بالاتر در type checking است.
طبق اعلام تیم TypeScript، این نسخه میتواند در بعضی سناریوها چند برابر سریعتر باشد.
برای استفاده از آن در پروژهی Next.js کافی است نسخهی dependency را تغییر بدهی:
npm i -D typescript@^7
البته اینجا یک نکته وجود دارد.
سرعت بالاتر همیشه به معنی این نیست که همهی پروژهها دقیقاً همان نتیجه را میبینند. پروژههایی با Type پیچیده، monorepoها یا dependencyهای سنگین ممکن است تفاوت بیشتری حس کنند.
اما برای پروژههایی که TypeScript بخش بزرگی از زمان build را میگیرد، این تغییر ارزش بررسی دارد.
رندر سمت سرور سریعتر با Native Node.js Streams
یکی از تغییرات فنی جالب Next.js 16.3 در لایهی رندرینگ App Router اتفاق افتاده است.
برای اینکه مرورگر بتواند محتوا را بهصورت تدریجی دریافت کند، Next.js از Streamها استفاده میکند. این مدل باعث میشود لازم نباشد کاربر تا آماده شدن کل صفحه صبر کند و بخشهای آمادهشده زودتر ارسال شوند.
اما یک مشکل وجود داشت.
در محیط Node.js، Streamهای داخلی Node با Web Streams که در استانداردهای جدید وب استفاده میشوند، یکسان نیستند. در نتیجه بخشی از زمان و منابع صرف تبدیل بین این دو مدل میشد.
در Next.js 16.3 این مسیر تغییر کرده و در لایهی رندرینگ App Router از Native Node.js Streams استفاده میشود.
نتیجه؟
کاهش overhead در SSR.
طبق بنچمارکهای تیم Next.js، اپلیکیشنها در شرایط بار بالا میتوانند تا ۲۲٪ درخواست بیشتری را با همان شرایط پردازش کنند.
یعنی:
وضعیت
عنوان
توضیح
قبل
Web Streams
Baseline
بعد
Native Node.js Streams
+22% Requests
این تغییر شاید چیزی نباشد که هنگام توسعهی روزمره فوراً ببینی، اما روی سرویسهایی که ترافیک بالا دارند، تفاوتش خودش را نشان میدهد.
این هم از آن دسته تغییراتی است که معمولاً کاربران متوجه وجودش نمیشوند؛ فقط متوجه میشوند سایت در فشار بالا بهتر دوام میآورد.
مستندات نسخهبندیشده برای AI Agentها
یکی از مسیرهایی که Next.js در نسخههای جدید جدیتر دنبال میکند، آماده کردن پروژهها برای ابزارهای هوش مصنوعی است.
چند سال پیش اگر کسی میگفت فریمورک باید برای AI Agentها بهینه شود، احتمالاً خیلیها تصور میکردند منظور فقط autocomplete داخل ادیتور است.
اما الان موضوع بزرگتر شده.
Agentها قرار است کد بخوانند، تغییر بدهند، تست اجرا کنند و حتی تصمیمهای معماری پیشنهاد کنند.
مشکل اینجاست که یک Agent بدون اطلاعات کافی دربارهی پروژه، ممکن است تصمیمهایی بگیرد که با ساختار پروژه هماهنگ نیست.
مثلاً:
از API اشتباه استفاده کند.
الگوی قدیمی پروژه را نادیده بگیرد.
قوانین داخلی تیم را رعایت نکند.
Next.js 16.3 با اضافه کردن پشتیبانی بهتر برای Versioned Docs این مسیر را سادهتر میکند.
ایده این است که Agent بتواند به اطلاعات دقیقتر و هماهنگ با نسخهی مورد استفادهی پروژه دسترسی داشته باشد.
یعنی اگر پروژه روی Next.js 16.3 است، Agent لازم نیست از اطلاعات مربوط به نسخههای قدیمیتر استفاده کند.
این تغییر شاید امروز برای همه ضروری نباشد، اما اگر با ابزارهایی مثل Cursor، Claude Code یا Agentهای مشابه کار میکنی، اهمیتش بیشتر میشود.
درخواستهای Prefetch کمتر، کنترل بهتر روی شبکه
یکی از بخشهایی که در Next.js همیشه بین سرعت و مصرف منابع تعادل ایجاد میکرد، Prefetch بود.
Prefetch یعنی قبل از اینکه کاربر روی یک لینک کلیک کند، Next.js حدس بزند که احتمالاً کاربر به آن صفحه میرود و بخشی از اطلاعات را از قبل دریافت کند.
این کار باعث Navigation سریعتر میشود.
اما یک مشکل دارد.
اگر تعداد لینکها زیاد باشد، ممکن است درخواستهای زیادی ایجاد شود؛ حتی برای صفحاتی که کاربر هیچوقت باز نمیکند.
در Next.js 16.3 رفتار Prefetch بهینهتر شده تا درخواستهای غیرضروری کمتر شوند.
هدف این نیست که Prefetch حذف شود؛ چون هنوز یکی از دلایل اصلی حس سریع بودن Next.js است.
هدف این است که هوشمندتر عمل کند.
یعنی:
اطلاعات مهم زودتر آماده شوند.
درخواستهای بیمصرف کمتر شوند.
فشار روی سرور و شبکه کاهش پیدا کند.
Cache بهتر برای Static Assetها
فایلهای استاتیک مثل:
تصویرها
فایلهای CSS
JavaScript bundleها
فونتها
معمولاً باید مدت زیادی Cache شوند.
اما تنظیمات اشتباه Cache میتواند مشکلساز شود.
اگر خیلی کوتاه باشد، کاربر مدام فایلهای تکراری دانلود میکند.
اگر خیلی طولانی باشد، ممکن است نسخهی قدیمی فایل نمایش داده شود.
Next.js 16.3 در این بخش رفتار Cache فایلهای استاتیک را بهتر کرده تا استفاده از منابع شبکه منطقیتر شود.
این تغییر شاید در پروژههای کوچک دیده نشود، اما در سایتهایی که حجم زیادی Asset دارند، میتواند روی سرعت واقعی کاربران تأثیر بگذارد.
Custom Error Boundaries
مدیریت خطا در اپلیکیشنهای بزرگ همیشه یک بخش مهم بوده است.
وقتی یک صفحه یا یک بخش از UI خراب میشود، اینکه کل برنامه از کار بیفتد تجربهی خوبی نیست.
React و Next.js مدتها امکان Error Boundary داشتند، اما Next.js 16.3 کنترلهای بیشتری برای ساخت تجربهی خطای بهتر ارائه میدهد.
هدف این است که بتوانی به جای نمایش یک صفحهی خطای عمومی، رفتار دقیقتری برای بخشهای مختلف برنامه داشته باشی.
مثلاً:
یک بخش از داشبورد خراب شود.
اما منوی اصلی همچنان کار کند.
کاربر بتواند دوباره تلاش کند.
این مدل در اپلیکیشنهای بزرگ اهمیت زیادی دارد.
Built-in Glob Imports؛ وارد کردن فایلها سادهتر میشود
یکی دیگر از تغییرات کوچک اما کاربردی، اضافه شدن قابلیت Glob Import داخلی است.
گاهی در پروژهها لازم است تعداد زیادی فایل را بر اساس یک الگو وارد کنی.
مثلاً:
همهی فایلهای Markdown یک پوشه
همهی کامپوننتهای یک مسیر
همهی فایلهای ترجمه
قبلاً معمولاً برای این کار سراغ ابزارهای جانبی میرفتیم.
حالا Next.js پشتیبانی بهتری برای این سناریوها فراهم کرده است.
این قابلیت شاید به تنهایی دلیل آپدیت نباشد، اما در پروژههای Content-heavy یا سیستمهای بزرگ مدیریت فایل، کار را راحتتر میکند.
Instant Navigation؛ نزدیکتر شدن Next.js به حس SPA
تا اینجا بیشتر دربارهی تغییرات زیرساختی صحبت کردیم.
اما بخشی که احتمالاً کاربران نهایی بیشتر حس میکنند، Navigation جدید است.
یکی از چالشهای همیشگی Next.js این بوده:
چطور سرعت SPA را داشته باشیم، بدون اینکه مزیتهای Server Components و Server Rendering را از دست بدهیم؟
Next.js 16.3 تلاش میکند این فاصله را کمتر کند.
Partial Prefetching
در نسخههای قبلی، Prefetch همیشه یک تعادل سخت داشت.
اگر زیاد Prefetch کنی:
درخواست زیاد میشود.
دادهی اضافی مصرف میشود.
اگر کم Prefetch کنی:
Navigation کندتر حس میشود.
Partial Prefetching راه وسط است.
به جای اینکه کل Route را از قبل آماده کند، فقط بخشهایی که برای شروع Navigation لازم هستند را دریافت میکند.
مثلاً Shell صفحه سریع آماده میشود و بخشهای سنگینتر بعداً میرسند.
نتیجه چیزی شبیه اپلیکیشنهای SPA است، اما با معماری Server-Driven.
Instant Insights؛ فهمیدن اینکه Navigation واقعاً چه اتفاقی میافتد
یکی از مشکلات توسعهدهندهها با اپلیکیشنهای مدرن این است که وقتی یک صفحه کند باز میشود، همیشه مشخص نیست مشکل دقیقاً کجاست.
آیا مشکل از:
دریافت داده از API است؟
Server Component زمان زیادی میبرد؟
Bundle سمت کلاینت بزرگ است؟
Prefetch درست انجام نشده؟
Cache کار نکرده؟
در Next.js 16.3 ابزارهای بهتری برای مشاهدهی رفتار Navigation اضافه شده تا توسعهدهنده بتواند دقیقتر بفهمد هنگام جابهجایی بین صفحات چه اتفاقی میافتد.
این همان چیزی است که در پروژههای بزرگ اهمیت پیدا میکند.
در پروژهی کوچک شاید بگویی:
«این صفحه فقط یک ثانیه دیرتر باز میشود.»
اما در یک محصول واقعی، همین یک ثانیه میتواند نتیجهی چندین مشکل کوچک باشد که پیدا کردنشان بدون ابزار مناسب سخت است.
وقتی یک کاربر روی یک لینک کلیک میکند، اتفاقات زیادی پشت صحنه رخ میدهد.
Next.js باید:
Route را پیدا کند.
دادههای لازم را آماده کند.
Cache را بررسی کند.
Server Componentها را پردازش کند.
نتیجه را به کلاینت برساند.
Navigation Inspector کمک میکند این مسیر واضحتر دیده شود.
این ابزار مخصوصاً برای زمانی کاربردی است که احساس میکنی یک Route باید سریع باشد، اما در عمل نیست.
به جای حدس زدن، میتوانی ببینی زمان دقیق کجا مصرف شده.
این تغییر شاید برای همهی توسعهدهندهها روزانه استفاده نشود، اما برای Debug کردن پروژههای بزرگ ارزش زیادی دارد.
بهبود Incremental Static Regeneration (ISR)
ISR یکی از قابلیتهایی است که باعث شد Next.js در سالهای اخیر بین سایتهای محتوایی و اپلیکیشنهای ترکیبی محبوب شود.
ایده ساده است:
صفحه را Static تولید کن، اما اجازه بده بعداً بدون Build کامل بهروزرسانی شود.
مشکل همیشه این بوده که Cache و Revalidation در پروژههای بزرگ میتواند پیچیده شود.
Next.js 16.3 روی رفتار ISR هم بهبودهایی آورده تا مدیریت این سناریوها قابل پیشبینیتر شود.
این موضوع مخصوصاً برای سایتهایی که:
محتوای زیاد دارند.
تغییرات مداوم دارند.
ولی نمیخواهند هر تغییر باعث Build کامل شود.
مهم است.
تست راحتتر با Playwright Test Helper
تست کردن Navigation و رفتارهای سمت سرور همیشه کمی سختتر از تست کردن کامپوننتهای ساده بوده است.
چون باید رفتار واقعی مرورگر، شبکه، Route و Rendering را هم در نظر بگیری.
Next.js 16.3 یک helper جدید برای Playwright ارائه کرده تا نوشتن تستهای مرتبط با اپلیکیشنهای Next.js راحتتر شود.
این یعنی تست کردن مواردی مثل:
Navigation
Loading State
Error State
رفتارهای App Router
کمتر نیاز به کد تکراری دارد.
برای تیمهایی که تست E2E جدی دارند، این تغییر کوچک نیست.
بهبودهای AI؛ Next.js برای دورهی Agentها آمادهتر میشود
اگر بخشهای مختلف Next.js 16.3 را کنار هم بگذاری، یکی از پیامهای واضح این نسخه این است:
فریمورکها دیگر فقط برای انسانها نوشته نمیشوند.
بخش زیادی از کدنویسی آینده احتمالاً با کمک Agentها انجام میشود.
اما یک Agent خوب فقط با داشتن یک مدل زبانی ساخته نمیشود.
باید:
ساختار پروژه را بفهمد.
قوانین تیم را بداند.
بداند از چه الگوهایی استفاده کند.
بداند کدام API مربوط به کدام نسخه است.
برای همین Next.js روی چند بخش کار کرده است.
AGENTS.md؛ قراردادن قوانین پروژه برای Agentها
اگر با ابزارهای AI کار کرده باشی، احتمالاً این مشکل را دیدهای.
هر بار باید توضیح بدهی:
«در این پروژه از Server Component استفاده کن.»
«این پوشه را تغییر نده.»
«برای API از این الگو استفاده کن.»
«قبل از تغییر، تستها را اجرا کن.»
فایل AGENTS.md قرار است همین اطلاعات را به شکل استاندارد در اختیار Agent قرار دهد.
در واقع یک فایل راهنما برای هوش مصنوعی پروژه است.
چیزی شبیه README، اما با مخاطب متفاوت.
README برای انسانهاست.
AGENTS.md برای Agentها.
Skills؛ اضافه کردن تواناییهای مشخص به Agent
یک Agent عمومی همه چیز را نمیداند.
گاهی میخواهی یک Agent دقیقاً برای یک کار خاص آماده باشد.
مثلاً:
ساخت Componentهای UI
کار با Database
نوشتن تست
مدیریت API
Skills این امکان را میدهد که تواناییهای مشخصتری تعریف شود.
این مدل باعث میشود Agent به جای اینکه هر بار از صفر تصمیم بگیرد، یک مسیر مشخص داشته باشد.
Versioned Docs برای جلوگیری از اشتباه Agentها
یکی از مشکلات رایج ابزارهای AI این است که ممکن است اطلاعات قدیمی استفاده کنند.
مثلاً یک Agent ممکن است کدی پیشنهاد دهد که برای Next.js 14 درست بوده، اما در Next.js 16 روش بهتری وجود داشته باشد.
Versioned Docs کمک میکند Agent اطلاعات هماهنگ با نسخهی واقعی پروژه دریافت کند.
این موضوع در فریمورکهایی مثل Next.js که مرتب تغییر میکنند، اهمیت زیادی دارد.
قابلیتهای آزمایشی Next.js 16.3
همهی تغییرات این نسخه برای استفادهی عمومی آماده نیستند.
چند قابلیت هنوز Experimental هستند.
React Compiler مبتنی بر Rust
React Compiler یکی از پروژههایی است که هدفش بهینهسازی خودکار React است.
ایده این است که کامپایلر بتواند بخشی از بهینهسازیهایی را انجام دهد که قبلاً توسعهدهنده باید دستی انجام میداد.
چیزهایی مثل:
جلوگیری از Render اضافی
مدیریت بهتر Memoization
بهینهسازی محاسبات
نسخهی Rust-based React Compiler تلاش میکند این فرآیند را سریعتر و مقیاسپذیرتر کند.
البته چون هنوز Experimental است، احتمالاً نباید همین فردا آن را روی Production فعال کرد.
اما مسیر آینده مشخص است.
React دارد بیشتر به سمت یک مدل Compiler-driven حرکت میکند.
Network Resilience؛ مقاومتر شدن در برابر مشکلات شبکه
اپلیکیشنهای واقعی همیشه در شرایط ایدهآل اجرا نمیشوند.
کاربر ممکن است:
اینترنت ضعیف داشته باشد.
اتصال لحظهای قطع شود.
درخواستها timeout شوند.
Network Resilience تلاش میکند رفتار اپلیکیشن در این شرایط بهتر شود.
هدف این نیست که مشکل شبکه جادویی حل شود.
هدف این است که برنامه در برابر این اتفاقها رفتار قابل پیشبینیتری داشته باشد.
آیا باید همین حالا به Next.js 16.3 آپدیت کنیم؟
مثل همیشه جواب به پروژه بستگی دارد.
اگر یک پروژهی حساس Production داری که چند هفته است بدون مشکل کار میکند، بهتر است طبق روال معمول:
نسخه را در محیط تست بررسی کنی.
Build را چک کنی.
تستها را اجرا کنی.
بعد منتشر کنی.
اما اگر:
پروژهی بزرگی داری.
RAM زیادی در dev مصرف میشود.
CI Build طولانی است.
از App Router استفاده میکنی.
با ابزارهای AI کار میکنی.
Next.js 16.3 احتمالاً یکی از آن آپدیتهایی است که ارزش امتحان کردن دارد.
چیزی که این نسخه را جالب میکند این نیست که یک API عجیب اضافه کرده.
اتفاق مهمتر این است که تقریباً همهجا کمی بهتر شده.
Turbopack سبکتر شده.
Buildها سریعتر شدهاند.
SSR بهینهتر شده.
Navigation روانتر شده.
و ابزارهای AI حالا بیشتر بخشی از اکوسیستم Next.js محسوب میشوند.
به نظر من Next.js 16.3 بیشتر از اینکه یک نسخهی «با چند قابلیت جدید» باشد، یک قدم برای بالغتر شدن فریمورک است.
قدم بعدی احتمالاً فقط سریعتر کردن اپلیکیشن نیست؛ بلکه ساختن محیطی است که انسان و Agent بتوانند کنار هم راحتتر محصول بسازند.
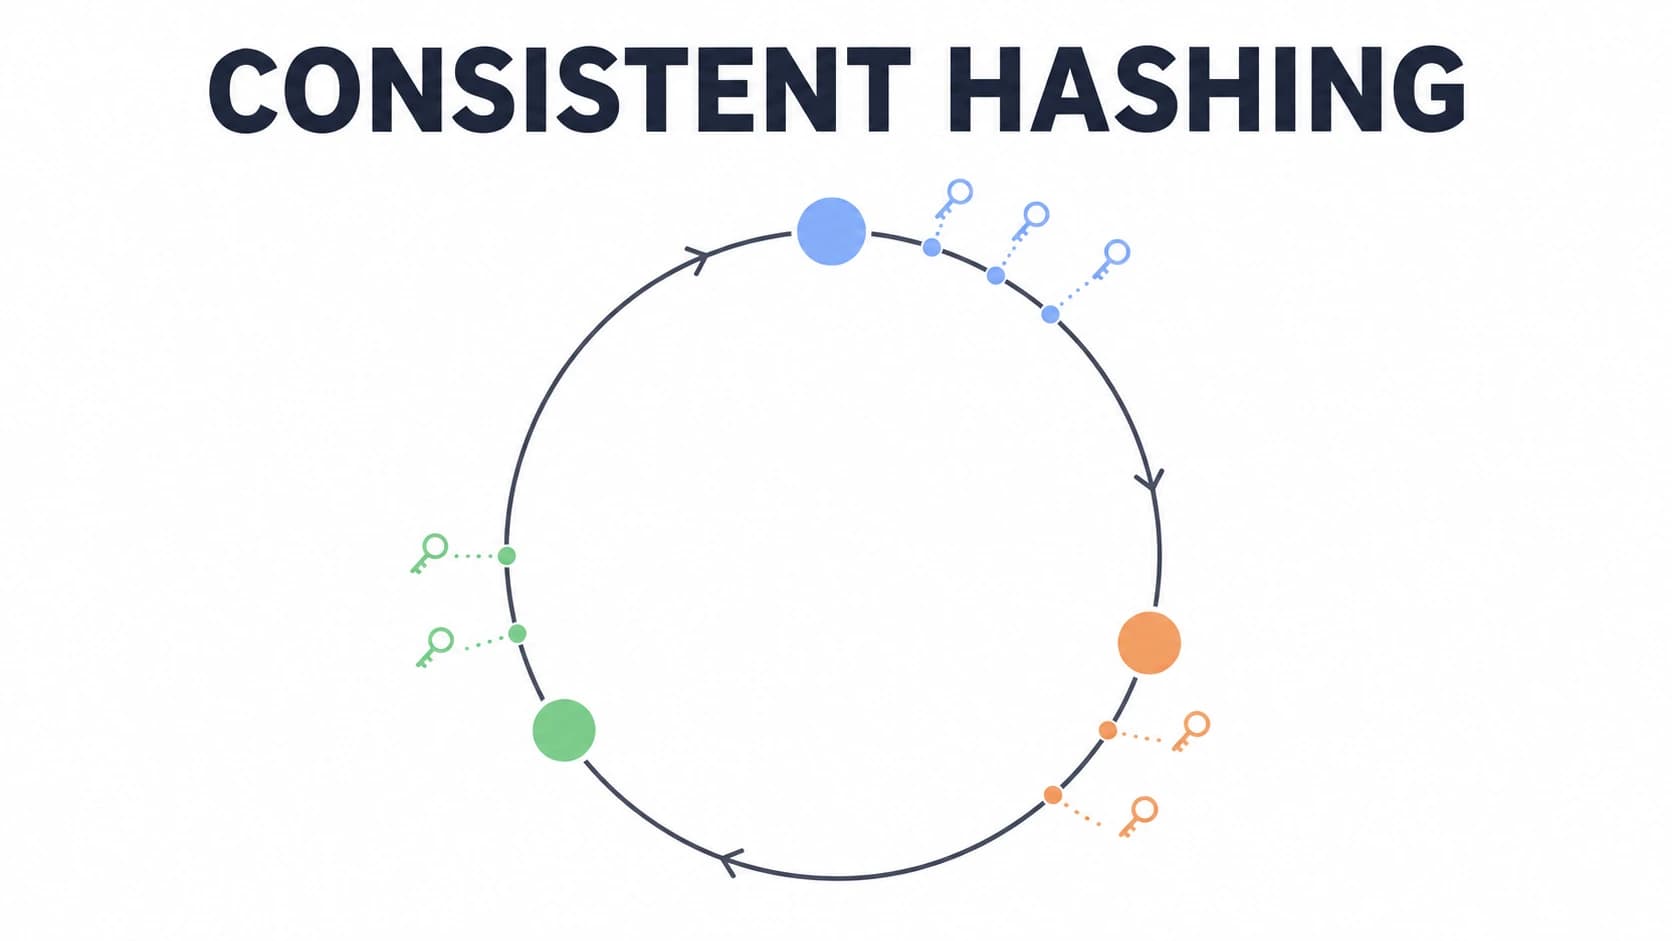
چرا فقط یه نقطه برای هر سرور کافی نیست
اگه هر سرور رو فقط با یه نقطهی واحد روی حلقه نشون بدیم، توزیع کلیدها خیلی نامتوازن میشه؛ ممکنه یه سرور فاصلهی خیلی بزرگی از حلقه رو پوشش بده و یکی دیگه فقط یه بخش کوچیک. راهحل رایج استفاده از virtual node هاست: بهجای یه نقطه، هر سرور فیزیکی رو با چند صد نقطهی مجازی (مثلاً ۱۰۰ تا ۲۰۰ تا) روی حلقه پخش میکنیم. کد بالا دقیقاً همین کار رو با پارامتر replicas انجام میده.
هرچی تعداد virtual node ها بیشتر باشه، توزیع بار بین سرورها یکنواختتر میشه، ولی به قیمت مصرف حافظهی بیشتر برای نگهداشتن این نقاط اضافه. تو عمل، عددی بین ۱۰۰ تا ۵۰۰ virtual node به ازای هر سرور فیزیکی معمولاً تعادل خوبی بین یکنواختی و overhead میده.
کجا واقعاً ازش استفاده میشه
Amazon DynamoDB و Cassandra از consistent hashing برای پارتیشنبندی داده بین node های کلاستر استفاده میکنن؛ این یکی از دلایل اصلیه که این دیتابیسها میتونن node اضافه یا کم کنن بدون اینکه کل کلاستر مجبور به rebalance کامل بشه.
Memcached و سیستمهای caching مشابه هم از همین تکنیک استفاده میکنن تا وقتی یه سرور کش از دسترس خارج میشه، فقط بخش کوچیکی از کشها miss بشن، نه همهشون.
CDN ها و load balancer های توزیعشده هم از نسخههای مشابهی از این ایده برای مسیریابی ترافیک به سمت نزدیکترین یا سالمترین سرور استفاده میکنن، بهطوری که وقتی یه edge server از کار میافته، فقط ترافیک مربوط به همون بخش از حلقه نیاز به جابهجایی داره.
محدودیتهایی که باید بدونی
Consistent hashing مشکل نامتوازنی سرورها رو حل میکنه، ولی خودش یه مشکل دیگه ایجاد میکنه: اگه سرورها ظرفیتهای متفاوتی داشته باشن (مثلاً یکی دو برابر رم بقیه داره)، نمیتونی بهسادگی همه رو با تعداد virtual node یکسان روی حلقه بذاری. راهحلش اینه که تعداد virtual node هر سرور رو متناسب با ظرفیتش تنظیم کنی؛ سروری که ظرفیت دو برابر داره، دو برابر virtual node هم میگیره.
نکتهی دیگه اینه که consistent hashing بهتنهایی replication رو مدیریت نمیکنه. اگه بخوای هر کلید روی چند سرور کپی بشه (برای fault tolerance)، باید علاوه بر پیدا کردن اولین سرور روی حلقه، N سرور بعدی رو هم بهعنوان replica در نظر بگیری؛ همون کاری که Cassandra و DynamoDB زیر پوستشون انجام میدن.
چند تا مثال واقعی
MongoDB بهصورت پیشفرض بیشتر به سمت CP گرایش داره؛ وقتی primary node در دسترس نباشه یا اکثریت replica ها قابلدسترس نباشن، نوشتنها متوقف میشن تا consistency حفظ بشه.
Cassandra طراحیش از پایه AP-محور بوده؛ همیشه به درخواستها جواب میده، حتی اگه بعضی replica ها هنوز بهروز نشده باشن، و از مدل eventual consistency استفاده میکنه.
CockroachDB و Google Spanner سعی میکنن با استفاده از الگوریتمهای consensus مثل Raft یا Paxos، در اکثر شرایط هر دو رو تا حد ممکن نزدیک هم نگه دارن، ولی باز هم زیر پوستشون، وقتی واقعاً partition جدی اتفاق بیفته، اولویت رو به consistency میدن.
چرا این مدل سادهشده هم کامل نیست
یه نقد رایج به CAP اینه که این مدل بیشازحد سادهست، چون partition ها همیشه یا کامل هستن یا اصلاً نیستن، در حالی که تو دنیای واقعی شبکه معمولاً بهجای قطع کامل، فقط کند میشه یا packet loss داره. برای همین، یه فریمورک تکمیلی به اسم PACELC مطرح شده که میگه: در حالت Partition، بین Availability و Consistency انتخاب کن (همون CAP)، ولی حتی وقتی partition نداری (Else)، بین Latency و Consistency هم باید یه مصالحه انجام بدی. یعنی حتی تو حالت عادی شبکه، دیتابیسهایی مثل Cassandra ترجیح میدن latency پایینتری بدن به قیمت consistency ضعیفتر، در حالی که چیزی مثل Spanner حاضره latency بیشتری رو تحمل کنه تا consistency قویتری داشته باشه.
این یعنی چی برای انتخاب دیتابیس
وقتی داری معماری یه سیستم رو طراحی میکنی، سؤال درست این نیست که «کدوم دیتابیس بهتره؟»، بلکه اینه که «سیستمم چه چیزی رو نمیتونه تحمل کنه؟» برای یه سیستم بانکی که موجودی حساب رو مدیریت میکنه، نشون دادن یه مقدار قدیمی یا اشتباه فاجعهباره؛ پس CP منطقیتره، حتی اگه یعنی بعضی وقتها کاربر با تأخیر مواجه بشه. ولی برای چیزی مثل تعداد لایک یه پست تو شبکهی اجتماعی، اگه چند ثانیه یه عدد قدیمیتر نشون داده بشه هیچ فاجعهای اتفاق نمیافته، ولی اگه کل سایت پایین بیاد چون یه node قطع شده، تجربهی کاربری خیلی بدتری رقم میخوره. اینجا AP انتخاب درستتریه.
نکتهی آخر اینکه CAP فقط دربارهی رفتار سیستم زیر partition حرف میزنه، نه دربارهی performance عمومی یا مقیاسپذیری. یه دیتابیس میتونه CP باشه و همچنان خیلی سریع و مقیاسپذیر باشه؛ این دو مفهوم کاملاً مستقل از هم هستن و نباید با هم قاطی بشن.
نکتهی مهم برای کسایی که از API استفاده میکنن
یه چیزی که قابل توجهه: این آپدیت فقط روی API عمومی V4-Flash اعمال شده، نه روی اپ و وبسایت دیپسیک، و نه روی V4-Pro. یعنی اگه از طریق اپ چت دیپسیک استفاده میکنی، رفتار مدل هنوز همون نسخهی قبلیه. کسایی که مستقیم از API یا از سرویسهایی مثل Ollama یا OpenRouter استفاده میکنن، این تغییر رو بهصورت خودکار و بیسروصدا دریافت کردن، بدون اینکه نیاز به تغییر کد یا endpoint داشته باشن.
اگه داری برای یه ابزار agentic (مثلاً یه coding assistant که چند مرحله tool call میزنه) مدل انتخاب میکنی، این آپدیت دلیل خوبیه که V4-Flash رو دوباره تست کنی، حتی اگه قبلاً بهش به چشم یه گزینهی «سبکتر و کمقدرتتر» نسبت به V4-Pro نگاه میکردی. به نظر میرسه فعلاً این فرض دیگه لزوماً درست نیست.
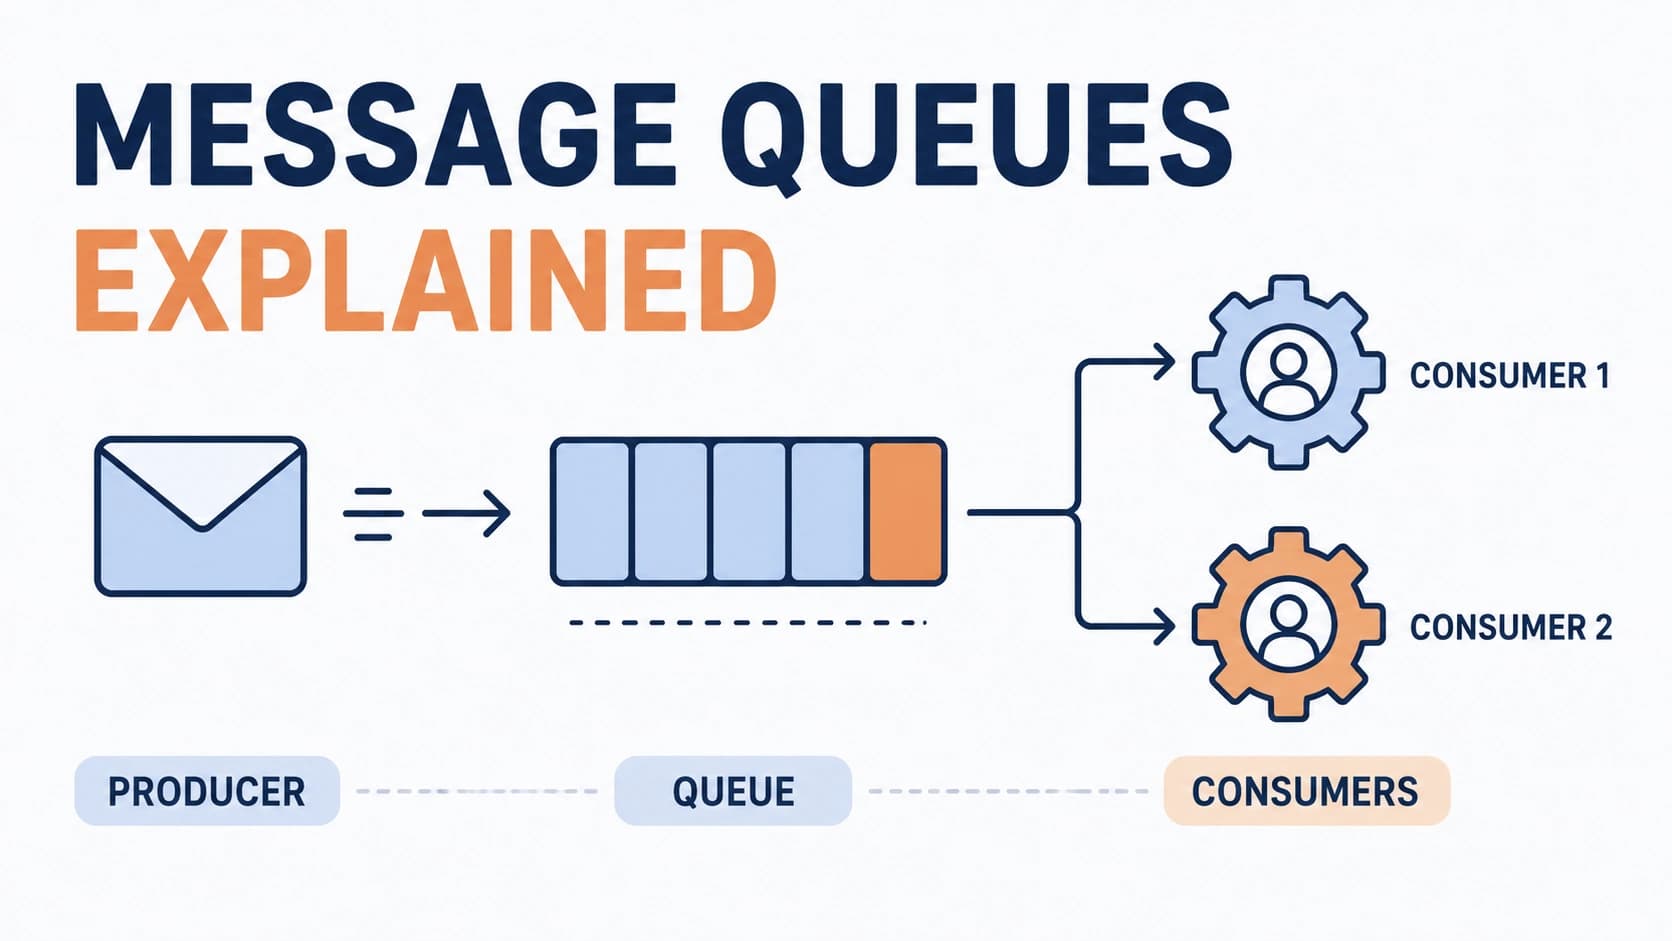
یه چیزی که تو مستندات خیلی جاها ساده جلوه داده میشه ولی تو عمل مهمه، تفاوت بین الگوهای مختلف صفبندیه:
Point-to-point (work queue): یه صف داریم و چند تا consumer که هر پیام فقط توسط یکی از اونها پردازش میشه. مناسب کارهایی مثل پردازش تصویر، ارسال ایمیل، یا هر کاری که باید دقیقاً یکبار انجام بشه.
# producer با pika (کلاینت RabbitMQ برای پایتون)
import pika

connection = pika.BlockingConnection(pika.ConnectionParameters('localhost'))
channel = connection.channel()
channel.queue_declare(queue='email_tasks', durable=True)

channel.basic_publish(
    exchange='',
    routing_key='email_tasks',
    body='{"user_id": 42, "type": "welcome_email"}',
    properties=pika.BasicProperties(delivery_mode=2)  # پیام روی دیسک persist بشه
)
Publish-subscribe: پیام به یه exchange یا topic فرستاده میشه و همهی subscriber ها (نه فقط یکی) یه کپی از اون رو میگیرن. برای رویدادهایی که چند تا سرویس مختلف باید بهشون واکنش نشون بدن مناسبه؛ مثلاً وقتی سفارشی ثبت میشه، هم سرویس انبار باید بدونه، هم سرویس ایمیل، هم آنالیتیکس.
Kafka خودش رو بیشتر حول همین مدل ساخته، با این تفاوت که پیامها بعد از مصرف حذف نمیشن و میتونن دوباره از اول خونده بشن — که این برای event sourcing یا replay کردن دادهها خیلی بهدردبخوره.
RabbitMQ یا Kafka؟
این سؤالی است که تو تقریباً هر تیمی یه بار مطرح میشه و جواب قطعی نداره، به این دلیل که این دو تا اصلاً برای یه هدف ساخته نشدن.
RabbitMQ یه message broker سنتیه، قوی تو routing پیچیده (exchange های direct، topic، fanout)، و مناسب وقتیه که کارها (task) داری که باید دقیقاً یکبار پردازش بشن و ترتیبشون خیلی حیاتی نیست. برای صفهای کاری معمولی، جواب میده و راهاندازیش هم نسبتاً سادهست.
Kafka بیشتر یه distributed log هست تا یه صف کلاسیک. throughput خیلی بالاتری داره، پیامها رو برای مدت طولانی نگه میداره، و برای stream processing و جایی که چند consumer باید مستقل از هم همون داده رو بخونن (و شاید بعداً دوباره بخونن) طراحی شده. ولی overhead عملیاتیش بیشتره؛ نیاز به Zookeeper یا KRaft داره و tuning اش پیچیدهتره.
قانون کلی که خودم بهش رسیدم: اگه صرفاً یه task queue میخوای (پردازش پسزمینه، job scheduling)، RabbitMQ یا حتی چیزی سبکتر مثل Redis + BullMQ کافیه. اگه داری event-driven architecture میسازی که چند سرویس باید stream یکسانی از رویدادها رو دنبال کنن، Kafka انتخاب منطقیتریه.
چیزهایی که معمولاً کسی بهت نمیگه
یه چیزی که تو اکثر tutorial ها نادیده گرفته میشه، مسئلهی idempotency است. queue تضمین میکنه پیام حتماً تحویل داده میشه، ولی این تضمین معمولاً به معنی «حداقل یکبار» (at-least-once) هست، نه دقیقاً یکبار. یعنی اگه consumer پیامی رو پردازش کنه ولی قبل از فرستادن ack کرش کنه، همون پیام دوباره تحویل داده میشه. اگه handler ات idempotent نباشه (مثلاً دوباره یه ایمیل یا دوباره کم کردن موجودی انبار)، این میتونه به باگهای عجیبی منجر بشه که فقط زیر لود بالا خودشون رو نشون میدن.
راهحل معمولش اینه که یه شناسهی یکتا (idempotency key) رو تو خود پیام بذاری و قبل از پردازش چک کنی که این key قبلاً پردازش شده یا نه — معمولاً با یه جدول یا کلید تو Redis با TTL مناسب.
نکتهی دیگه، dead letter queue است. اگه یه پیام چندین بار fail بشه (مثلاً یه فرمت دادهی خراب)، نباید بذاری برای همیشه بین صف اصلی و consumer رد و بدل بشه. اکثر broker ها امکان تعریف یه صف جداگانه رو دارن که بعد از N بار retry ناموفق، پیام به اونجا منتقل میشه تا بعداً دستی بررسیش کنی. بدون این، یه پیام خراب میتونه کل صف رو مسدود کنه یا لاگها رو پر کنه.
کِی اصلاً به queue نیاز نداری
با همهی این حرفها، queue همیشه جواب درست نیست. اگه عملیاتت سریعه و کاربر واقعاً باید نتیجهی فوری رو ببینه (مثلاً یه محاسبهی قیمت لحظهای)، اضافه کردن یه لایهی async فقط پیچیدگی اضافه میکنه بدون هیچ فایدهای. queue بیشتر برای کارهایی معنی داره که میتونن «بعداً» انجام بشن، یا وقتی حجم درخواستها نامنظمه و میخوای consumer رو از فشار لحظهای محافظت کنی.
اگه تازه داری معماری یه سیستم رو طراحی میکنی، بهتره اول ببینی کدوم بخش از پردازشت واقعاً میتونه صبر کنه، بعد queue رو دقیقاً همونجا اضافه کنی — نه اینکه از اول همهچیز رو async کنی چون «الگوی بهتریه».
// pseudo-code ساده برای fixed window
const requests = {}; // { userId: { count, windowStart } }

function isAllowed(userId, limit = 100, windowMs = 60000) {
  const now = Date.now();
  const entry = requests[userId];

  if (!entry || now - entry.windowStart > windowMs) {
    requests[userId] = { count: 1, windowStart: now };
    return true;
  }

  if (entry.count >= limit) return false;
  entry.count++;
  return true;
}
مشکل این روش یک نکتهی ظریفه: چون بازهها ثابت و جدا از همن، یک کلاینت میتونه دقیقاً لحظهی آخر یک بازه ۱۰۰ درخواست بفرسته و دقیقاً لحظهی اول بازهی بعدی، ۱۰۰ درخواست دیگه — یعنی توی یک بازهی دو ثانیهای واقعی، ۲۰۰ درخواست رد شده، درحالیکه سقف روی کاغذ ۱۰۰ در دقیقه بود. به این پدیده burst at boundary میگن.
Sliding Window
این روش با نگهداشتن timestamp دقیق هر درخواست (یا یک تقریب وزندار از دو بازهی متوالی)، مشکل burst مرزی رو حل میکنه. دقیقتره ولی حافظه و محاسبات بیشتری میخواد، چون باید یا timestamp های تکتک درخواستها رو نگه داری، یا یک فرمول ترکیبی حساب کنی.
Token Bucket
این یکی از محبوبترین الگوریتمهاست، چون هم دقیقه، هم به کلاینت اجازهی burst کنترلشده میده. تصورش اینطوریه: یک سطل با ظرفیت مشخص (مثلاً ۱۰ توکن) داری که با نرخ ثابتی (مثلاً یک توکن در ثانیه) پر میشه. هر درخواست یک توکن مصرف میکنه؛ اگه سطل خالی باشه، درخواست رد میشه. مزیتش اینه که اگه کلاینت مدتی درخواستی نفرستاده باشه، سطلش پر مونده و میتونه یک burst کوتاه (تا سقف ظرفیت سطل) بفرسته، ولی نمیتونه برای مدت طولانی بالاتر از نرخ میانگین ادامه بده.
مشابه token bucket ولی از زاویهی دیگه: درخواستها توی یک صف (سطل) قرار میگیرن و با نرخ ثابتی از صف خارج و پردازش میشن، مثل یک سطل که از یک سوراخ ثابت آب نشت میکنه. اگه صف پر بشه، درخواستهای جدید رد میشن. این روش خروجی رو کاملاً یکنواخت نگه میداره (بدون burst)، برخلاف token bucket که burst محدود رو مجاز میدونه — انتخاب بین این دو به این بستگی داره که آیا میخوای نرخ خروجی کاملاً ثابت باشه، یا کمی انعطاف برای burst داشته باشه.
کجا پیادهسازیش کنیم
rate limiting رو میشه در چند لایه پیاده کرد. توی سطح Nginx یا یک reverse proxy، با ماژول limit_req میشه بدون تغییر کد اپلیکیشن، محدودیت گذاشت:
توی سطح اپلیکیشن، معمولاً از Redis برای نگهداشتن شمارندهها استفاده میشه، چون Redis سریع و atomic عمل میکنه و اگه چند instance از سرور اپلیکیشن داشته باشی، همه بتونن یک شمارندهی مشترک رو ببینن (که با یک شمارندهی in-memory جدا روی هر instance، امکانش نیست).
توی سطح API Gateway (مثل Kong، AWS API Gateway، یا Cloudflare)، rate limiting معمولاً بهصورت آماده و قابلتنظیم از طریق پنل مدیریت وجود داره، بدون نیاز به نوشتن کد.
پاسخ درست به کلاینت رد شده
وقتی یک درخواست بهخاطر rate limit رد میشه، باید کد وضعیت HTTP استاندارد 429 Too Many Requests رو برگردونی، و بهتره هدر Retry-After رو هم اضافه کنی تا کلاینت بدونه دقیقاً چند ثانیه دیگه باید صبر کنه قبل از تلاش مجدد. این جزئیات کوچیک، تفاوت بین یک API قابلاعتماد و یکی که کلاینتهاش رو گیج میکنه رو میسازه.
چطوری بهتره استفاده بشه ؟
Rate limiting را میتوان در چند لایه مختلف پیادهسازی کرد؛ از لایه زیرساخت مثل Nginx و API Gateway گرفته تا داخل خود اپلیکیشن. انتخاب محل مناسب بستگی دارد به اینکه هدف اصلی، محافظت از منابع سیستم است یا کنترل رفتار کاربران و قوانین کسبوکار.
Rate Limiting در Nginx / Reverse Proxy
Nginx در لایه ورودی سیستم قرار میگیرد و قبل از رسیدن درخواست به اپلیکیشن تصمیم میگیرد که درخواست اجازه عبور دارد یا نه. مزیت اصلی این روش این است که درخواستهای اضافی اصلاً وارد برنامه نمیشوند و منابعی مثل CPU، حافظه و اتصالهای دیتابیس مصرف نمیشوند.
این روش برای جلوگیری از فشار زیاد، حملات حجمی، crawlerها و درخواستهای غیرعادی بسیار مناسب است.
مزایا:
عملکرد بسیار بالا
کاهش فشار روی اپلیکیشن
عدم نیاز به تغییر کد برنامه
محدودیت اصلی آن این است که معمولاً فقط به اطلاعاتی مثل IP و Header دسترسی دارد و نمیتواند تفاوت بین کاربران، پلنها یا سطح دسترسی آنها را تشخیص دهد.
مثلاً نمیتواند بهتنهایی تصمیم بگیرد که یک کاربر رایگان فقط ۱۰۰ درخواست در دقیقه داشته باشد و یک کاربر حرفهای ۱۰۰۰۰ درخواست.
Rate Limiting در Middleware اپلیکیشن
در این روش محدودیت داخل خود برنامه اعمال میشود. چون اپلیکیشن اطلاعات بیشتری درباره کاربر دارد، میتواند قوانین دقیقتری بر اساس User ID، API Key، نقش کاربر یا نوع اشتراک اعمال کند.
برای مثال، یک سرویس هوش مصنوعی میتواند برای کاربران رایگان محدودیت ۱۰ درخواست در روز و برای کاربران پولی محدودیت ۱۰۰۰ درخواست در روز قرار دهد.
مزایا:
دسترسی به اطلاعات کامل کاربر
مناسب برای قوانین کسبوکار
انعطافپذیری بالا
اما مشکل این روش این است که درخواست ابتدا وارد اپلیکیشن میشود و سپس محدود میشود. همچنین در معماریهای چند سروره، نگهداری شمارنده در حافظه داخلی هر سرور باعث ایجاد خطا میشود.
برای مثال اگر یک کاربر ۱۰۰ درخواست ارسال کند و Load Balancer آن را بین دو سرور تقسیم کند، هر سرور ممکن است فقط ۵۰ درخواست ببیند و محدودیت بهدرستی اعمال نشود.
به همین دلیل معمولاً از Redis یا یک ذخیرهساز مشترک برای نگهداری وضعیت rate limit استفاده میشود.
Rate Limiting در API Gateway
API Gateway یک لایه مدیریتی بین کلاینت و سرویسهای مختلف قرار میگیرد و معمولاً برای معماریهای بزرگ و چندسرویسی استفاده میشود.
این لایه میتواند محدودیتهای مشترکی برای تمام APIها اعمال کند، API Key مدیریت کند، quota تعریف کند و سیاستهای امنیتی را بهصورت متمرکز اجرا کند.
مزایا:
مناسب برای Microserviceها
مدیریت متمرکز APIها
پشتیبانی از API Key و quota
در مقابل، پیچیدگی و هزینه بیشتری نسبت به Nginx یا middleware ساده دارد و برای پروژههای کوچک ممکن است بیش از نیاز باشد.
بهترین رویکرد: ترکیبی از چند لایه
در سیستمهای واقعی معمولاً از یک روش واحد استفاده نمیشود، بلکه چند لایه با هم کار میکنند.
یک معماری رایج:
Client

   |
   v

Cloudflare / WAF

   |
   v

Nginx
(IP Rate Limit)

   |
   v

Application
(User/API Key Limit)

   |
   v

Redis
(Shared Counter)

   |
   v

Database
در این معماری:
Nginx جلوی فشار غیرعادی روی زیرساخت را میگیرد.
Middleware اپلیکیشن محدودیتهای مربوط به کاربران و منطق کسبوکار را اجرا میکند.
Redis وضعیت rate limit را بین چند سرور هماهنگ نگه میدارد.
API Gateway در سیستمهای بزرگ مدیریت متمرکز APIها را انجام میدهد.
مثال:
برای یک وبسایت بلاگی متوسط، یک نقطه شروع منطقی میتواند این باشد:
محدودیت عمومی در Nginx: حدود 50 تا 100 درخواست در ثانیه برای هر IP
محدودیت در سطح کاربر: حدود 1000 تا 3000 درخواست در ساعت که مثلا از ۱۰۰۰ تا برای مهمان و ۳۰۰۰ برای بالاترین سطح دسترسی قبل از ادمین
endpointهای حساس: بین 3 تا 10 درخواست در دقیقه
اما این اعداد قطعی نیستند. یک وبسایت خبری با میلیونها بازدید روزانه، یک وبلاگ شخصی و یک SaaS با API عمومی، نیازهای کاملاً متفاوتی دارند.
عدد صحیح زمانی مشخص میشود که رفتار واقعی کاربران، میانگین درخواستها، زمان پاسخ API، ظرفیت سرور و مصرف منابع بررسی شود. Rate limiting باید بر اساس ظرفیت سیستم تنظیم شود، نه صرفاً بر اساس یک عدد از پیش تعیینشده.
جمعبندی
rate limiting یکی از اون تصمیمهای زیرساختیه که تا نیازش رو حس نکنی، شاید حس کنی زیادیه، ولی وقتی یک باگ توی یک کلاینت یا یک حملهی ساده بدون این لایه سرورت رو از پا دربیاره، میفهمی چرا این یکی از اولین چیزهاییه که هر API عمومی باید از روز اول داشته باشه، نه چیزی که بعد از اولین حادثه اضافهاش میکنی.
دوم، طول متغیر. cuid اصلی طول ثابتی داشت، ولی cuid2 بهصورت پیشفرض طول قابل تنظیم داره (پیشفرض ۲۴ کاراکتر) و میتونی بین ۴ تا ۳۲ کاراکتر تنظیمش کنی، بسته به اینکه چقدر فضای نام یا خوانایی برات مهمه.
سوم، شروع با حرف. هر cuid2 با یک حرف (نه عدد) شروع میشه، که این یک نکتهی فنی مهمه: بعضی سیستمها و زبانهای برنامهنویسی وقتی یک شناسه با عدد شروع بشه، ممکنه اون رو بهاشتباه بهعنوان عدد تفسیر کنن (مثلاً توی نام متغیر جاوااسکریپت یا بعضی زبانهای کوئری). با اجباریکردن شروع با حرف، cuid2 این کلاس از باگها رو کامل حذف میکنه.
چهارم، همچنان قابل مرتبسازی تقریبی بر اساس زمانه (نه دقیق مثل ULID، ولی بهاندازهی کافی برای اکثر کاربردهای عملی)، بدون اینکه این ترتیب، اطلاعات حساس رو لو بده.
مقایسهی مستقیم
ویژگی
cuid
cuid2
الگوریتم
fingerprint + timestamp + counter
SHA3 هش روی entropy تصادفی
قابل پیشبینی بودن
نسبتاً بله (ریسک امنیتی)
خیر
طول
ثابت
متغیر (پیشفرض ۲۴، قابل تنظیم ۴ تا ۳۲)
شروع رشته
حرف c ثابت
همیشه یک حرف تصادفی
عملکرد در serverless
ضعیفتر
بهینهشده
نگهداری پروژه
متوقف شده
فعال
مثال کد
استفاده از cuid2 توی جاوااسکریپت خیلی سادهست:
import { createId } from '@paralleldrive/cuid2';

const id = createId();
// مثال خروجی: tz4a98xxat96iws9zmbrgj3a

// اگه بخوای طول متفاوتی داشته باشی
import { init } from '@paralleldrive/cuid2';
const createShortId = init({ length: 10 });
const shortId = createShortId();
توی پروژههای Prisma هم، تعریف یک فیلد با cuid2 به این شکله:
model User {
  id String @id @default(cuid2())
}
کِی از هرکدوم استفاده کنیم
اگه پروژهی جدیدی شروع میکنی، عملاً هیچ دلیلی برای انتخاب cuid اصلی وجود نداره — نگهداریش متوقف شده و مشکلات امنیتیش شناختهشدهست. سراغ cuid2 برو، مگر اینکه نیازهای خاصتری داشته باشی: اگه به ترتیب دقیق زمانی (نه فقط تقریبی) نیاز داری، ULID انتخاب بهتریه؛ اگه سازگاری با استانداردهای جهانی و اکوسیستمهای قدیمیتر مهمه، UUID (بهخصوص نسخهی ۷ که خودش هم قابل مرتبسازی زمانیه) گزینهی امنتریه. ولی برای اکثر پروژههای وب مدرن که شناسهی کوتاه، url-friendly، و امن میخوان، cuid2 دقیقاً همونجاییه که باید بری.
Fast mode جدید برای Sol
همراه با این کاهش قیمت، OpenAI یک قابلیت جدید هم برای Sol معرفی کرده به اسم Fast mode، که بهجای Priority Processing قبلی نشسته. این حالت تا ۲.۵ برابر سرعت پردازش استاندارد رو ارائه میده، ولی با دو برابر قیمت معمول. یعنی برای کاربردهایی که تأخیر (latency) بحرانیه — مثل agent هایی که باید بلادرنگ جواب بدن — یک گزینهی صریح برای «سرعت در ازای هزینهی بیشتر» وجود داره، بهجای اینکه مجبور باشی کل ساختار قیمتگذاری رو حدس بزنی.
مقایسه با رقبا
نکتهای که گزارش رویترز بهش اشاره کرده جالبه: با قیمت جدید، Terra حالا حتی از Claude Sonnet 4.6 آنتروپیک هم ارزونتر تموم میشه — Sonnet 4.6 روی $3 ورودی و $15 خروجی قیمتگذاری شده، درحالیکه Terra بعد از کاهش قیمت روی $2 و $12 قرار گرفته. این یعنی رقابت قیمتی بین لابراتوارهای بزرگ AI داره واقعیتر و ملموستر میشه، نه فقط روی کاغذ.
چرا این برای دولوپرها مهمه
اگه داری یک pipeline خودکار میسازی که حجم بالایی از توکن مصرف میکنه — مثل پردازش batch داده، تولید محتوا، یا یک agent که مدام درخواست میفرسته — این کاهش قیمت مستقیماً روی صورتحساب ماهانهات اثر میذاره، بدون اینکه مجبور باشی کدی رو تغییر بدی. تنها کاری که لازمه، اطمینان از اینکه مدل درستی (Luna برای کارهای سبک، Terra برای کارهای متوسط) رو برای هر بخش از workflow انتخاب کرده باشی، دقیقاً همون فلسفهای که این چند وقت پشت تنظیمات effort در مدلهای دیگه هم دیدیم: هزینه رو متناسب با واقعیبودن نیاز کار تنظیم کن، نه یک انتخاب یکسان برای همهچیز.
جمعبندی
این کاهش قیمت فقط یک تخفیف تجاری ساده نیست؛ نشونهایه از اینکه رقابت بین مدلهای AI داره وارد فاز جدیدی میشه که در اون کارایی و هزینه بهاندازهی هوش خام مهم شدن. برای کسی که روی این مدلها پروژه میسازه، این خبر خوبیه: همون کیفیت، با هزینهی کمتر. برای کل صنعت، این نشونهی اینکه دوران بیحسابوکتاب مصرف توکن داره به سمت یک بازار بالغتر و حساستر به هزینه حرکت میکنه.
Typesense هم رقیب مشابهیه، با فلسفهی تقریباً یکسان: نصب ساده، پاسخ سریع، API قابلفهم. هر دو این ابزارها برای autocomplete و جستجوی محصول توی فروشگاههای کوچیک تا متوسط، مستندات، یا هر جایی که کاربر انتظار جواب فوری داره، انتخابهای خیلی خوبی هستن.
اما این سادگی رایگان نیست. تریدآف اصلی اینه که Meilisearch و Typesense قابلیتهای aggregation پیچیدهای که Elasticsearch داره رو ندارن — یعنی اگه نیازت فقط جستجوی متنیه، عالی جواب میدن، ولی اگه میخوای همزمان تحلیل آماری روی میلیونها رکورد لاگ انجام بدی یا dashboard های پیچیدهی مانیتورینگ بسازی (کاری که Kibana روی Elasticsearch انجام میده)، این ابزارهای سبکتر برات کافی نیستن. خلاصهاش اینه: اگه مسئلهات «جستجو»ست، سبکترها رو انتخاب کن؛ اگه مسئلهات «جستجو + آنالیز حجم عظیم داده»ست، سراغ Elasticsearch برو.
نصب Elasticsearch با Docker
راحتترین و تمیزترین راه برای بالا آوردن Elasticsearch، بهخصوص برای توسعه یا تست، استفاده از Docker است، چون همهی وابستگیها (شامل خود JVM) داخل ایمیج پکیج شدن و مجبور نیستی هیچی رو دستی روی سیستم نصب کنی.
همچنین لازمه تنظیم vm.max_map_count رو دستی انجام بدی، چون Elasticsearch برای مدیریت حافظهی داخلیش به مقدار بالاتری از پیشفرض لینوکس نیاز داره:
sudo sysctl -w vm.max_map_count=262144
کدوم روش رو انتخاب کنیم
برای توسعه، تست محلی، یا حتی خیلی از سناریوهای production کوچیک تا متوسط، Docker (یا بهتر، docker-compose همراه با volume برای persistence) گزینهی پیشنهادیه. مزیتش اینه که آپدیت نسخه، ریاستارت، و پاکسازی کامل محیط، یک دستور بیشتر نیست. نصب مستقیم روی سیستمعامل رو معمولاً وقتی توصیه میکنن که تیم زیرساخت از قبل روی مدیریت سرویسهای systemd و مانیتورینگ سطح OS تجربه داره، یا محدودیت سازمانی برای استفاده از Docker وجود داره. برای اکثر تیمها، مسیر Docker هم سریعتره هم قابلتکرارتر (reproducible)، پس معمولاً انتخاب اول همینه.
نوشتن Query در Elasticsearch
Elasticsearch با یک زبان JSON-based به اسم Query DSL کار میکنه. سادهترین حالت، جستجوی متنی روی یک فیلد است:
نکتهی مهم اینجا فرق must و filter است: بخش must روی امتیاز relevance تأثیر میذاره (یعنی نتایج بر اساس میزان تطابق رتبهبندی میشن)، ولی filter فقط true/false هست و روی امتیاز اثر نداره — و چون کش میشه، سریعتر هم اجرا میشه. برای شرطهایی مثل بازهی قیمت یا وضعیت موجودی که فقط باید فیلتر کنن نه رتبهبندی، همیشه از filter استفاده کن.
برای aggregation، یعنی محاسبات آماری روی نتایج، مثلاً میانگین قیمت به تفکیک برند:
عدد ^2 کنار title یعنی تطابق توی این فیلد دو برابر وزن بیشتری توی محاسبهی relevance داره — یعنی اگه کلمه توی عنوان پیدا بشه، نسبت به پیدا شدن توی توضیحات، امتیاز بالاتری میگیره.
جستجوی مقاوم به غلط تایپی (fuzzy)
اگه بخوای حتی وقتی کاربر کلمه رو اشتباه تایپ کرده جواب پیدا کنی:
ترکیب چند شرط با bool کامل (must, should, must_not, filter)
یک مثال واقعیتر که همهی بخشهای bool رو با هم نشون میده: محصولاتی که «کفش» توی عنوانشونه، ترجیحاً برند «نایک» یا «آدیداس» باشن (امتیاز بیشتر ولی اجباری نیست)، جنسشون «چرم» نباشه، و موجود باشن:
اینجا نتایج اول بر اساس قیمت صعودی مرتب میشن و در صورت تساوی قیمت، بر اساس امتیاز relevance. from و size هم صفحهی سوم رو برمیگردونن (فرض بر ۱۰ آیتم در هر صفحه).
هایلایت کردن کلمهی جستجوشده در نتیجه
وقتی میخوای مثل گوگل، بخشی از متن که با جستجو مطابقت داشته رو بولد نشون بدی:
اینجا k تعداد نزدیکترین نتایجی که میخوای برگرده رو مشخص میکنه، و num_candidates تعداد کاندیدهایی که Elasticsearch قبل از انتخاب k تای نهایی بررسی میکنه — عدد بزرگتر یعنی دقت بالاتر ولی سرعت پایینتر.
قابلیتهای اضافهای که کمتر دیده میشن
فراتر از جستجوی متنی معمولی، Elasticsearch چند قابلیت داره که ارزش دونستن دارن.
geo queries به تو اجازه میدن جستجوی مکانی انجام بدی — مثلاً «همهی رستورانهای نزدیک این مختصات جغرافیایی توی شعاع ۲ کیلومتر». این برای اپلیکیشنهای مبتنی بر موقعیت مکانی حیاتیه و بدون ابزار جانبی مستقیم پشتیبانی میشه.
kNN search یا جستجوی برداری، قابلیتیه که این چند سال با رشد هوش مصنوعی خیلی مهم شده: میتونی بهجای جستجوی متنی، بردارهای embedding (خروجی مدلهای زبانی) رو ایندکس کنی و نزدیکترین بردارها به یک query رو پیدا کنی — دقیقاً همون چیزی که پشت سیستمهای RAG (retrieval-augmented generation) قرار داره.
percolate query برعکس جستجوی معمولیه: بهجای اینکه یک query رو روی مجموعهای از داده اجرا کنی، یک دادهی جدید رو روی مجموعهای از query های از قبل ذخیرهشده تست میکنی — مفید برای سیستمهای هشدار و فیلترینگ که باید بفهمن یک رکورد جدید با کدوم شرطهای ازپیشتعریفشده مطابقت داره.
و در نهایت، ecosystem کامل ELK/Elastic Stack — یعنی Kibana برای visualization، Logstash و Beats برای جمعآوری و انتقال داده — چیزیه که Elasticsearch رو از یک دیتابیس جستجو به یک پلتفرم کامل observability تبدیل میکنه، که این یکی از دلایل اصلیه که با وجود سنگین بودنش، توی محیطهای enterprise همچنان انتخاب اول میمونه.
جمعبندی
Elasticsearch ابزار درستیه وقتی هم جستجوی متنی پیچیده و هم آنالیز حجم بالای داده رو همزمان نیاز داری. ولی اگه فقط دنبال یک جستجوی سریع و typo-tolerant برای سایت یا اپلیکیشنت هستی، قبل از اینکه وقت بذاری برای راهاندازی یک کلاستر Elasticsearch، حتماً Meilisearch یا Typesense رو هم امتحان کن — احتمالاً همون کاری که میخوای رو با یکدهم پیچیدگی انجام میدن.
توی replication همزمان (synchronous)، primary صبر میکنه تا حداقل یک replica تغییر رو دریافت و تأیید کنه، بعد به کلاینت میگه عملیات موفق بوده. این تضمین میده که هیچوقت دادهای که کلاینت فکر میکنه ذخیره شده، گم نشه — حتی اگه دقیقاً یک لحظه بعد primary از کار بیفته. هزینهاش اینجاست که هر نوشتن باید منتظر شبکه و replica هم بمونه، پس تأخیر (latency) بالاتر میره.
توی replication ناهمزمان (asynchronous)، primary بلافاصله بعد از نوشتن محلی به کلاینت جواب موفق میده، و تغییر رو در پسزمینه به replica ها میفرسته. سریعتره، ولی یک ریسک واقعی داره: اگه primary دقیقاً بین «جوابدادن به کلاینت» و «رسوندن تغییر به replica» از کار بیفته، اون تغییر ممکنه هیچوقت به replica نرسه و گم بشه. این حالت رو replication lag میگن — فاصلهی زمانی بین اتفاقافتادن یک تغییر روی primary و رسیدنش به replica.
اکثر سیستمهای production، بهخاطر تعادل بین سرعت و امنیت داده، از async استفاده میکنن، و ریسکش رو با مانیتورینگ لگ ریپلیکیشن و طراحی درست مدیریت میکنن، نه اینکه کامل حذفش کنن.
مشکلی که replication lag واقعاً ایجاد میکنه
فرض کن یک کاربر همین الان یک پست جدید توی اپلیکیشنت ثبت کرده. درخواست نوشتن روی primary انجام شده و جواب موفق برگشته. حالا همون کاربر بلافاصله صفحه رو رفرش میکنه، و این دفعه درخواست خواندن به یک replica هدایت میشه که هنوز اون تغییر رو دریافت نکرده. نتیجه؟ کاربر پست خودش رو نمیبینه و فکر میکنه ثبت نشده. این پدیده رو read-after-write inconsistency میگن و یکی از رایجترین سردرگمیهایییه که موقع استفاده از read replica ها پیش میاد.
راهحل رایجش اینه که برای عملیاتهای حساس به این مشکل (مثل نمایش بلافاصلهی دادهای که کاربر خودش همین الان ثبت کرده)، خواندن رو موقتاً از primary انجام بدی، نه از replica؛ یا اینکه یک مکانیزم «sticky session» بذاری که هر کاربر برای مدتی بعد از نوشتن، به همون primary وصل بمونه.
failover: چه کسی primary جدید میشه
وقتی primary از کار میافته، سیستم باید تصمیم بگیره کدوم replica جای اون رو بگیره. این کار میتونه دستی باشه (یک مهندس وارد میشه و خودش replica رو ترفیع میده) یا خودکار، با ابزارهایی مثل Patroni برای PostgreSQL یا Orchestrator برای MySQL (رپو اصلی دیگه مینتین نمیشه من جدید رو هم لینک میکنم) که وضعیت سلامت primary رو مانیتور میکنن و در صورت خرابی، خودشون یکی از replica ها رو (معمولاً همونی که کمترین لگ رو داره) به primary جدید ترفیع میدن.
نکتهای که اینجا باید بهش دقت کرد: اگه دو replica همزمان فکر کنن primary هستن (که بهش پدیدهی split-brain میگن)، ممکنه هر دو بهطور مستقل نوشتن قبول کنن و داده از هم واگرا بشه. سیستمهای failover خوب معمولاً یک مکانیزم consensus (مثل الگوریتم Raft) دارن که تضمین میکنه در هر لحظه فقط یک primary واقعی وجود داره.
multi-master: وقتی هر جا میتونه بنویسه
توی مدل primary-replica معمولی، فقط primary اجازهی نوشتن داره. یک مدل جایگزین multi-master (یا multi-leader) است، جایی که چند سرور همزمان اجازهی نوشتن دارن و تغییراتشون رو با هم sync میکنن. این برای سیستمهای توزیعشدهی جغرافیایی جذابه — مثلاً یک سرور توی اروپا و یکی توی آسیا، هرکدوم بدون نیاز به رفتوبرگشت روی اقیانوس، مستقیم نوشتن رو قبول کنن. ولی هزینهی این مدل، مواجههست با تعارض (conflict): اگه دو کاربر همزمان روی دو سرور مختلف یک ردیف رو ویرایش کنن، سیستم باید تصمیم بگیره کدوم نسخه برندهست، که معمولاً با استراتژیهایی مثل «آخرین نوشتن برندهست» یا ساختارهای دادهی خاص به اسم CRDT حل میشه.
جمعبندی
ریپلیکیشن معاملهی همیشگی سیستمهای توزیعشده رو دوباره جلوی چشمت میذاره: بین سرعت، سازگاری، و دسترسپذیری باید انتخاب کنی، چون هر سهتاش رو همزمان و کامل نمیشه داشت. برای اکثر اپلیکیشنها، یک primary با چند async replica برای read scaling و disaster recovery کافیه. فقط وقتی واقعاً نیاز به نوشتن همزمان از چند نقطهی جغرافیایی داری، ارزششو داره که پیچیدگی multi-master رو به جون بخری.
نکتهای که نباید نادیده گرفت
با همهی این هیجان، این ابزار فعلاً پشت یک پولیوار جدیه: فقط مشترکین SuperGrok Heavy بهش دسترسی دارن، که ردهی بالای اشتراک Grok محسوب میشه. یعنی برخلاف تصوری که ممکنه از عبارت «بدون کدنویسی» به ذهن برسه، هنوز یک مانع (البته اینبار مالی، نه فنی) سر راهه. همچنین چون این قابلیت هنوز در فاز early beta است، طبیعیه که محدودیتها و باگهای اولیهای هم داشته باشه که با گذر زمان رفع میشن.
جمعبندی
Build Mode نشون میده مسیر ابزارهای هوش مصنوعی داره از «چتکردن دربارهی کد» بهسمت «تولید مستقیم محصول قابلاستفاده» حرکت میکنه. برای کسی که ایده داره ولی مهارت فنی نداره، این یعنی فاصلهی بین فکر و محصول واقعی کوتاهتر شده. ولی برای کسی که دنبال یک ابزار توسعهی جدی و قابل اتکاست، هنوز باید صبر کرد ببینه این نسخهی beta، وقتی از پشت پولیوار بیرون بیاد و در دسترس عموم قرار بگیره، چقدر توی سناریوهای واقعی و پیچیدهتر جواب میده.
سومی directory-based sharding است، جایی که یک جدول جدا (یا سرویس جدا) نگه میداری که میگه هر کلید دقیقاً کدوم شارده. انعطاف بیشتری میده — میتونی هر موقع خواستی داده رو جابهجا کنی بدون اینکه فرمول هش عوض بشه — ولی خودش یک نقطهی اضافهست که باید مدیریتش کنی و مراقب باشی bottleneck نشه.
چیزی که واقعاً سخته: query هایی که چند شارد رو لمس میکنن
توی یک دیتابیس تکسروری، یک JOIN بین دو جدول یا یک عملیات تراکنشی روی چند ردیف، کار همیشگی و بیدردسریه. توی یک سیستم شارد شده، این همون کاریه که واقعاً سخت میشه. اگه دو ردیفی که میخوای join کنی روی دو شارد مختلف باشن، دیگه نمیتونی از یک JOIN سادهی SQL استفاده کنی؛ باید یا داده رو توی اپلیکیشن خودت از دو شارد بخونی و دستی join کنی، یا از یک لایهی query routing استفاده کنی که این کار رو برات مخفی کنه.
همین مسئله برای تراکنشها هم صدق میکنه. یک تراکنش که باید همزمان روی دو ردیف از دو شارد مختلف atomic عمل کنه (یا هر دو موفق بشن یا هیچکدوم)، به یک پروتکل به اسم two-phase commit یا الگوهای پیچیدهتری مثل Saga نیاز داره. این دقیقاً همون چیزیه که شاردینگ رو از یک تصمیم سادهی زیرساختی به یک تصمیم معماری تبدیل میکنه؛ وقتی شارد میکنی، عملاً داری از دنیای تراکنشهای سادهی ACID فاصله میگیری، مگر اینکه خیلی هوشمندانه shard key رو طوری انتخاب کنی که دادههای مرتبط همیشه کنار هم بمونن.
re-sharding: کابوس واقعی
فرض کن با hash-based sharding شروع کردی و چهار شارد داری. حالا نیاز داری شاردهای بیشتری اضافه کنی. مشکل اینجاست که اگه فرمول هشت چیزی ساده مثل hash(key) % 4 باشه، وقتی این عدد رو به ۵ تغییر بدی، تقریباً تمام mapping ها بههم میریزه — چون باقیماندهی تقسیم برای اکثر کلیدها عوض میشه. یعنی باید تقریباً کل داده رو جابهجا کنی، درست همون چیزی که موقع طراحی سیستم میخواستی ازش فرار کنی.
راهحل رایج برای این مشکل consistent hashing است — همون تکنیکی که توی مقالهی لود بالانسینگ دربارهی Maglev گوگل ازش گفتیم. با consistent hashing، اضافهکردن یک شارد جدید فقط باعث میشه بخش کوچیکی از داده جابهجا بشه، نه همهچیز. برای همین سیستمهای بزرگمقیاسی مثل Cassandra و DynamoDB این تکنیک رو بهعنوان پایهی مکانیزم شاردینگشون انتخاب کردن.
مثالهای واقعی
Vitess، که اصلش رو یوتیوب برای مقیاسدادن MySQL ساخت (و بعداً Slack و GitHub هم ازش استفاده کردن)، دقیقاً یک لایهی میانی روی MySQL میذاره که شاردینگ رو تا حد زیادی از دید اپلیکیشن مخفی میکنه. Citus هم همین کار رو برای PostgreSQL انجام میده — جدولها رو بهصورت شفاف بین چند نود پخش میکنه و کوئریها رو بهصورت خودکار روت میکنه. MongoDB هم شاردینگ رو بهعنوان یک قابلیت داخلی و نه یک ابزار جانبی ارائه میده، که همین یکی از دلایلیه که خیلی از تیمها برای دادهی خیلی بزرگ سراغش میرن.
جمعبندی
شاردینگ آخرین ابزاریه که باید بهش فکر کنی، نه اولین. قبل از رسیدن به این مرحله معمولاً ایندکسگذاری بهتر، کش، و read replica ها میتونن مدت زیادی جوابگو باشن. شاردینگ رو وقتی به سراغش میری که واقعاً داده یا نرخ نوشتن از ظرفیت یک ماشین رد شده، چون همراهش پیچیدگیهای واقعی میاد: query های چندشارده سخت میشن، تراکنشها پیچیده میشن، و re-sharding میتونه یک پروژهی چندهفتهای بشه اگه از اول درست طراحی نشده باشه.
یک تمایز مهم که خیلی وقتها گیجکنندهست، فرق ایندکس clustered و non-clustered است. توی ایندکس clustered، ترتیب فیزیکی داده روی دیسک دقیقاً همون ترتیب ایندکسه — یعنی خود جدول، به شکل ایندکس مرتب شده. هر جدول فقط میتونه یک ایندکس clustered داشته باشه، چون داده فقط یک ترتیب فیزیکی روی دیسک میتونه داشته باشه. توی MySQL با InnoDB، این معمولاً همون primary key است.
ایندکس non-clustered یک ساختار جداست که فقط اشارهگر به ردیف اصلی نگه میداره، نه خود داده رو. میتونی تعداد دلخواهی از این نوع ایندکس روی یک جدول داشته باشی. تفاوتش توی عمل اینه که خوندن از ایندکس clustered یک مرحله کمتر داره (چون داده همونجاست)، ولی non-clustered برای ستونهای غیر primary key انعطاف بیشتری میده.
ایندکس ترکیبی و ترتیب ستونها
وقتی کوئریهات معمولاً چند شرط با هم دارن — مثلاً WHERE user_id = ? AND status = 'active' — میتونی یک composite index روی هر دو ستون بسازی. نکتهی مهمی که خیلی از دولوپرها نادیده میگیرن اینه که ترتیب ستونها توی ایندکس ترکیبی مهمه. یک ایندکس روی (user_id, status) برای کوئریهایی که با user_id فیلتر میکنن (با یا بدون status) مفیده، ولی برای کوئریهایی که فقط روی status فیلتر میکنن و اصلاً کاری با user_id ندارن، عملاً بیفایدهست — چون درست مثل فهرست کتابیه که بر اساس فصل مرتب شده، نه بر اساس موضوع؛ اگه فصل رو ندونی، فهرست کمکت نمیکنه.
CREATE INDEX idx_user_status ON orders (user_id, status);

-- این کوئری از ایندکس بالا خوب استفاده میکنه
SELECT * FROM orders WHERE user_id = 42 AND status = 'active';

-- این یکی عملاً از این ایندکس استفاده نمیکنه
SELECT * FROM orders WHERE status = 'active';
چطور بفهمیم دیتابیس واقعاً از ایندکس استفاده میکنه
خیلی وقتها فرض میکنیم چون ایندکس ساختیم، کوئری هم ازش استفاده میکنه، درحالیکه همیشه اینطور نیست. ابزار اصلی برای فهمیدن این موضوع دستور EXPLAIN (یا EXPLAIN ANALYZE توی PostgreSQL) است که نشون میده دیتابیس دقیقاً چه plan ای برای اجرای کوئری انتخاب کرده — آیا از ایندکس استفاده کرده یا رفته سراغ full table scan.
EXPLAIN ANALYZE
SELECT * FROM orders WHERE user_id = 42;
اگه توی خروجی این دستور عبارتی مثل Seq Scan ببینی بهجای Index Scan، یعنی دیتابیس تصمیم گرفته ایندکس رو نادیده بگیره — که میتونه چند دلیل داشته باشه: شاید جدول اونقدر کوچیکه که دیتابیس تشخیص داده full scan سریعتره، شاید آمار (statistics) دیتابیس قدیمی شده، یا شاید شرط کوئری طوری نوشته شده که ایندکس اصلاً قابل استفاده نیست (مثلاً استفاده از تابع روی ستون ایندکسشده، مثل WHERE LOWER(email) = ...).
وقتی ایندکس ضرر میزنه
جالبه که بدونی ایندکس همیشه سریعتر نیست. روی جدولهای خیلی کوچیک، یا وقتی یک شرط WHERE درصد بزرگی از جدول رو برمیگردونه (مثلاً بیش از ۲۰-۳۰ درصد ردیفها)، دیتابیس معمولاً ترجیح میده مستقیم برگرده به full scan، چون رفتن سراغ ایندکس و بعد پرش بین ردیفهای پراکنده روی دیسک، از یک خوندن پیوسته و ساده کندتره. این یکی از نکاتییه که خیلی از مهندسهای تازهکار تعجب میکنن وقتی برای اولین بار میبینن دیتابیس با وجود ایندکس، ازش استفاده نکرده — درحالیکه این تصمیم دیتابیس اتفاقاً درسته، نه باگ.
جمعبندی
ایندکس یک معاملهست، نه یک ترفند رایگان: سرعت خوندن رو در ازای سرعت نوشتن و فضای اضافی میخری. تصمیم درست این نیست که «همهچیز رو ایندکس کن»، بلکه اینه که بفهمی کدوم کوئریها واقعاً توی سیستم پرتکرارن، دقیقاً چه ستونهایی رو فیلتر یا مرتب میکنن، و بر همون اساس ایندکس بسازی — و بعد با EXPLAIN چک کنی که فرضت درست بوده.